Qué modelo cabe
Qué equipo ejecuta cada modelo
La memoria decide qué modelos caben. Elija un tamaño de modelo y una calidad, y vea todos los equipos y tarjetas que vendemos capaces de cargarlo.
30–34B a 4 bits
Unos 20 GB de memoria de GPU
El punto óptimo para mucha gente: respuestas notablemente más inteligentes y aún basta una sola tarjeta de 24–32 GB a 4 bits.
Ejemplos: Gemma 2 27B, Qwen2.5 32B
13 de 21 equipos y tarjetas pueden ejecutarlo
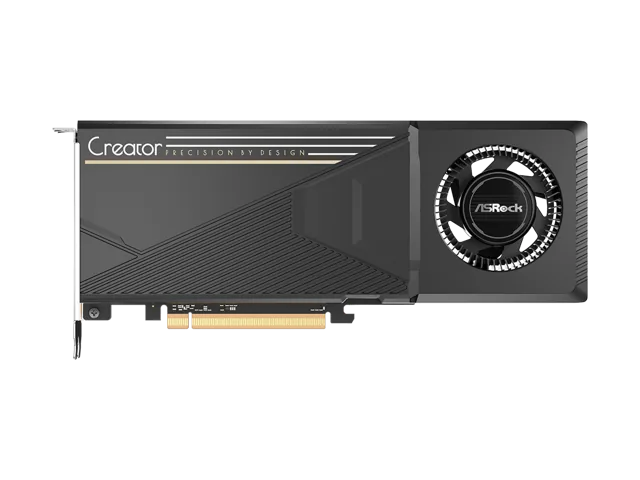 ASRock Intel Arc Pro B60 Creator 24GB24 GB599,99 €
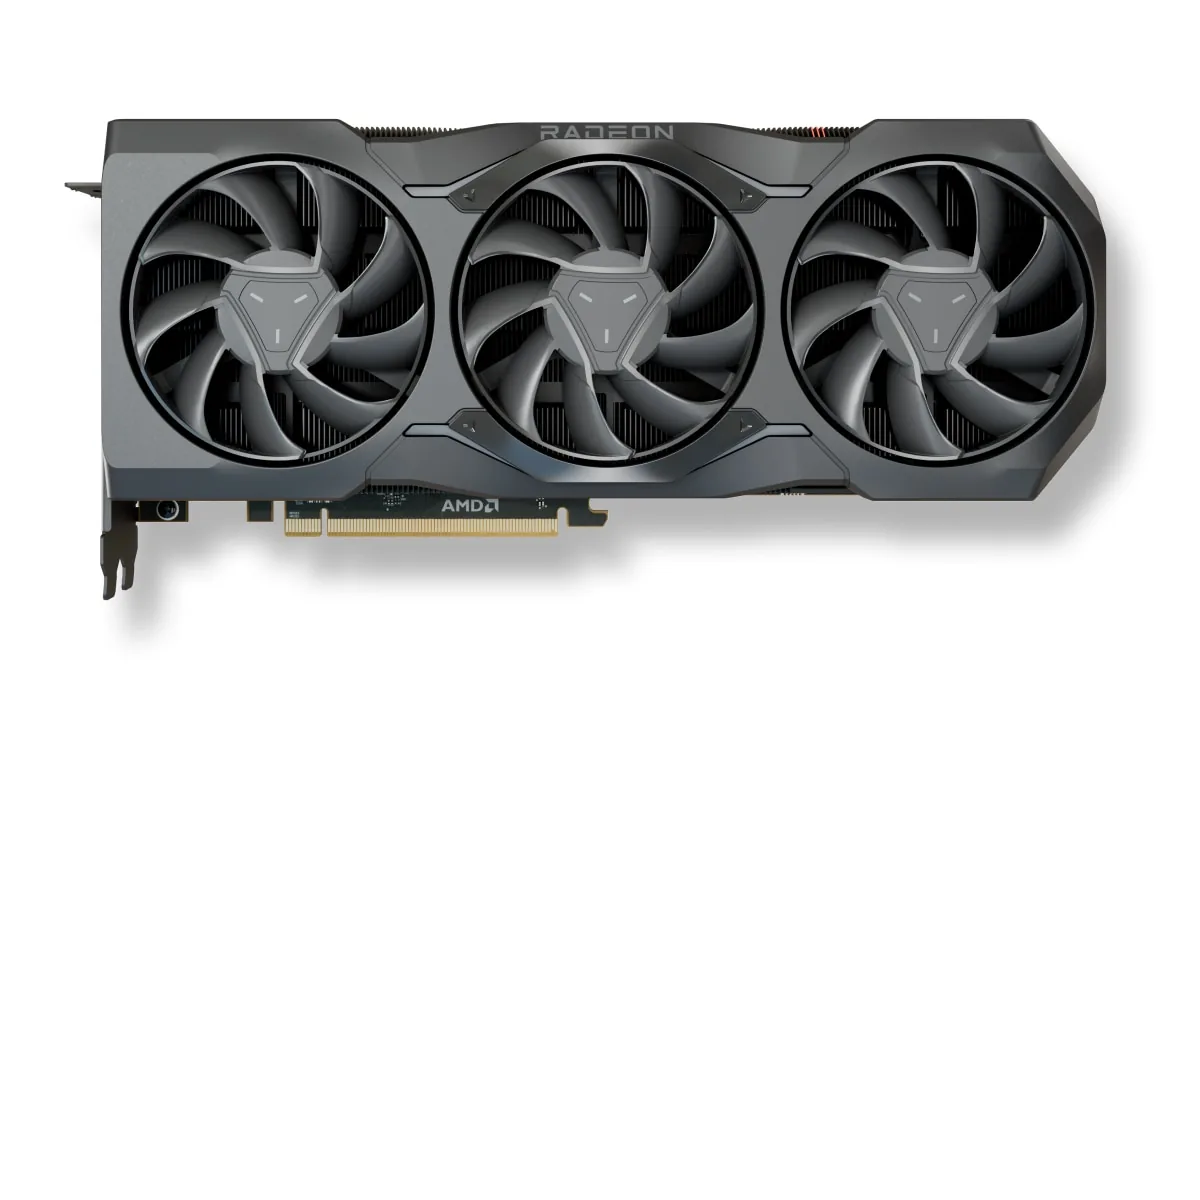 SAPPHIRE PULSE AMD Radeon RX 7900 XTX 24GB24 GB899 €
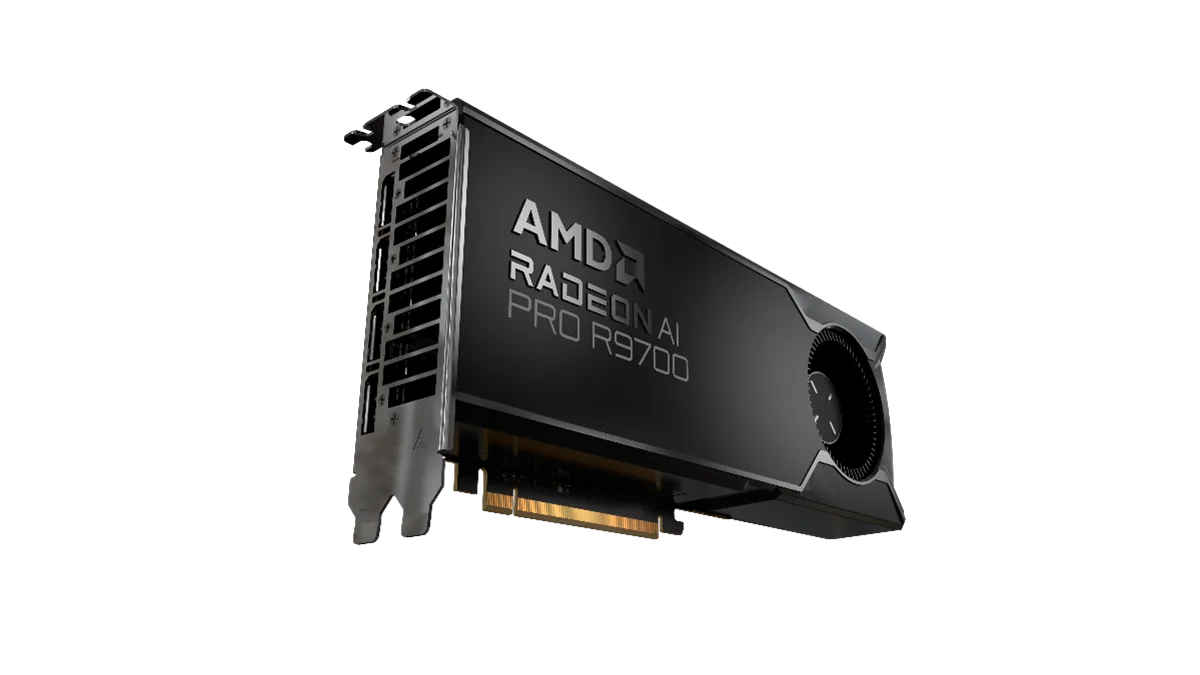 PowerColor AMD Radeon AI PRO R9700 32GB32 GB1299 €
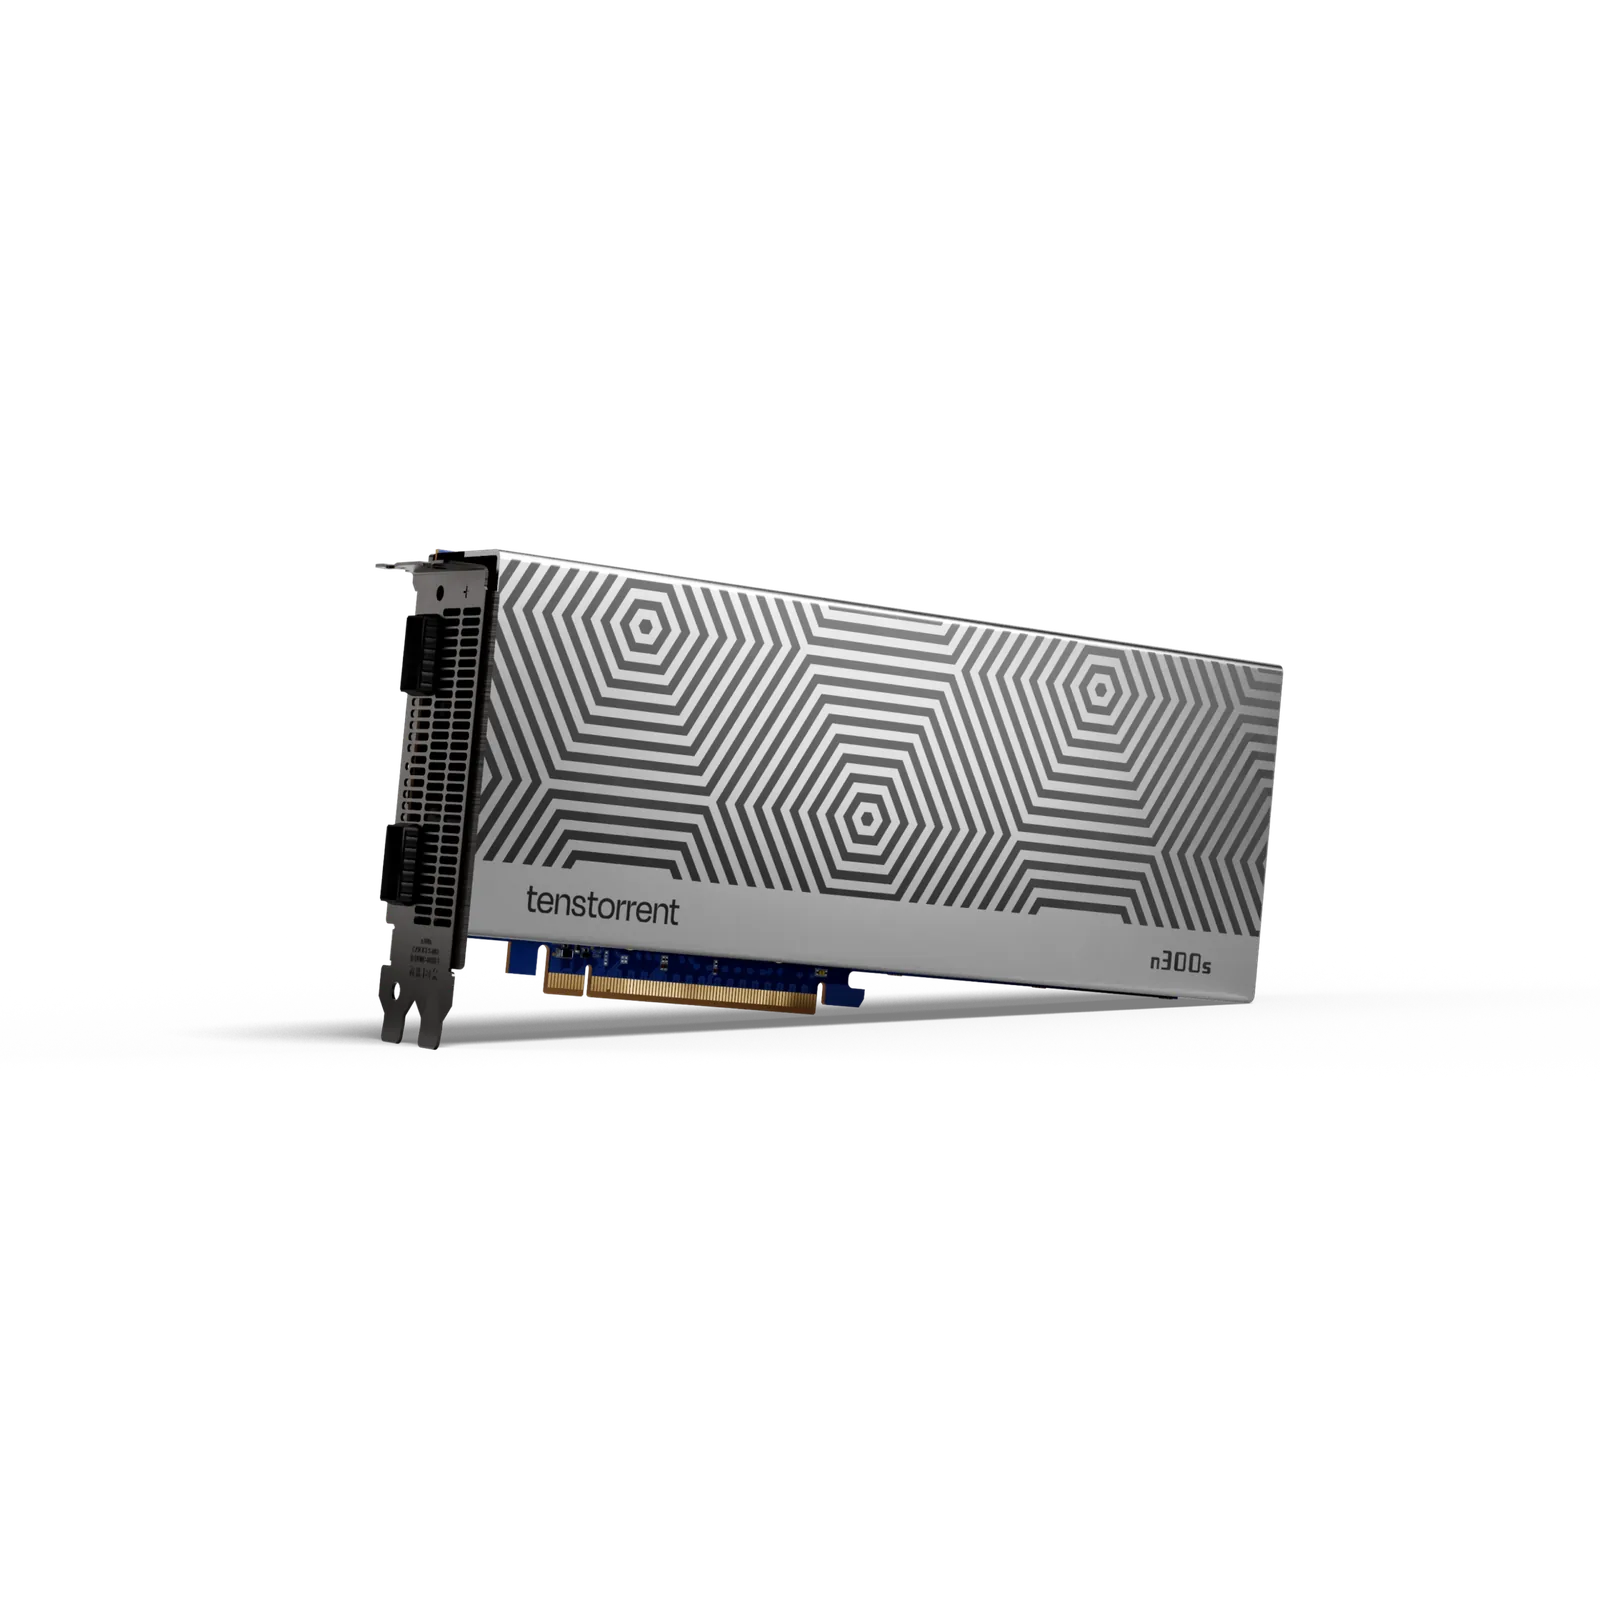 Tenstorrent Wormhole n300s24 GB1399 €
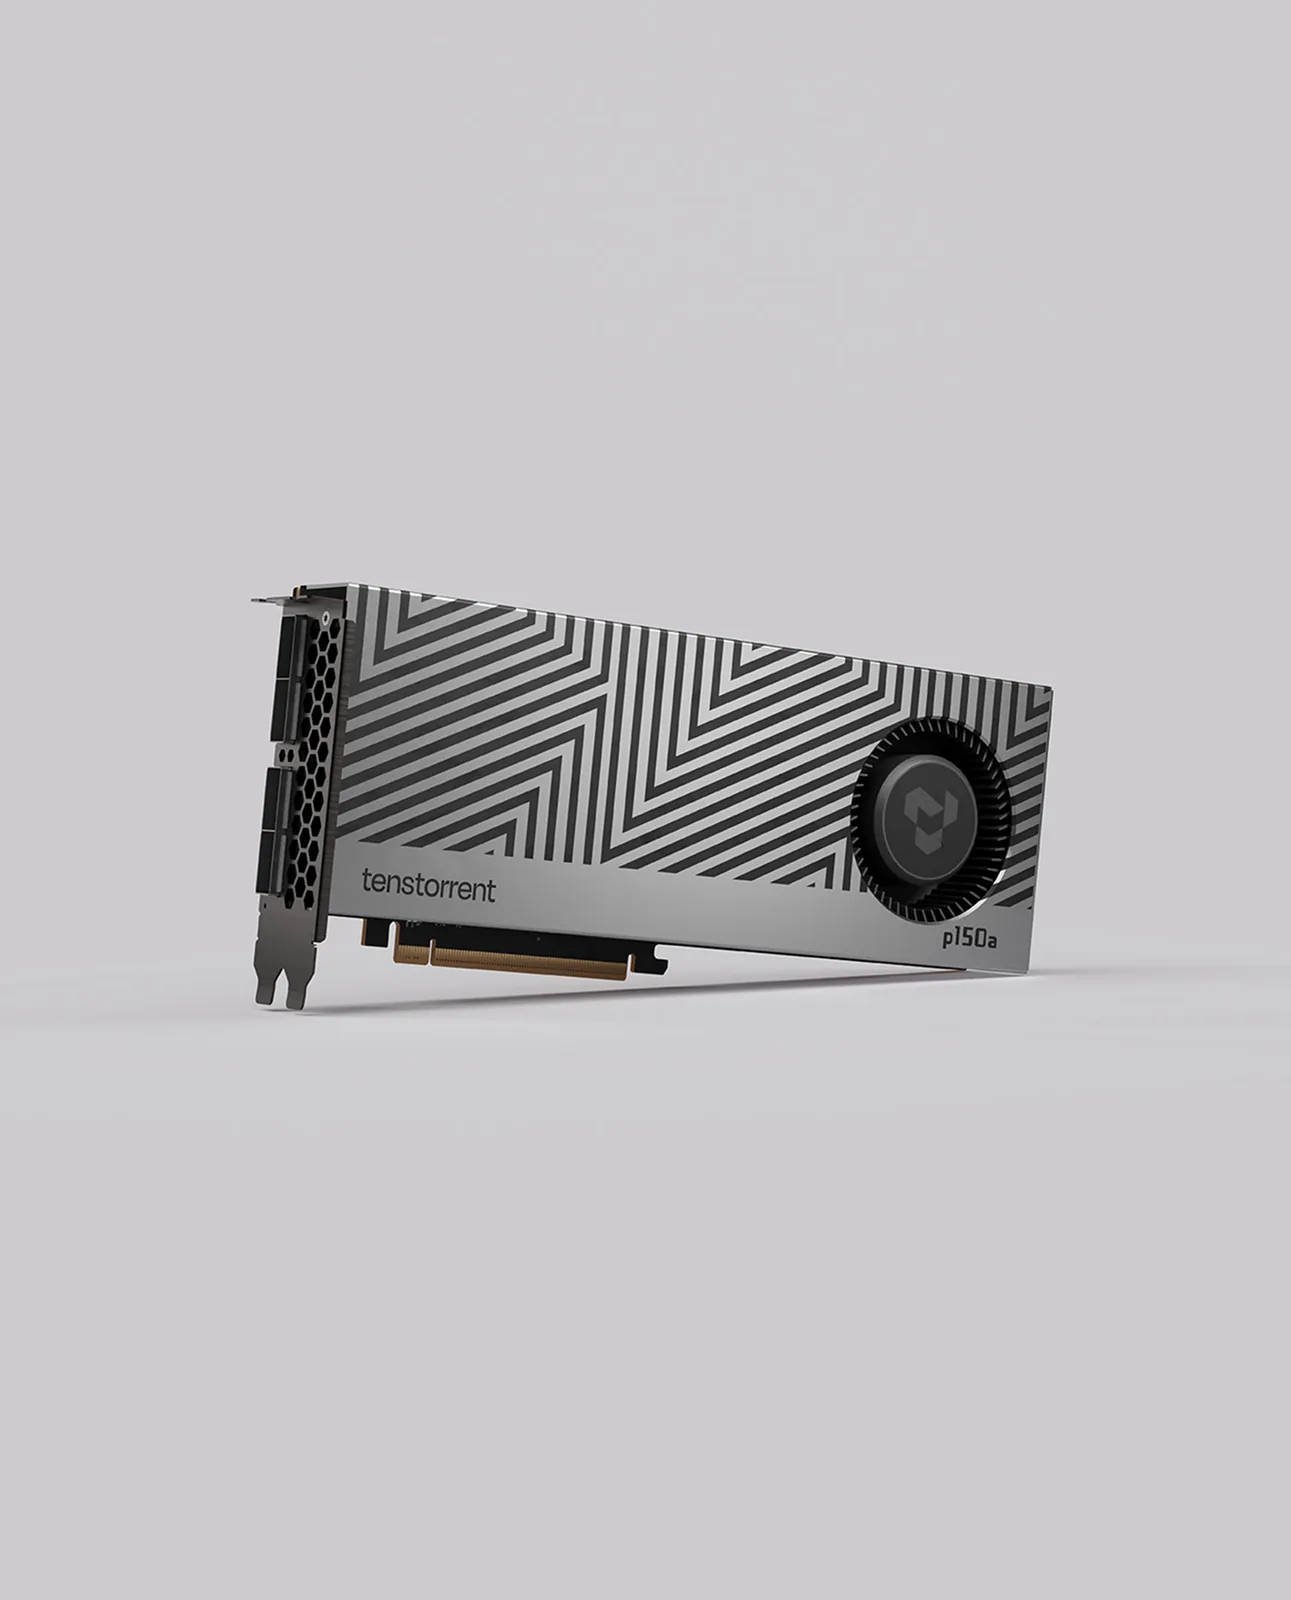 Tenstorrent Blackhole p150a32 GB1399 €
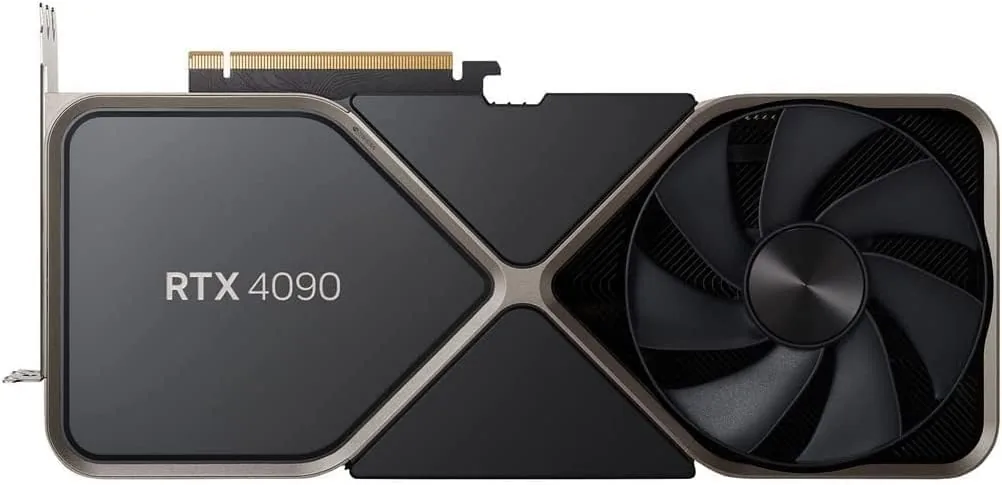 NVIDIA GeForce RTX 409024 GB1599 €
 NVIDIA GeForce RTX 509032 GB1999 €
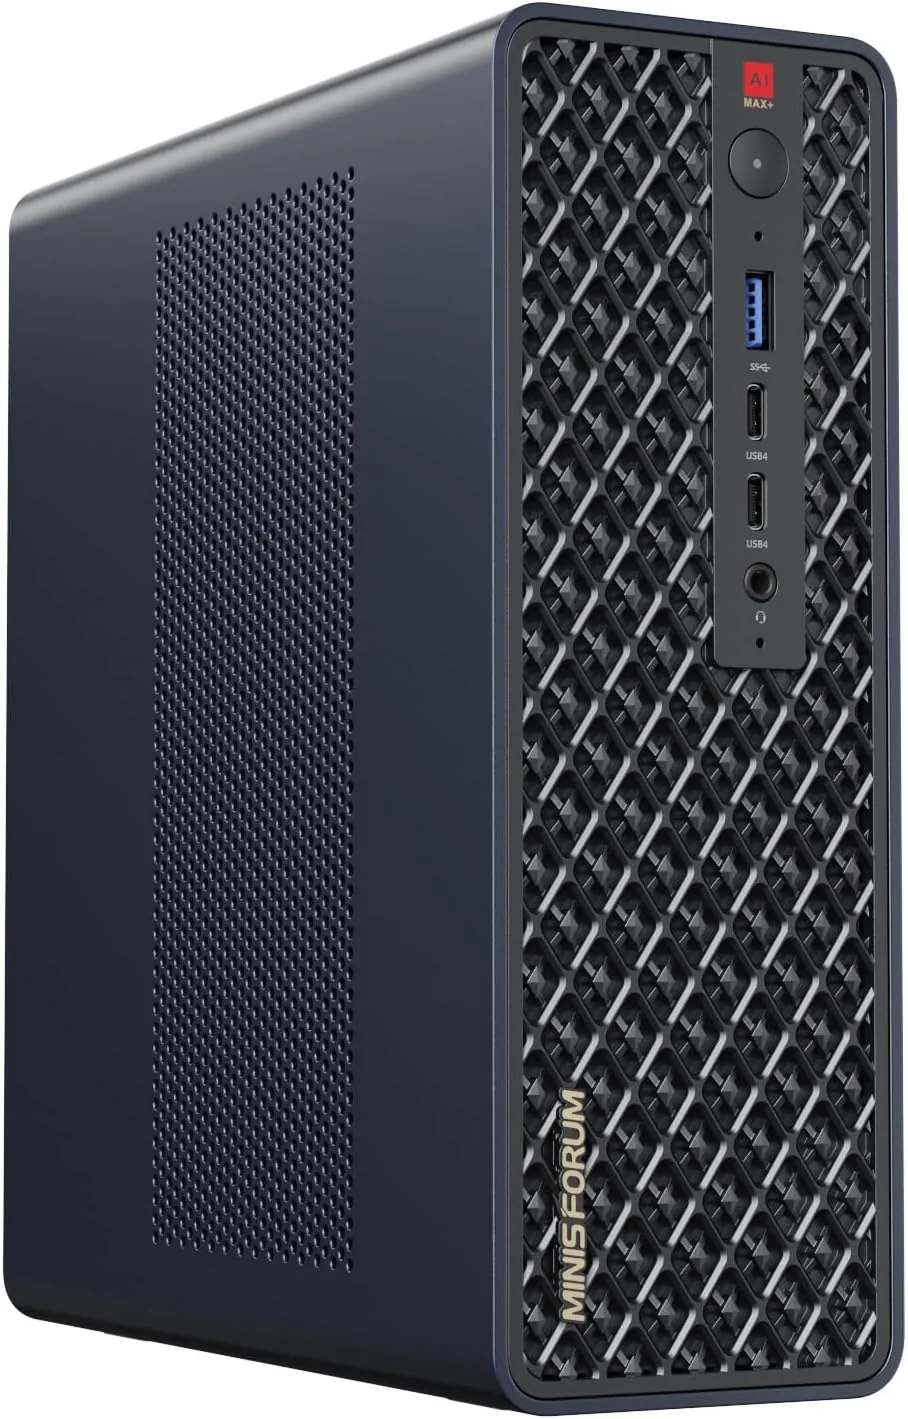 Minisforum MS-S1 Max128 GB unificados2469 €
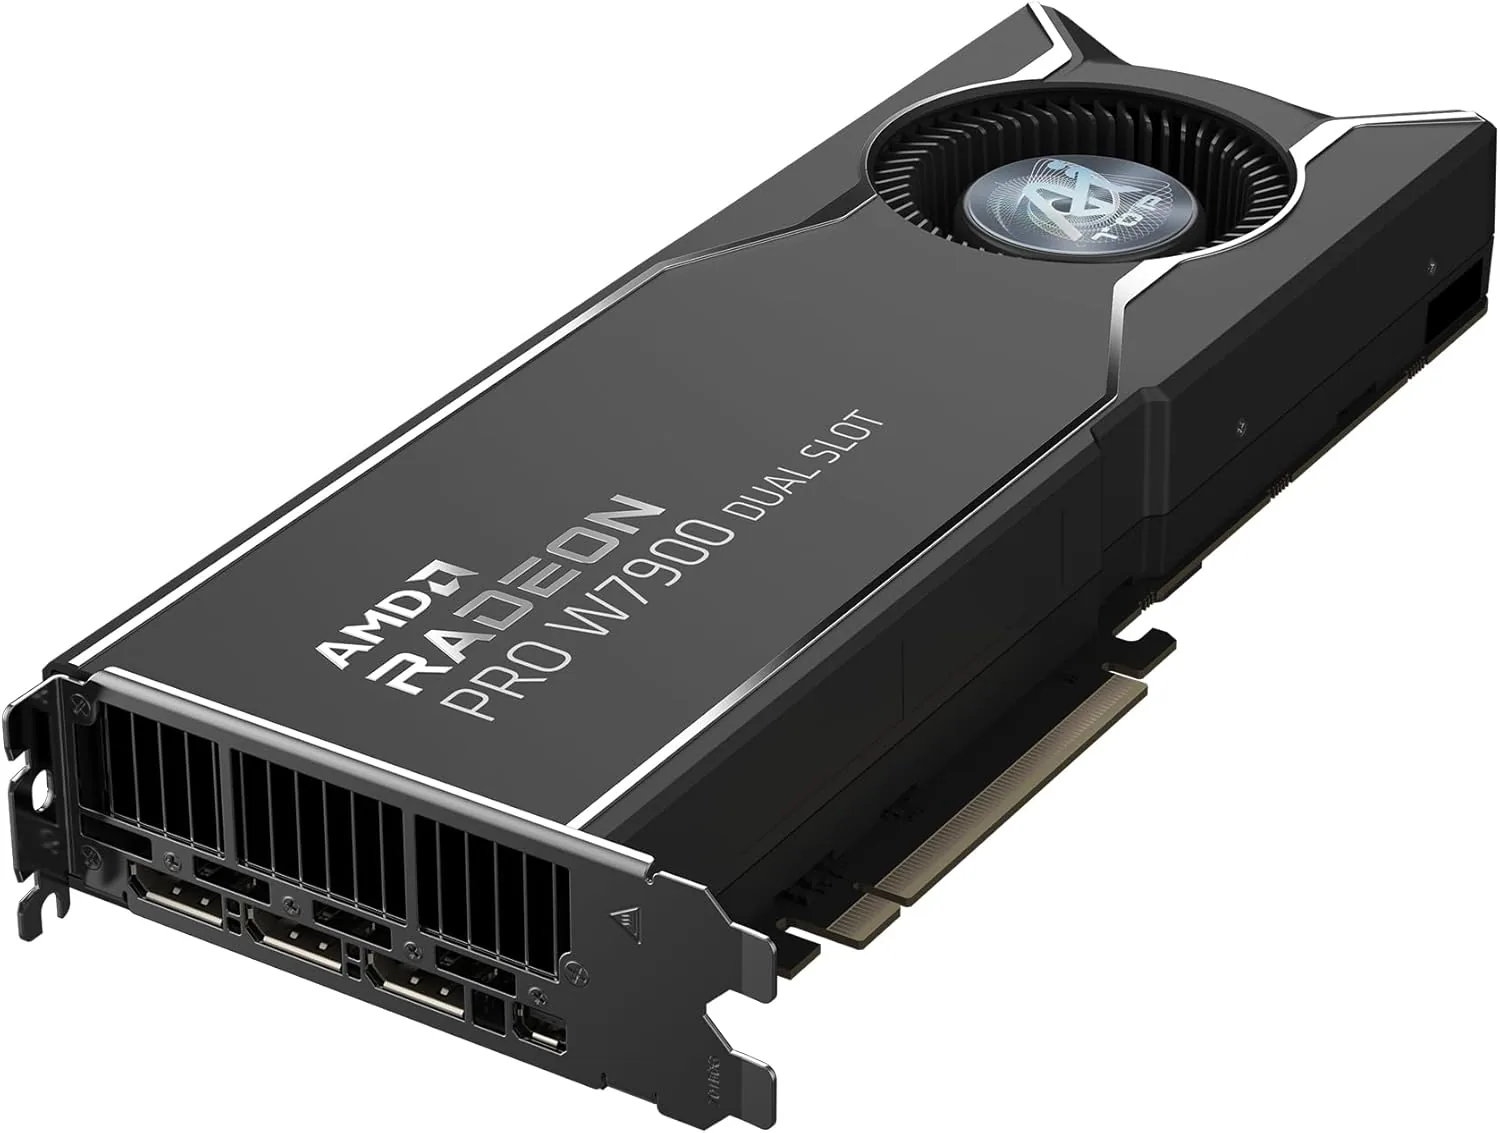 AMD Radeon PRO W7900 (48 GB)48 GB3592 €
 Apple Mac Studio (M3 Ultra)96 GB unificados3999 €
 Beelink GTR9 Pro128 GB unificados4349 €
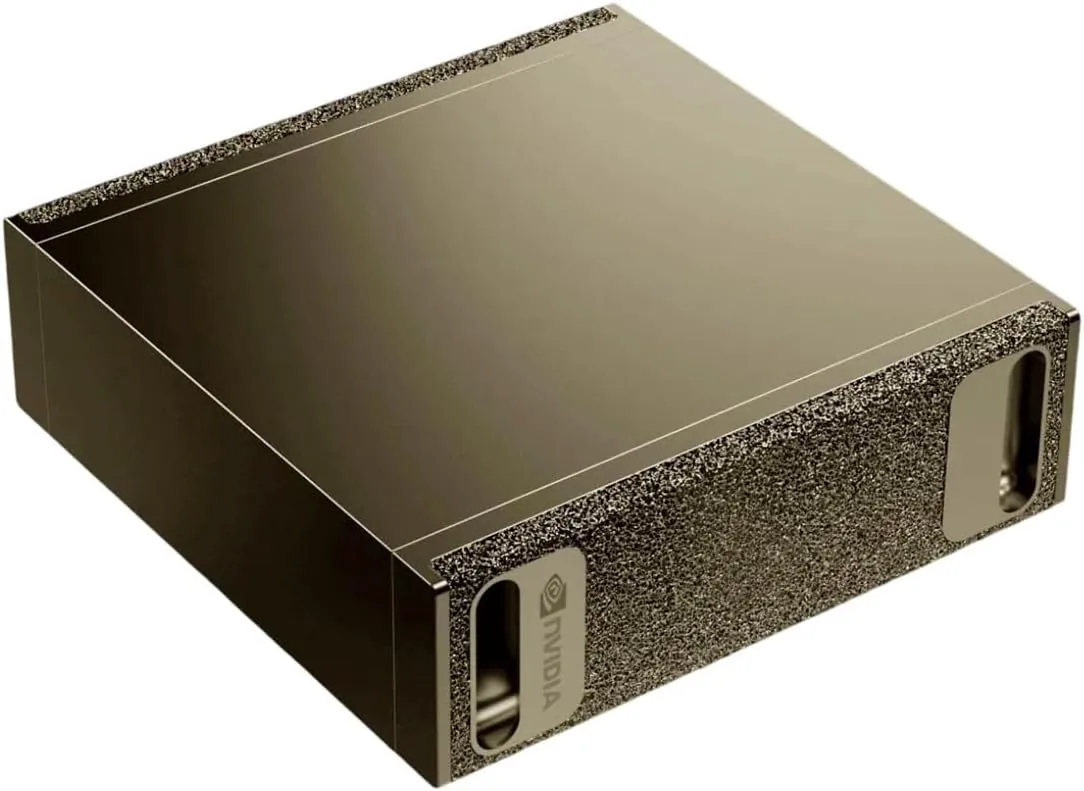 NVIDIA DGX Spark128 GB unificados4699 €
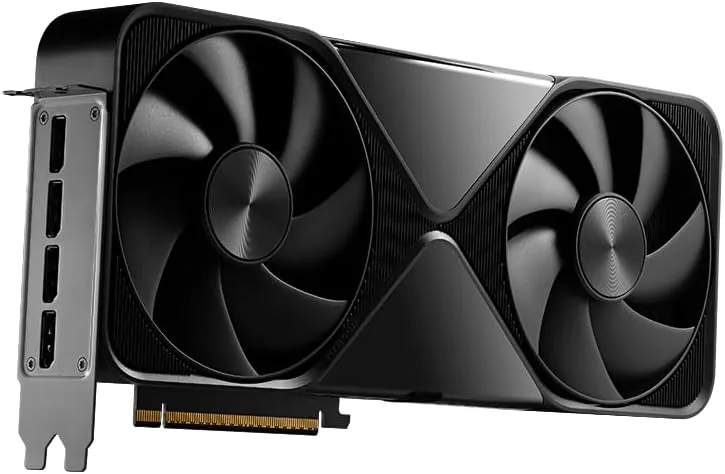 NVIDIA RTX PRO 6000 Blackwell Workstation Edition (96 GB)96 GB13.250 €
Todas las cifras son aproximadas. Contamos aproximadamente (parámetros × bits ÷ 8) para los pesos más un 20–30 % para el contexto y los búferes, y consideramos utilizable el 90 % de la memoria de una tarjeta gráfica y el 75 % de la de un sistema con memoria unificada. Los contextos largos, los modelos de imagen y el procesamiento por lotes necesitan más. Cada tarjeta se cuenta por separado; se pueden combinar varias en un mismo equipo.
¿Duda cuál elegir?
Indique al asistente qué quiere ejecutar y su presupuesto.