Categoría
Tarjetas aceleradoras de IA y sobremesas para crear modelos
Tarjetas aceleradoras de IA y sobremesas diseñados ante todo para la IA: las tarjetas Tenstorrent con un stack de software de código abierto y el sobremesa NVIDIA DGX Spark.
Un acelerador de IA se elige primero por su software. El NVIDIA DGX Spark es un equipo de desarrollo CUDA de 128 GB cuyo código se traslada a sistemas DGX más grandes y a la nube; las tarjetas Tenstorrent funcionan con un software íntegramente de código abierto que se puede programar hasta el nivel de los kernels. Si lo que busca sobre todo es ejecutar modelos grandes con rapidez, más que crearlos, un Mac Studio o una tarjeta gráfica suelen ser mejor opción.
Nuestra selección
Desarrollo con CUDA y 128 GB
DGX Spark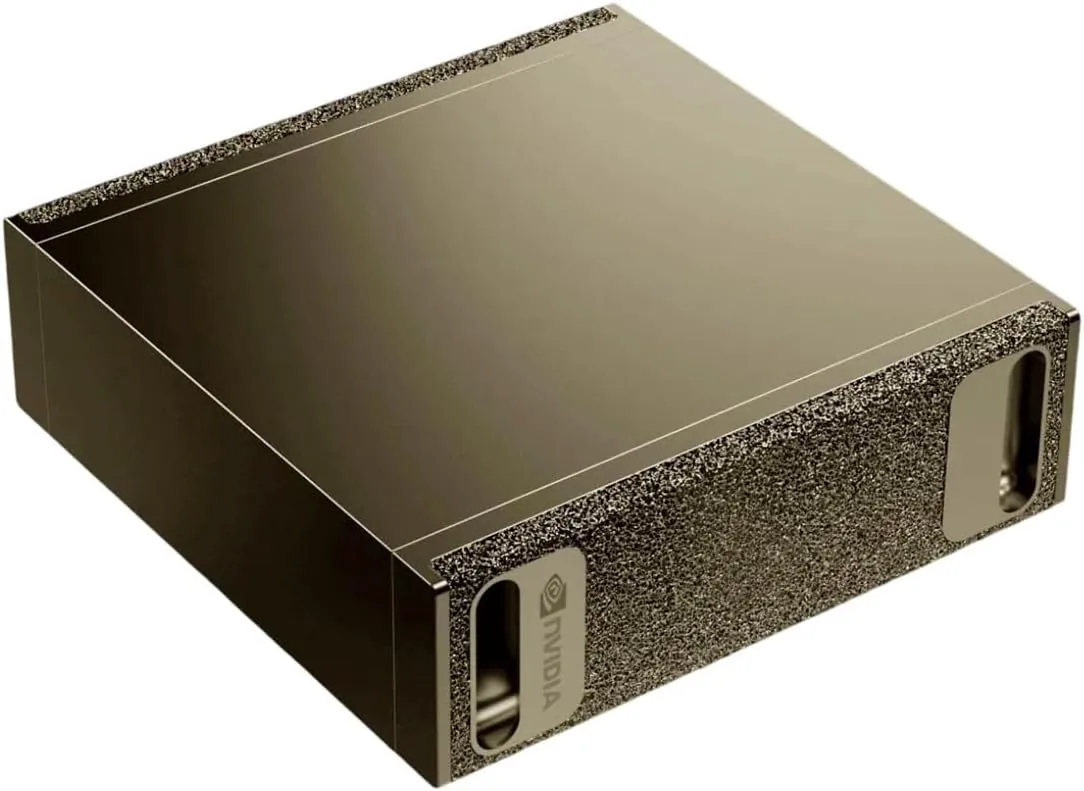
NVIDIA
NVIDIA DGX Spark
- 128 GB unificados
- NVIDIA GB10 Grace Blackwell
Ejecuta modelos de hasta 120B+ a 4 bits
Su ancho de banda de memoria (273 GB/s) es inferior al de una tarjeta gráfica de gama alta, así que los modelos densos grandes generan texto más despacio que en una RTX 5090. Sus puntos fuertes son la capacidad y el stack de software CUDA.
4699 €Un equipo de sobremesa de 150 mm de lado con el software de NVIDIA, para prototipar y hacer fine-tuning antes de pasar a equipos NVIDIA más grandes.
La tarjeta de software abierto con más memoria
Tenstorrent Blackhole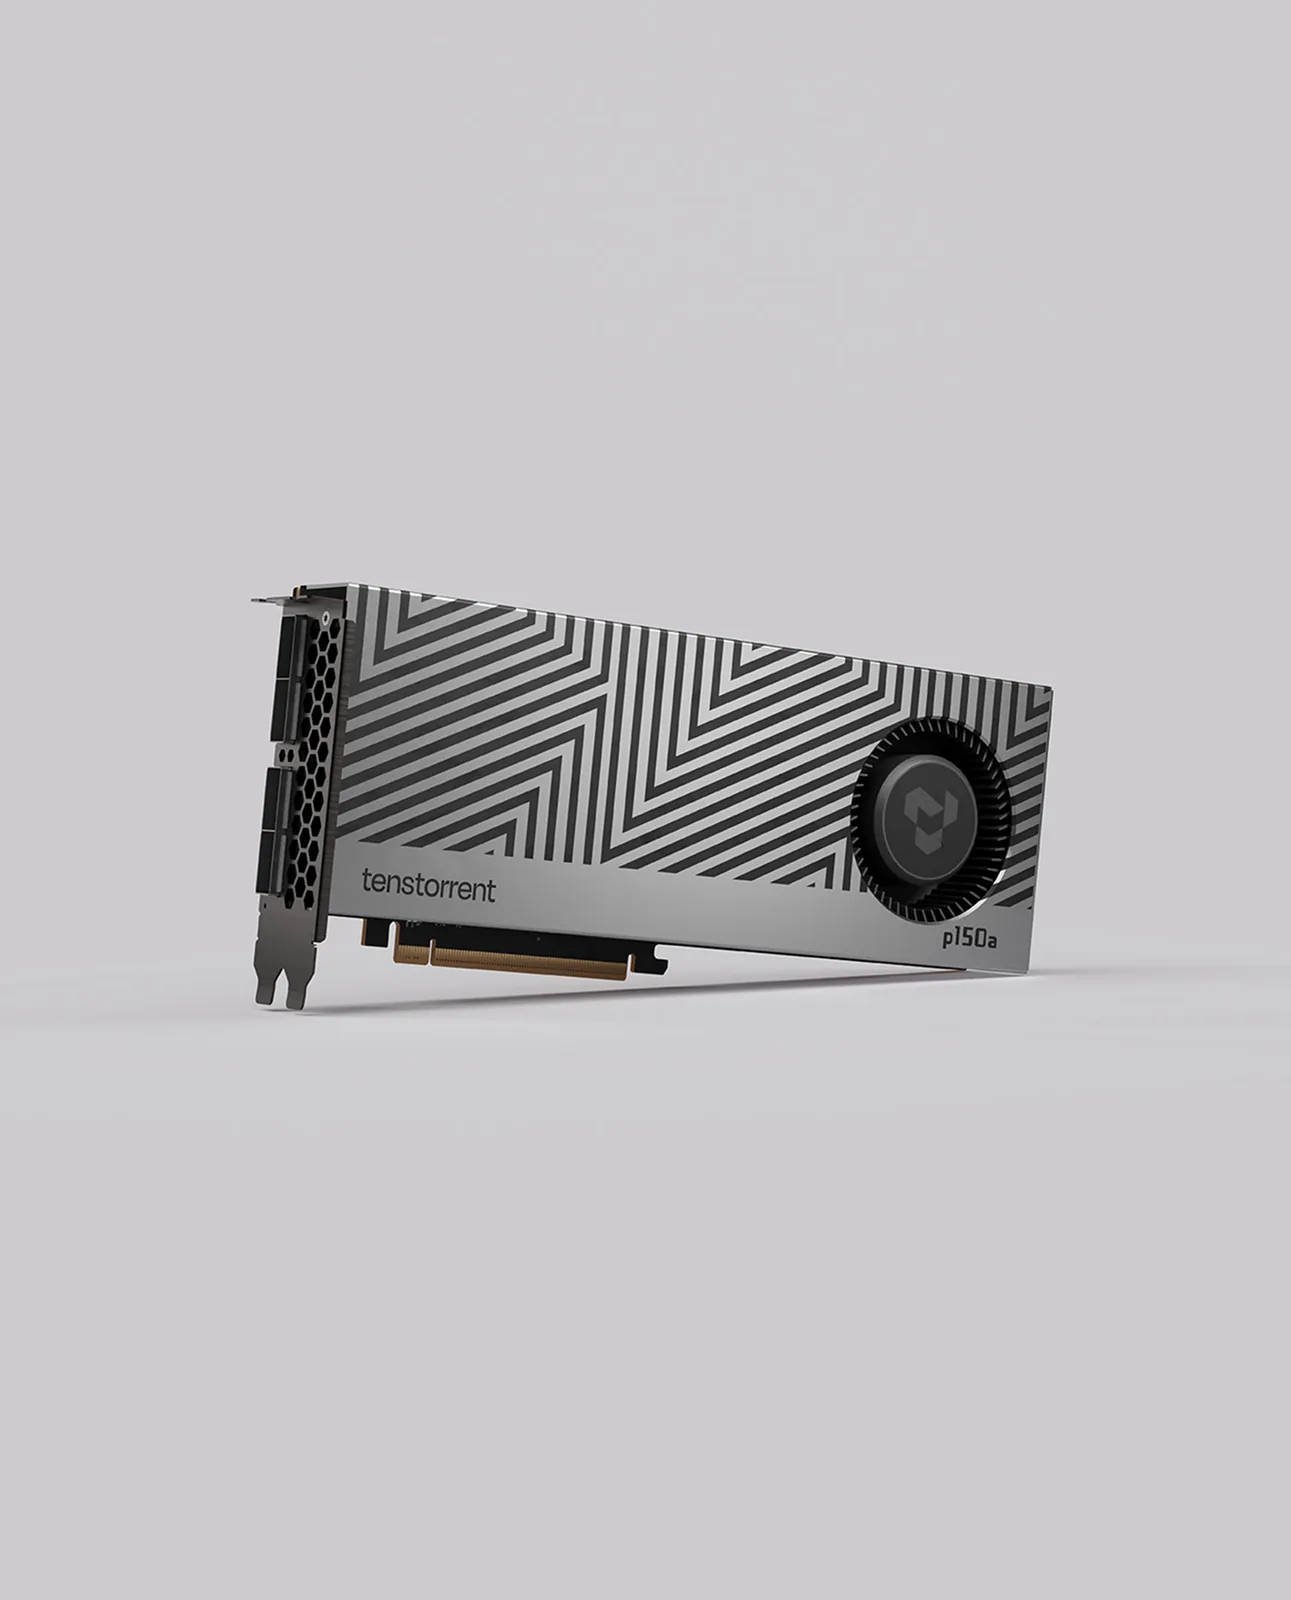
Tenstorrent
Tenstorrent Blackhole p150a
- 32 GB
- Tenstorrent Blackhole
Ejecuta modelos de hasta 30–34B a 4 bits
No es una tarjeta CUDA. Antes de comprarla, compruebe que los modelos que necesita son compatibles con la biblioteca de modelos de código abierto de Tenstorrent.
1399 €32 GB de GDDR6, 120 núcleos Tensix y cuatro puertos 800G para conectar tarjetas, con un software que se puede leer y modificar.
La puerta de entrada a Tenstorrent
Tenstorrent Wormhole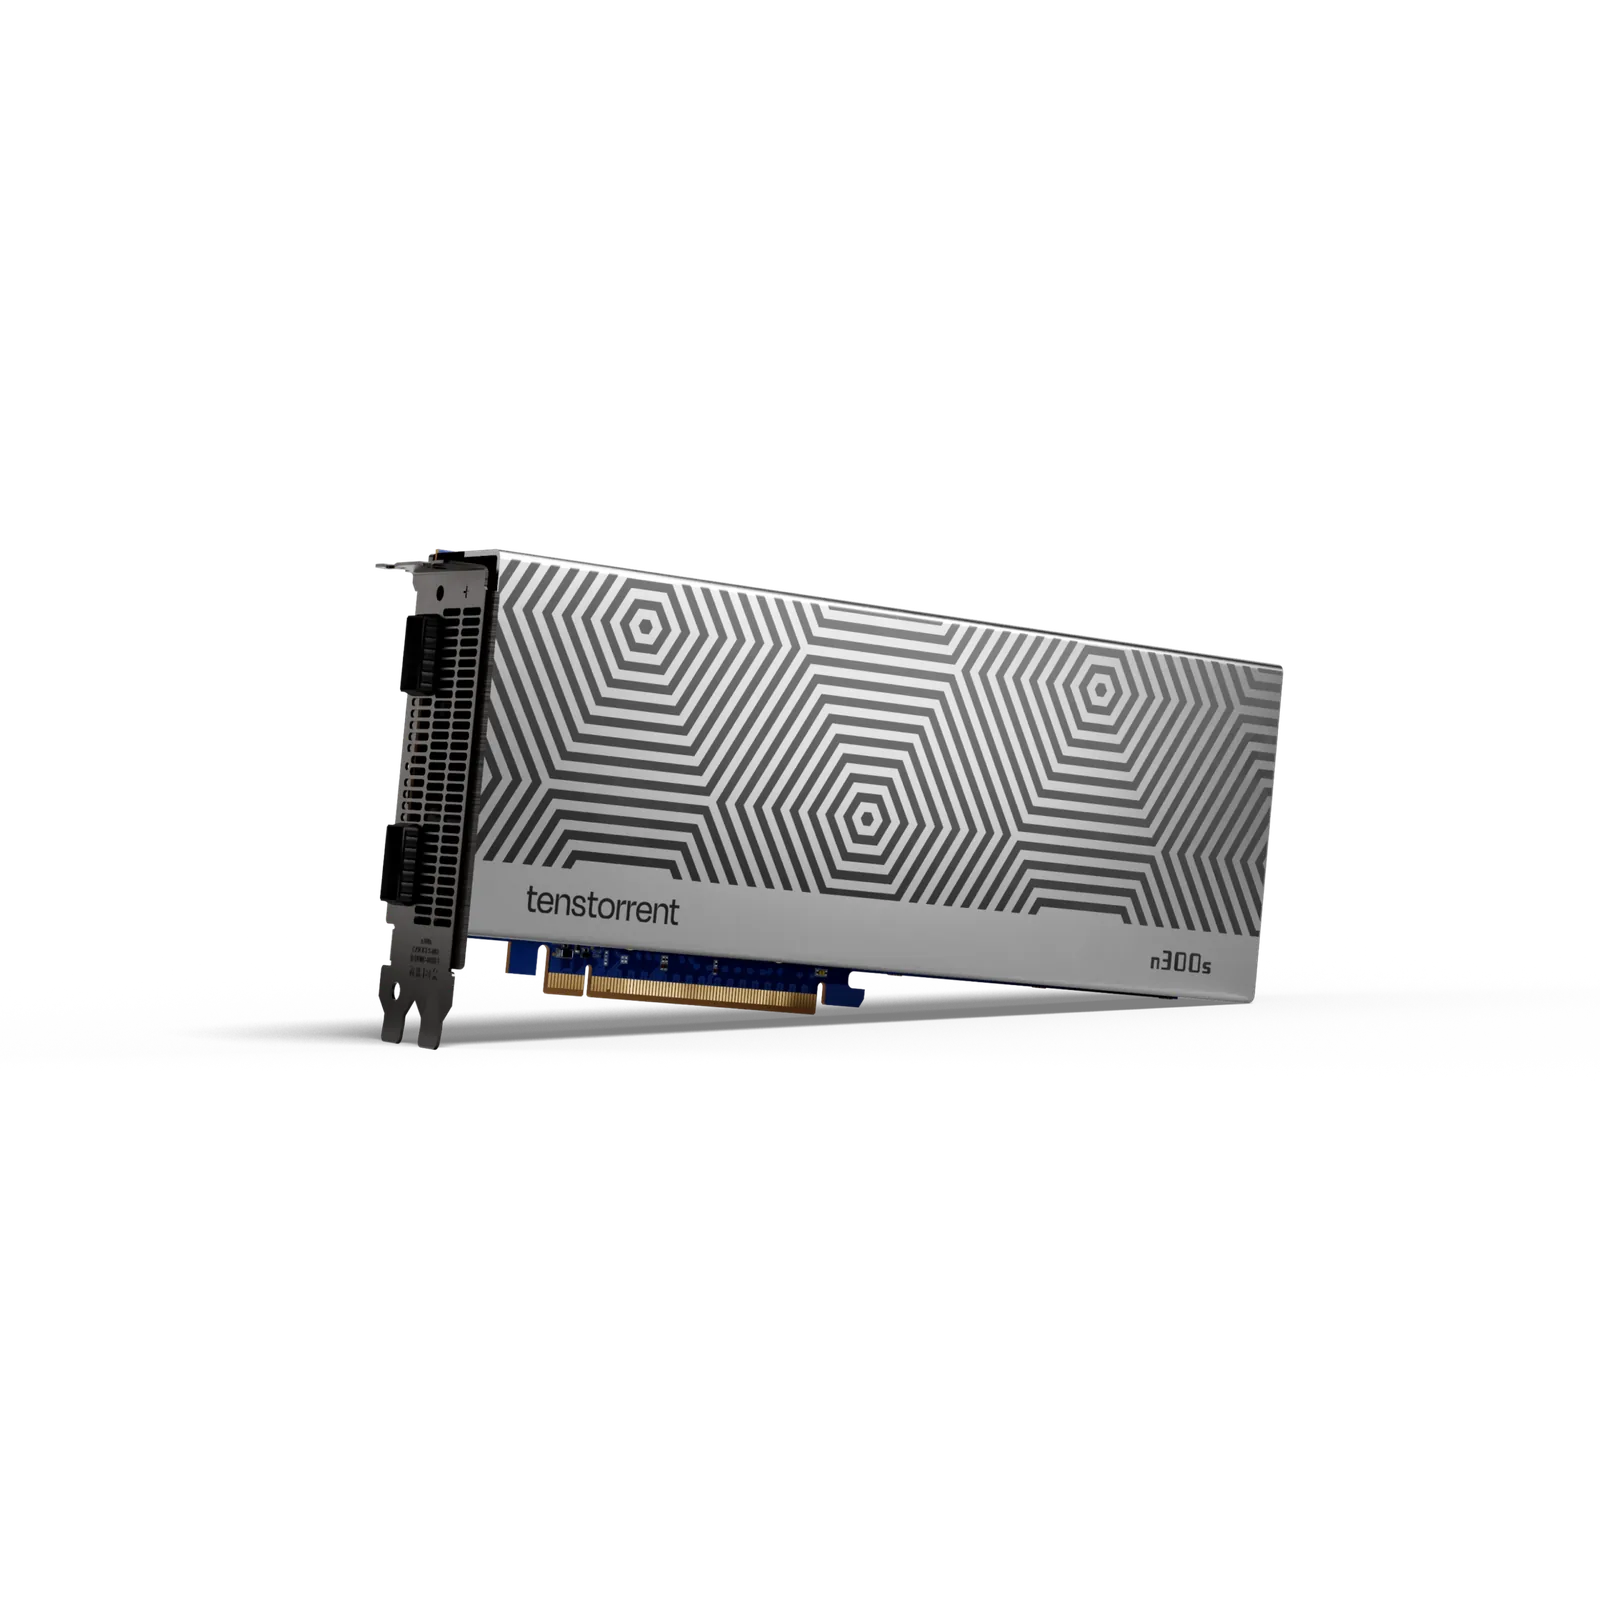
Tenstorrent
Tenstorrent Wormhole n300s
- 24 GB
Ejecuta modelos de hasta 30–34B a 4 bits
Los 24 GB se reparten entre dos chips (12 GB cada uno), por lo que los modelos grandes deben distribuirse entre ambos. Compruebe que el modelo que quiere tiene una versión multichip funcional.
1399 €Dos chips Wormhole y 24 GB en una sola tarjeta, con el mismo software de código abierto que Blackhole, para aprender y desarrollar sobre esa plataforma.
NVIDIA
NVIDIA DGX Spark
- 128 GB unificados
- NVIDIA GB10 Grace Blackwell
Ejecuta modelos de hasta 120B+ a 4 bits
Su ancho de banda de memoria (273 GB/s) es inferior al de una tarjeta gráfica de gama alta, así que los modelos densos grandes generan texto más despacio que en una RTX 5090. Sus puntos fuertes son la capacidad y el stack de software CUDA.
4699 €Tenstorrent
Tenstorrent Blackhole p150a
- 32 GB
- Tenstorrent Blackhole
Ejecuta modelos de hasta 30–34B a 4 bits
No es una tarjeta CUDA. Antes de comprarla, compruebe que los modelos que necesita son compatibles con la biblioteca de modelos de código abierto de Tenstorrent.
1399 €Tenstorrent
Tenstorrent Wormhole n300s
- 24 GB
Ejecuta modelos de hasta 30–34B a 4 bits
Los 24 GB se reparten entre dos chips (12 GB cada uno), por lo que los modelos grandes deben distribuirse entre ambos. Compruebe que el modelo que quiere tiene una versión multichip funcional.
1399 €Cómo elegir un acelerador de IA
- CUDA o código abierto
- El DGX Spark incluye el software de IA de NVIDIA, así que el código escrito en él pasa a sistemas DGX más grandes con pocos cambios. Las tarjetas Tenstorrent funcionan con TT-Metalium y TT-Forge, de código abierto desde los kernels de bajo nivel hasta el compilador de modelos. No son tarjetas CUDA.
- Compruebe primero la compatibilidad de modelos
- Antes de comprar una tarjeta Tenstorrent, compruebe que los modelos que necesita están en la biblioteca de modelos de código abierto de Tenstorrent. En la Wormhole n300 los 24 GB se reparten en 12 GB por chip, así que los modelos más grandes necesitan una versión multichip que funcione.
- La memoria marca el límite
- Según la regla de nuestra guía de modelos, los 128 GB de memoria unificada del Spark admiten un modelo de 70B a 8 bits o uno de la clase de 120B a 4 bits. La Blackhole p150a tiene 32 GB de GDDR6 a 512 GB/s, memoria suficiente para un modelo de la clase de 30B a 4 bits si la biblioteca lo admite.
- Capacidad no es velocidad
- El ancho de banda de memoria del Spark es de 273 GB/s, frente a los 1.792 GB/s de una RTX 5090. Con modelos densos grandes genera texto más despacio; los modelos de mezcla de expertos (MoE), que solo leen una parte de sus pesos por token, notan menos la diferencia.
- Planifique la ampliación
- Dos DGX Spark se conectan entre sí a 200 Gb/s mediante la red ConnectX-7 integrada. La p150a tiene cuatro puertos QSFP-DD 800G y la n300, dos puertos QSFP-DD para encadenar tarjetas. Cada tarjeta Tenstorrent consume 300 W y necesita una ranura PCIe x16, así que conviene prever la alimentación y la ventilación del equipo anfitrión.
Preguntas habituales
¿Me conviene un acelerador de IA o una tarjeta gráfica?
Un acelerador se compra por su software: el DGX Spark para desarrollar con CUDA y 128 GB, una tarjeta Tenstorrent para trabajar con software abierto. Si busca la máxima velocidad con modelos de hasta unos 30B, o si también juega, es mejor opción una tarjeta gráfica como la RTX 5090.
¿Funcionará mi código CUDA en una tarjeta Tenstorrent?
No. Las tarjetas Tenstorrent funcionan con su propio software de código abierto, TT-Metalium y TT-Forge. Antes de comprar, compruebe que sus modelos están admitidos en la biblioteca de modelos de Tenstorrent.
¿Puede el DGX Spark ejecutar Windows o juegos?
No. Funciona con NVIDIA DGX OS, un sistema Linux basado en Ubuntu, sobre una CPU Arm. El software creado solo para Windows x86 no funciona, y no es un equipo para jugar.
¿Se puede hacer fine-tuning de modelos en el DGX Spark?
Sí. El fine-tuning necesita más memoria que ejecutar un modelo, y los métodos eficientes en parámetros como LoRA reducen mucho esa necesidad. Los 128 GB del Spark dan margen para este trabajo con tamaños que una tarjeta de 32 GB no alcanza.
Páginas relacionadas: Hardware para IA local · Apple
Guías
IA local · 4 min de lectura
DGX Spark vs Mac Studio: para quién es el Spark
DGX Spark vs Mac Studio: qué hace bien el Spark, dónde es más lento y cómo se compara con una RTX 5090 y una RTX PRO 6000 para IA local. ¿Merece la pena?
Leer la guía →IA local · 5 min de lectura
Mac, NVIDIA o Ryzen AI Max+ para IA local
Mac, NVIDIA o Ryzen AI Max+: qué plataforma encaja con cada trabajo. CUDA, memoria unificada en Mac o 128 GB en un mini PC. Memoria, software y límites.
Leer la guía →IA local · 5 min de lectura
¿Cuánta memoria hace falta para ejecutar un LLM en local?
Sepa cuánta memoria necesita un LLM local: modelos de 7B a 120B+ a 4 y 8 bits, memoria unificada frente a VRAM y qué equipos admiten cada tamaño.
Leer la guía →