¿Cuánta memoria hace falta para ejecutar un LLM en local?
Actualizado el 17 de noviembre de 2026 · 5 min de lectura
La memoria determina qué modelos se pueden ejecutar; la velocidad va después. Un modelo de 7–8B necesita unos 6 GB a 4 bits, uno de 70B unos 42 GB, y los modelos abiertos más grandes que la mayoría usa en casa, unos 80 GB. A continuación se explica de dónde salen estas cifras y qué equipos las cumplen.
La respuesta corta#
| Tamaño del modelo | Ejemplos | 4-bit | 8-bit | Qué lo admite a 4 bits |
|---|---|---|---|---|
| 7–8B | Llama 3.1 8B, Mistral 7B, Qwen2.5 7B | unos 6 GB | unos 10 GB | Casi cualquier tarjeta gráfica moderna o Mac |
| 13–14B | Phi-4, Qwen2.5 14B | unos 10 GB | unos 16 GB | Una tarjeta de 16 GB o un Mac mini con 24 GB |
| 27–34B | Gemma 2 27B, Qwen2.5 32B | unos 20 GB | unos 38 GB | Una tarjeta de 24 GB o de 32 GB |
| 70B | Llama 3.3 70B, Qwen2.5 72B | unos 42 GB | unos 80 GB | Dos tarjetas de 24 GB, una de 48 GB o al menos 64 GB de memoria unificada |
| 120B+ | gpt-oss-120b (MoE), Mistral Large 2 | unos 80 GB | unos 140 GB | Una tarjeta de 96 GB o un sistema con 128 GB de memoria unificada |
Estas cifras son conservadoras a propósito. Tómelas como el mínimo para trabajar con holgura, no como un límite al que ajustarse.
De dónde salen las cifras#
La regla práctica es sencilla: los pesos de un modelo ocupan aproximadamente parámetros × bits ÷ 8 bytes. Un modelo de 70B a 4 bits ocupa unos 35 GB de pesos. Si se suma un 20–30 % para el contexto (la KV cache), los búferes de ejecución y la parte que usa el sistema operativo, se llega a unos 42 GB.
Los modelos se suelen publicar con precisión de 16 bits, en la que cada mil millones de parámetros ocupa 2 GB, así que un modelo de 8B supone 16 GB de pesos antes de cargar nada más. Por eso pocos usuarios trabajan en casa con precisión completa.
Hay cuatro factores que aumentan la memoria necesaria:
- Contextos largos. La KV cache crece con cada token que el modelo mantiene a la vista, así que un documento o una conversación largos necesitan más de lo que indica la tabla.
- Varios usuarios a la vez. Dar servicio a un equipo implica agrupar peticiones, y cada una necesita su propia memoria de contexto.
- Modelos de imagen y vídeo. Usan la memoria de forma distinta a los modelos de texto; conviene prever más margen.
- Modelos mixture-of-experts (MoE). Son más rápidos que los modelos densos del mismo tamaño porque solo una parte del modelo trabaja en cada token, pero aun así todos los pesos tienen que estar en memoria.
¿4 bits u 8 bits?#
La cuantización guarda cada peso en menos bits. A 4 bits se usa aproximadamente la mitad de memoria que a 8 bits, con una pequeña pérdida de calidad, y es como la mayoría de la gente ejecuta modelos en casa. A 8 bits se conserva más de la calidad original y se necesita aproximadamente el doble de memoria.
Para chat y uso general, a muchos usuarios les resulta más útil un modelo más grande a 4 bits que uno más pequeño a 8 bits en la misma memoria. Para programar o extraer datos exactos, donde los pequeños errores salen caros, merece la pena usar 8 bits si se dispone de memoria suficiente.
Memoria gráfica frente a memoria unificada#
En una tarjeta gráfica, el modelo se aloja en la memoria propia de la tarjeta (VRAM). Nuestra guía de modelos considera utilizable en torno al 90 %.
Los equipos con Apple silicon, Ryzen AI Max+ y DGX Spark comparten un único bloque de memoria unificada entre la CPU y la GPU. El sistema operativo reserva una parte y se aplican los límites de la GPU, por lo que la guía de modelos cuenta como utilizable en torno al 75 %. En los equipos Ryzen AI Max+ con Windows, se pueden asignar a la GPU hasta 96 GB de los 128 GB; Linux permite asignar más. macOS también reserva parte del bloque para el sistema.
En la práctica: un Mac mini con 24 GB dispone de unos 18 GB para modelos, suficiente para un modelo de 14B a 8 bits, pero no para uno de 30B a 4 bits. El mismo Mac mini con 64 GB dispone de unos 48 GB, suficiente para un modelo de 70B a 4 bits.
Si un modelo cabe muy justo, tendrá problemas a medida que crezca la conversación. Deje margen para el contexto.
La memoria decide qué cabe; el ancho de banda, la velocidad#
Una vez que el modelo cabe, su velocidad de escritura depende sobre todo del ancho de banda de memoria, porque cada nuevo token recorre los pesos; un modelo que se desborda a la RAM del sistema se ralentiza mucho. La RTX 5090 alcanza 1.792 GB/s; el Mac Studio con M3 Ultra, 819 GB/s, y tanto el Mac mini con M4 Pro como la DGX Spark, 273 GB/s. Un modelo que cabe en dos de estos equipos suele escribir más rápido en el que tiene más ancho de banda.
Qué equipo para cada tamaño#
- Hasta 14B: la Intel Arc Pro B50 (16 GB) o un Mac mini con 24 GB.
- Hasta 34B a 4 bits: una tarjeta de 24 GB o 32 GB, como la RTX 5090, la Radeon AI PRO R9700, la Arc Pro B60 o la RTX 4090.
- 70B a 4 bits: la Radeon PRO W7900 de 48 GB, dos tarjetas de 24 GB, un Mac Studio o un mini PC Ryzen AI Max+.
- 70B a 8 bits y modelos de clase 120B a 4 bits: la RTX PRO 6000 de 96 GB, un equipo Ryzen AI Max+ de 128 GB o la DGX Spark.
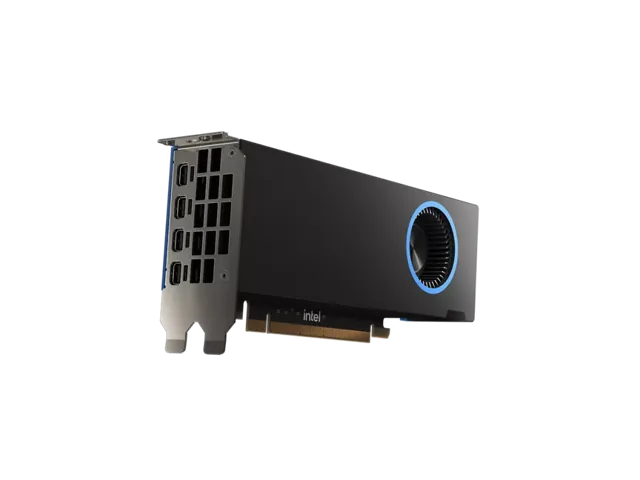
Intel
Intel Arc Pro B50
- 16 GB
- Intel Xe2 (Battlemage)
Ejecuta modelos de hasta 13–14B a 4 bits
No necesita cable de alimentación, por lo que es adecuada para equipos de formato reducido. Con 16 GB ejecuta modelos de 7B a 14B a 4 bits; para modelos mayores se necesita una tarjeta más grande.
299 €
NVIDIA
NVIDIA GeForce RTX 5090
- 32 GB
- NVIDIA Blackwell (GB202)
Ejecuta modelos de hasta 30–34B a 4 bits
Con 32 GB se ejecutan con holgura modelos de la clase 30B a 4 bits, pero un modelo de 70B no cabe en una sola tarjeta. Para 70B, cuente con dos tarjetas o con un sistema de memoria unificada de gran capacidad.
1999 €
Apple
Apple Mac Studio (M3 Ultra)
- 96 GB unificados
- 60 núcleos; opción de 80 núcleos
Ejecuta modelos de hasta 70B a 4 bits
macOS reserva parte de la memoria unificada para el sistema, así que cuente con que la GPU usará la mayor parte, no toda. Elija una configuración con cierto margen por encima del modelo.
3999 €
Beelink
Beelink GTR9 Pro
- 128 GB unificados
- AMD Ryzen AI Max+ 395
Ejecuta modelos de hasta 120B+ a 4 bits
En Windows se pueden asignar a la GPU hasta 96 GB de los 128 GB. Antes de comprar, compruebe que el modelo que quiere ejecutar cabe en esa cantidad.
4349 €Un equipo más económico es suficiente si a su trabajo le bastan los modelos pequeños. Resúmenes, chat, autocompletado de código y búsqueda en sus propios documentos funcionan con modelos de 7–14B, que caben en 16 GB. La guía de modelos indica qué modelos caben en cada producto que vendemos.
Preguntas habituales
¿Puedo ejecutar un modelo de 70B en una tarjeta gráfica de 32 GB?
No con holgura. A 4 bits necesita unos 42 GB. Algunas herramientas pueden pasar parte del modelo a la RAM del sistema, pero esa parte va mucho más lenta. Para 70B, prevea dos tarjetas de 24 GB, una de 48 GB o un equipo de memoria unificada con 64 GB o más.
¿Cuenta la RAM del sistema de mi PC?
En un PC con tarjeta gráfica, solo la memoria de la tarjeta funciona a plena velocidad. Algunas herramientas pueden colocar parte del modelo en la RAM del sistema, a costa de perder mucha velocidad. En los equipos de memoria unificada, la memoria compartida es la que usa la GPU.
¿Cuánta memoria adicional necesitan los documentos largos?
La memoria de contexto crece con la longitud, así que conviene dejar margen sobre las cifras de la tabla. Para documentos o conversaciones largas, elija el siguiente tamaño de memoria en lugar del que apenas basta para el modelo.
¿Compensa usar 8 bits a cambio del doble de memoria?
Para chat general, la mayoría usa 4 bits y la pérdida de calidad es pequeña. Para programar o extraer datos con precisión, 8 bits compensa si hay memoria suficiente.
Comprar en esta categoría: Hardware para IA local · Tarjetas gráficas · Apple
Guías relacionadas
IA local · 5 min de lectura
Mac, NVIDIA o Ryzen AI Max+ para IA local
Mac, NVIDIA o Ryzen AI Max+: qué plataforma encaja con cada trabajo. CUDA, memoria unificada en Mac o 128 GB en un mini PC. Memoria, software y límites.
Leer la guía →Tarjetas gráficas · 5 min de lectura
Cómo elegir una GPU para IA local: RTX 5090, R9700 y B60
Cómo elegir una GPU para IA local según memoria, software y ancho de banda: RTX 5090, Radeon AI PRO R9700, Arc Pro B60 y las profesionales de 48 y 96 GB.
Leer la guía →IA local · 4 min de lectura
DGX Spark vs Mac Studio: para quién es el Spark
DGX Spark vs Mac Studio: qué hace bien el Spark, dónde es más lento y cómo se compara con una RTX 5090 y una RTX PRO 6000 para IA local. ¿Merece la pena?
Leer la guía →