Wie viel Arbeitsspeicher braucht ein lokales LLM?
Aktualisiert am 17. November 2026 · 5 Min. Lesezeit
Der Speicher entscheidet, welche Modelle Sie ausführen können; die Geschwindigkeit kommt erst danach. Ein 7–8B-Modell braucht mit 4 Bit etwa 6 GB, ein 70B-Modell etwa 42 GB und die größten offenen Modelle, die die meisten zu Hause nutzen, etwa 80 GB. Hier erfahren Sie, woher diese Zahlen kommen und welche Rechner diese Anforderungen erfüllen.
Die kurze Antwort#
| Modellgröße | Beispiele | 4-bit | 8-bit | Was es mit 4 Bit schafft |
|---|---|---|---|---|
| 7–8B | Llama 3.1 8B, Mistral 7B, Qwen2.5 7B | etwa 6 GB | etwa 10 GB | Fast jede aktuelle Grafikkarte oder jeder Mac |
| 13–14B | Phi-4, Qwen2.5 14B | etwa 10 GB | etwa 16 GB | Eine Grafikkarte mit 16 GB oder ein Mac mini mit 24 GB |
| 27–34B | Gemma 2 27B, Qwen2.5 32B | etwa 20 GB | etwa 38 GB | Eine Grafikkarte mit 24 GB oder 32 GB |
| 70B | Llama 3.3 70B, Qwen2.5 72B | etwa 42 GB | etwa 80 GB | Zwei Grafikkarten mit 24 GB, eine mit 48 GB oder mindestens 64 GB gemeinsamer Arbeitsspeicher |
| 120B+ | gpt-oss-120b (MoE), Mistral Large 2 | etwa 80 GB | etwa 140 GB | Eine Grafikkarte mit 96 GB oder ein System mit 128 GB gemeinsamem Arbeitsspeicher |
Diese Werte sind bewusst vorsichtig angesetzt. Verstehen Sie sie als Untergrenze für einen komfortablen Betrieb, nicht als Wert, den Sie gerade so erreichen sollten.
Woher die Zahlen kommen#
Die Faustregel ist einfach: Die Gewichte eines Modells belegen etwa Parameter × Bit ÷ 8 Byte. Ein 70B-Modell mit 4 Bit kommt auf rund 35 GB Gewichte. Rechnen Sie 20–30 % für den Kontext (den KV cache), Laufzeitpuffer und den Anteil des Betriebssystems hinzu, landen Sie bei etwa 42 GB.
Modelle erscheinen meist mit 16-Bit-Genauigkeit, bei der jede Milliarde Parameter 2 GB belegt. Ein 8B-Modell hat damit 16 GB Gewichte, bevor überhaupt etwas anderes geladen ist. Deshalb nutzen zu Hause nur wenige die volle Genauigkeit.
Vier Faktoren erhöhen den Bedarf:
- Lange Kontexte. Der KV cache wächst mit jedem Token, das das Modell im Blick behält. Ein langes Dokument oder ein langer Chat braucht daher mehr, als die Tabelle angibt.
- Mehrere Nutzer gleichzeitig. Wer ein Team bedient, bündelt Anfragen, und jede davon braucht ihren eigenen Kontextspeicher.
- Bild- und Videomodelle. Sie nutzen den Speicher anders als Textmodelle; planen Sie mehr Reserve ein.
- Mixture-of-Experts-Modelle (MoE). Sie laufen schneller als dichte Modelle gleicher Größe, weil pro Token nur ein Teil des Modells arbeitet. Alle Gewichte müssen aber trotzdem im Speicher liegen.
4 Bit oder 8 Bit?#
Bei der Quantisierung wird jedes Gewicht mit weniger Bits gespeichert. Mit 4 Bit braucht ein Modell etwa halb so viel Speicher wie mit 8 Bit, bei geringem Qualitätsverlust; so betreiben die meisten Nutzer Modelle zu Hause. Mit 8 Bit bleibt mehr von der ursprünglichen Qualität erhalten, der Speicherbedarf ist aber ungefähr doppelt so hoch.
Für Chat und allgemeine Aufgaben ist ein größeres Modell mit 4 Bit für viele nützlicher als ein kleineres mit 8 Bit im gleichen Speicher. Beim Programmieren oder bei der exakten Datenextraktion, wo kleine Fehler teuer werden, lohnt sich 8 Bit, wenn der Speicher vorhanden ist.
Grafikspeicher und gemeinsamer Arbeitsspeicher#
Bei einer Grafikkarte liegt das Modell im eigenen Speicher der Karte (VRAM). Unser Modell-Ratgeber setzt davon etwa 90 % als nutzbar an.
Bei Apple Silicon, Ryzen AI Max+ und DGX Spark teilen sich CPU und GPU einen gemeinsamen Arbeitsspeicher (Unified Memory). Das Betriebssystem belegt einen Teil davon, und es gelten GPU-Grenzen; der Modell-Ratgeber setzt daher etwa 75 % als nutzbar an. Bei Ryzen-AI-Max+-Rechnern unter Windows lassen sich der GPU bis zu 96 GB der 128 GB zuweisen, unter Linux mehr. Auch macOS reserviert einen Teil des Speichers für das System.
In der Praxis: Ein Mac mini mit 24 GB hat etwa 18 GB für Modelle frei. Das reicht für ein 14B-Modell mit 8 Bit, aber nicht für ein 30B-Modell mit 4 Bit. Derselbe Mac mini mit 64 GB bietet etwa 48 GB und damit genug für ein 70B-Modell mit 4 Bit.
Passt ein Modell nur knapp hinein, kommt es bei längeren Unterhaltungen an seine Grenzen. Lassen Sie Platz für den Kontext.
Der Speicher bestimmt, was passt, die Bandbreite das Tempo#
Passt ein Modell in den Speicher, hängt die Ausgabegeschwindigkeit vor allem von der Speicherbandbreite ab, denn für jedes neue Token werden die Gewichte gelesen. Ein Modell, das in den System-RAM ausweicht, wird deutlich langsamer. Die RTX 5090 schafft 1.792 GB/s, der Mac Studio mit M3 Ultra 819 GB/s, der Mac mini mit M4 Pro und die DGX Spark jeweils 273 GB/s. Ein Modell, das auf zwei dieser Rechner passt, läuft in der Regel auf dem mit der höheren Bandbreite schneller.
Welcher Rechner für welche Modellgröße#
- Bis 14B: die Intel Arc Pro B50 (16 GB) oder ein Mac mini mit 24 GB.
- Bis 34B mit 4 Bit: eine Karte mit 24 GB oder 32 GB, etwa die RTX 5090, Radeon AI PRO R9700, Arc Pro B60 oder RTX 4090.
- 70B mit 4 Bit: die Radeon PRO W7900 mit 48 GB, zwei Karten mit je 24 GB, ein Mac Studio oder ein Ryzen-AI-Max+-Mini-PC.
- 70B mit 8 Bit und 120B-Klasse mit 4 Bit: die RTX PRO 6000 mit 96 GB, ein Ryzen-AI-Max+-Rechner mit 128 GB oder die DGX Spark.
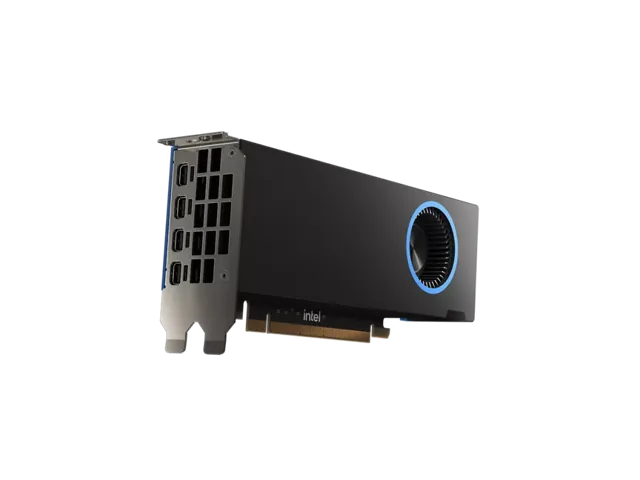
Intel
Intel Arc Pro B50
- 16 GB
- Intel Xe2 (Battlemage)
Schafft bis zu 13–14B bei 4 Bit
Ein Stromkabel ist nicht nötig, daher eignet sie sich für kompakte Rechner. 16 GB reichen für Modelle mit 7B bis 14B bei 4 Bit; größere Modelle brauchen eine größere Karte.
299 €
NVIDIA
NVIDIA GeForce RTX 5090
- 32 GB
- NVIDIA Blackwell (GB202)
Schafft bis zu 30–34B bei 4 Bit
Mit 32 GB laufen Modelle der 30B-Klasse in 4 Bit problemlos, ein 70B-Modell passt aber nicht auf eine Karte. Für 70B sollten Sie zwei Karten oder ein System mit großem gemeinsamem Arbeitsspeicher einplanen.
1.999 €
Apple
Apple Mac Studio (M3 Ultra)
- 96 GB Unified
- 60 Kerne; optional 80 Kerne
Schafft bis zu 70B bei 4 Bit
macOS reserviert einen Teil des gemeinsamen Arbeitsspeichers für das System, die GPU kann also den Großteil nutzen, aber nicht alles. Wählen Sie die Konfiguration mit etwas Reserve über der Modellgröße.
3.999 €
Beelink
Beelink GTR9 Pro
- 128 GB Unified
- AMD Ryzen AI Max+ 395
Schafft bis zu 120B+ bei 4 Bit
Unter Windows lassen sich der GPU bis zu 96 GB der 128 GB zuweisen. Prüfen Sie vor dem Kauf, ob das Modell, das Sie nutzen möchten, in diesen Speicher passt.
4.349 €Ein günstigerer Rechner genügt, wenn Ihre Aufgaben mit kleinen Modellen auskommen. Zusammenfassungen, Chat, Code-Vervollständigung und die Suche in eigenen Dokumenten funktionieren mit 7–14B-Modellen, und diese passen in 16 GB. Der Modell-Ratgeber zeigt für jedes Produkt in unserem Sortiment, welche Modelle passen.
Häufige Fragen
Kann ich ein 70B-Modell auf einer Grafikkarte mit 32 GB betreiben?
Nicht ohne Weiteres. Mit 4 Bit benötigt es etwa 42 GB. Tools können zwar einen Teil des Modells in den System-RAM auslagern, dieser Teil läuft aber deutlich langsamer. Planen Sie für 70B zwei Karten mit je 24 GB, eine Karte mit 48 GB oder einen Rechner mit gemeinsamem Arbeitsspeicher ab 64 GB ein.
Zählt der Arbeitsspeicher meines PCs mit?
Bei einem PC mit Grafikkarte läuft nur der Speicher der Karte mit voller Geschwindigkeit. Manche Tools können einen Teil des Modells in den System-RAM legen, allerdings auf Kosten eines deutlichen Tempoverlusts. Bei Rechnern mit gemeinsamem Arbeitsspeicher ist der gemeinsame Speicherpool zugleich der Speicher, den die GPU nutzt.
Wie viel zusätzlichen Speicher brauchen lange Dokumente?
Der Kontextspeicher wächst mit der Länge, planen Sie daher Reserven über die Werte in der Tabelle hinaus ein. Wählen Sie für lange Dokumente oder lange Chats die nächstgrößere Speicherausstattung statt der, in die das Modell gerade so passt.
Ist 8 Bit den doppelten Speicherbedarf wert?
Für allgemeinen Chat nutzen die meisten 4 Bit, und der Qualitätsverlust ist gering. Beim Programmieren oder bei exakter Extraktion lohnt sich 8 Bit, wenn genug Speicher vorhanden ist.
Passende Produkte: Hardware für lokale KI · Grafikkarten · Apple
Passende Ratgeber
Lokale KI · 5 Min. Lesezeit
Mac, NVIDIA oder Ryzen AI Max+ für lokale KI
Mac, NVIDIA oder Ryzen AI Max+: CUDA bei NVIDIA, gemeinsamer Arbeitsspeicher beim Mac oder 128 GB im Mini-PC. Speicher, Software und Kompromisse.
Ratgeber lesen →Grafikkarten · 5 Min. Lesezeit
GPU für lokale KI wählen: RTX 5090, R9700, B60
GPU für lokale KI nach Speicher, Software und Bandbreite wählen: RTX 5090, Radeon AI PRO R9700, Arc Pro B60 sowie Workstation-Karten mit 48 und 96 GB.
Ratgeber lesen →Lokale KI · 4 Min. Lesezeit
DGX Spark vs Mac Studio: Für wen ist der Spark gedacht?
Lohnt sich der DGX Spark? Was er gut kann, wo er langsamer ist und wie er bei lokaler KI abschneidet: DGX Spark vs Mac Studio, RTX 5090 und RTX PRO 6000.
Ratgeber lesen →