Quanta memoria serve per eseguire un LLM in locale?
Aggiornato il 17 novembre 2026 · 5 min di lettura
È la memoria a stabilire quali modelli si possono eseguire; la velocità viene dopo. Un modello 7–8B richiede circa 6 GB a 4 bit, un modello 70B circa 42 GB e i modelli aperti più grandi che di solito si usano in casa circa 80 GB. Ecco da dove vengono questi numeri e quali macchine ne dispongono.
La risposta breve#
| Dimensione del modello | Esempi | 4-bit | 8-bit | Cosa serve a 4 bit |
|---|---|---|---|---|
| 7–8B | Llama 3.1 8B, Mistral 7B, Qwen2.5 7B | circa 6 GB | circa 10 GB | Quasi qualsiasi scheda video o Mac recente |
| 13–14B | Phi-4, Qwen2.5 14B | circa 10 GB | circa 16 GB | Una scheda da 16 GB o un Mac mini con 24 GB |
| 27–34B | Gemma 2 27B, Qwen2.5 32B | circa 20 GB | circa 38 GB | Una scheda da 24 GB o 32 GB |
| 70B | Llama 3.3 70B, Qwen2.5 72B | circa 42 GB | circa 80 GB | Due schede da 24 GB, una scheda da 48 GB o almeno 64 GB di memoria unificata |
| 120B+ | gpt-oss-120b (MoE), Mistral Large 2 | circa 80 GB | circa 140 GB | Una scheda da 96 GB o un sistema con 128 GB di memoria unificata |
Questi valori sono volutamente prudenti. Vanno letti come il minimo per lavorare con margine, non come una soglia da raggiungere a fatica.
Da dove vengono i numeri#
La regola pratica è semplice: i pesi di un modello occupano circa parametri × bit ÷ 8 byte. Un modello 70B a 4 bit corrisponde a circa 35 GB di pesi. Aggiungendo un 20–30% per il contesto (la KV cache), i buffer di runtime e la quota del sistema operativo, si arriva a circa 42 GB.
I modelli vengono di solito pubblicati con precisione a 16 bit, in cui ogni miliardo di parametri occupa 2 GB: un modello 8B equivale quindi a 16 GB di pesi prima ancora di caricare altro. Per questo in casa pochi usano la precisione piena.
Quattro fattori fanno crescere il fabbisogno:
- Contesti lunghi. La KV cache cresce a ogni token che il modello deve tenere presente, quindi un documento lungo o una chat lunga richiedono più di quanto indicato in tabella.
- Più utenti contemporaneamente. Servire un team significa raggruppare le richieste in batch, e ciascuna richiede la propria memoria per il contesto.
- Modelli per immagini e video. Usano la memoria in modo diverso dai modelli testuali; conviene prevedere più margine.
- Modelli mixture-of-experts (MoE). Sono più veloci dei modelli densi della stessa dimensione perché per ogni token lavora solo una parte del modello, ma tutti i pesi devono comunque stare in memoria.
4 bit o 8 bit?#
La quantizzazione memorizza ogni peso con meno bit. A 4 bit si occupa circa metà della memoria richiesta a 8 bit, con una piccola perdita di qualità, ed è il modo in cui la maggior parte delle persone esegue i modelli in casa. A 8 bit la qualità resta più vicina all'originale, ma serve circa il doppio della memoria.
Per la chat e l'uso generale, a parità di memoria molti trovano più utile un modello più grande a 4 bit di uno più piccolo a 8 bit. Per la programmazione o l'estrazione esatta di dati, dove anche piccoli errori costano, vale la pena di usare gli 8 bit, se la memoria lo consente.
Memoria video e memoria unificata#
Su una scheda video il modello risiede nella memoria della scheda stessa (VRAM). La nostra guida ai modelli ne considera utilizzabile circa il 90%.
Le macchine con Apple silicon, Ryzen AI Max+ e DGX Spark condividono tra CPU e GPU un unico pool di memoria unificata. Il sistema operativo ne riserva una parte e valgono i limiti della GPU, quindi la guida ai modelli considera utilizzabile circa il 75%. Sulle macchine Ryzen AI Max+ con Windows è possibile assegnare alla GPU fino a 96 GB dei 128 GB; con Linux se ne possono assegnare di più. Anche macOS riserva una parte del pool al sistema.
In pratica: un Mac mini con 24 GB ha circa 18 GB per i modelli, sufficienti per un modello 14B a 8 bit ma non per un 30B a 4 bit. Lo stesso Mac mini con 64 GB dispone di circa 48 GB, sufficienti per un modello 70B a 4 bit.
Un modello che entra appena in memoria va in difficoltà man mano che la conversazione si allunga. Conviene lasciare spazio per il contesto.
La memoria decide cosa entra, la banda decide la velocità#
Quando un modello entra in memoria, la sua velocità di generazione dipende soprattutto dalla banda di memoria, perché ogni nuovo token richiede la lettura dei pesi; un modello che sconfina nella RAM di sistema rallenta drasticamente. La RTX 5090 raggiunge 1.792 GB/s, il Mac Studio con M3 Ultra 819 GB/s, il Mac mini con M4 Pro e la DGX Spark 273 GB/s ciascuno. Un modello che entra in due di queste macchine sarà in genere più veloce su quella con più banda.
Quale macchina per quale dimensione#
- Fino a 14B: la Intel Arc Pro B50 (16 GB), oppure un Mac mini con 24 GB.
- Fino a 34B a 4 bit: una scheda da 24 GB o 32 GB, come RTX 5090, Radeon AI PRO R9700, Arc Pro B60 o RTX 4090.
- 70B a 4 bit: la Radeon PRO W7900 da 48 GB, due schede da 24 GB, un Mac Studio o un mini PC Ryzen AI Max+.
- 70B a 8 bit e modelli di classe 120B a 4 bit: la RTX PRO 6000 da 96 GB, una macchina Ryzen AI Max+ da 128 GB o la DGX Spark.
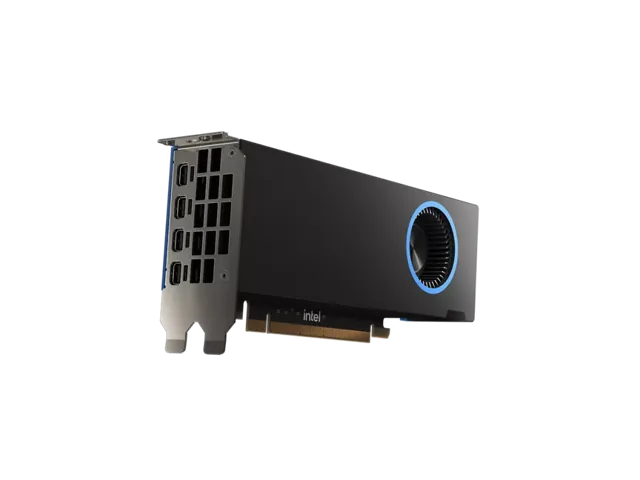
Intel
Intel Arc Pro B50
- 16 GB
- Intel Xe2 (Battlemage)
Esegue modelli fino a 13–14B a 4 bit
Non richiede cavi di alimentazione, quindi è adatta alle macchine small form factor. Con 16 GB esegue modelli da 7B a 14B a 4 bit; per modelli più grandi serve una scheda più capiente.
299 €
NVIDIA
NVIDIA GeForce RTX 5090
- 32 GB
- NVIDIA Blackwell (GB202)
Esegue modelli fino a 30–34B a 4 bit
Con 32 GB i modelli di classe 30B girano senza problemi a 4 bit, ma un modello 70B non entra in una sola scheda. Per un 70B occorrono due schede o un sistema con molta memoria unificata.
1999 €
Apple
Apple Mac Studio (M3 Ultra)
- 96 GB unificati
- 60 core; opzione a 80 core
Esegue modelli fino a 70B a 4 bit
macOS riserva al sistema una parte della memoria unificata, quindi si consideri che la GPU ne userà la maggior parte, non tutta. Si consiglia una configurazione con un certo margine oltre la dimensione del modello.
3999 €
Beelink
Beelink GTR9 Pro
- 128 GB unificati
- AMD Ryzen AI Max+ 395
Esegue modelli fino a 120B+ a 4 bit
Su Windows è possibile assegnare alla GPU fino a 96 GB dei 128 GB disponibili. Prima dell'acquisto si consiglia di verificare che il modello che si intende eseguire rientri in questo limite.
4349 €Una macchina più economica è sufficiente se per il proprio lavoro bastano i modelli piccoli. Riassunti, chat, completamento del codice e ricerca nei propri documenti funzionano con modelli 7–14B, che entrano in 16 GB. La guida ai modelli indica la compatibilità di ogni prodotto in catalogo.
Domande frequenti
Posso eseguire un modello 70B su una scheda video da 32 GB?
Non in modo agevole. A 4 bit richiede circa 42 GB. Alcuni strumenti possono spostare parte del modello nella RAM di sistema, ma quella parte gira molto più lentamente. Per un 70B occorrono due schede da 24 GB, una da 48 GB o una macchina a memoria unificata con almeno 64 GB.
La RAM di sistema del mio PC conta?
Su un PC con scheda video, solo la memoria della scheda lavora alla massima velocità. Alcuni strumenti possono collocare parte del modello nella RAM di sistema, con un forte calo di velocità. Sulle macchine a memoria unificata, la memoria condivisa è quella usata dalla GPU.
Quanta memoria in più serve per i documenti lunghi?
La memoria del contesto cresce con la lunghezza, quindi conviene prevedere un margine oltre i valori in tabella. Per documenti o chat lunghe, si consiglia il taglio di memoria superiore anziché quello che contiene appena il modello.
Vale la pena usare gli 8 bit, che richiedono il doppio della memoria?
Per la chat generica, la maggior parte delle persone usa i 4 bit e la perdita di qualità è ridotta. Per la programmazione o l'estrazione esatta, gli 8 bit convengono se la memoria è sufficiente.
Prodotti per questo tema: Hardware per l'IA locale · Schede video · Apple
Guide correlate
IA locale · 5 min di lettura
Mac, NVIDIA o Ryzen AI Max+ per l'IA locale
Mac, NVIDIA o Ryzen AI Max+: CUDA su NVIDIA, memoria unificata su Mac o 128 GB su un mini PC. Quale piattaforma per quale lavoro e con quali compromessi.
Leggi la guida →Schede video · 5 min di lettura
Scegliere una GPU per l'IA locale: RTX 5090, R9700, B60
Come scegliere una GPU per l'IA locale in base a memoria, software e banda: RTX 5090, Radeon AI PRO R9700, Arc Pro B60 e schede workstation da 48 e 96 GB.
Leggi la guida →IA locale · 4 min di lettura
DGX Spark vs Mac Studio: a chi è adatta la Spark
Conviene la DGX Spark? Punti di forza della macchina, dove è più lenta e confronto DGX Spark vs Mac Studio, RTX 5090 e RTX PRO 6000 per l'IA locale.
Leggi la guida →