Hoeveel geheugen heb je nodig voor een lokaal LLM?
Bijgewerkt op 17 november 2026 · 5 min lezen
Geheugen bepaalt welke modellen je kunt draaien; snelheid komt op de tweede plaats. Een 7–8B-model heeft op 4-bit ongeveer 6 GB nodig, een 70B-model ongeveer 42 GB, en de grootste open modellen die de meeste mensen thuis draaien ongeveer 80 GB. Hier lees je waar die getallen vandaan komen en welke machines eraan voldoen.
Het korte antwoord#
| Modelgrootte | Voorbeelden | 4-bit | 8-bit | Wat het aankan op 4-bit |
|---|---|---|---|---|
| 7–8B | Llama 3.1 8B, Mistral 7B, Qwen2.5 7B | ongeveer 6 GB | ongeveer 10 GB | Vrijwel elke moderne videokaart of Mac |
| 13–14B | Phi-4, Qwen2.5 14B | ongeveer 10 GB | ongeveer 16 GB | Een kaart met 16 GB, of een Mac mini met 24 GB |
| 27–34B | Gemma 2 27B, Qwen2.5 32B | ongeveer 20 GB | ongeveer 38 GB | Eén kaart met 24 GB of 32 GB |
| 70B | Llama 3.3 70B, Qwen2.5 72B | ongeveer 42 GB | ongeveer 80 GB | Twee kaarten met 24 GB, één kaart met 48 GB, of 64 GB+ unified memory |
| 120B+ | gpt-oss-120b (MoE), Mistral Large 2 | ongeveer 80 GB | ongeveer 140 GB | Een kaart met 96 GB of een systeem met 128 GB unified memory |
Deze getallen zijn bewust voorzichtig gekozen. Zie ze als het minimum voor een comfortabele opstelling, niet als een grens waar je je model nog net in probeert te proppen.
Waar de getallen vandaan komen#
De vuistregel is eenvoudig: de gewichten van een model nemen ongeveer parameters × bits ÷ 8 bytes in beslag. Een 70B-model op 4-bit komt zo op ongeveer 35 GB aan gewichten. Tel daar 20–30% bij op voor de context (de KV cache), runtimebuffers en wat het besturingssysteem zelf gebruikt, en je komt uit op ongeveer 42 GB.
Modellen worden meestal uitgebracht op 16-bit precisie, waarbij elk miljard parameters 2 GB in beslag neemt. Een 8B-model is dan al 16 GB aan gewichten, nog voordat er iets anders wordt geladen. Daarom draaien weinig mensen thuis op volle precisie.
Vier dingen verhogen de geheugenbehoefte:
- Lange contexten. De KV cache groeit met elk token dat het model in beeld houdt. Een lang document of een lang gesprek vraagt dus meer geheugen dan de tabel aangeeft.
- Meerdere gebruikers tegelijk. Wie een team bedient, verwerkt verzoeken in batches, en elk verzoek heeft zijn eigen contextgeheugen nodig.
- Beeld- en videomodellen. Die gebruiken geheugen anders dan tekstmodellen; reken op meer marge.
- Mixture-of-experts-modellen (MoE). Ze draaien sneller dan dense modellen van dezelfde grootte, omdat per token maar een deel van het model actief is. Toch moeten alle gewichten in het geheugen staan.
4-bit of 8-bit?#
Bij kwantisatie wordt elk gewicht in minder bits opgeslagen. Op 4-bit gebruikt een model ongeveer de helft van het geheugen dat het op 8-bit nodig heeft, met een klein kwaliteitsverlies. Zo draaien de meeste mensen modellen thuis. Op 8-bit blijft meer van de oorspronkelijke kwaliteit behouden, maar heb je ongeveer twee keer zoveel geheugen nodig.
Voor chat en algemeen gebruik vinden veel mensen een groter model op 4-bit nuttiger dan een kleiner model op 8-bit in hetzelfde geheugen. Voor programmeren of het exact uitlezen van gegevens, waar kleine fouten zich wreken, is 8-bit het geheugen waard als je het hebt.
Videogeheugen versus unified memory#
Op een videokaart staat het model in het eigen geheugen van de kaart (VRAM). Onze modelgids rekent ongeveer 90% daarvan als bruikbaar.
Machines met Apple silicon, Ryzen AI Max+ en DGX Spark delen één pool unified memory tussen de CPU en de GPU. Het besturingssysteem reserveert een deel daarvan en er gelden GPU-limieten, dus de modelgids rekent ongeveer 75% als bruikbaar. Op Ryzen AI Max+-machines onder Windows kan de GPU tot 96 GB van de 128 GB krijgen; onder Linux kun je meer toewijzen. Ook macOS reserveert een deel van de pool voor het systeem.
In de praktijk: een Mac mini met 24 GB heeft ongeveer 18 GB voor modellen. Dat is genoeg voor een 14B-model op 8-bit, maar niet voor een 30B-model op 4-bit. Dezelfde Mac mini met 64 GB heeft ongeveer 48 GB, genoeg voor een 70B-model op 4-bit.
Past een model maar net, dan komt het in de problemen naarmate het gesprek langer wordt. Houd ruimte over voor de context.
Geheugen bepaalt wat past, bandbreedte bepaalt de snelheid#
Als een model eenmaal past, hangt de schrijfsnelheid vooral af van de geheugenbandbreedte, omdat voor elk nieuw token de gewichten worden doorgelezen; een model dat overloopt naar het systeemgeheugen wordt flink trager. De RTX 5090 haalt 1.792 GB/s, de Mac Studio met M3 Ultra 819 GB/s, en de Mac mini met M4 Pro en de DGX Spark elk 273 GB/s. Een model dat op twee van deze machines past, schrijft doorgaans sneller op de machine met de meeste bandbreedte.
Welke machine voor welke modelgrootte#
- Tot 14B: de Intel Arc Pro B50 (16 GB) of een Mac mini met 24 GB.
- Tot 34B op 4-bit: één kaart met 24 GB of 32 GB, zoals de RTX 5090, Radeon AI PRO R9700, Arc Pro B60 of RTX 4090.
- 70B op 4-bit: de Radeon PRO W7900 met 48 GB, twee kaarten met 24 GB, een Mac Studio of een Ryzen AI Max+ mini-pc.
- 70B op 8-bit en de 120B-klasse op 4-bit: de RTX PRO 6000 met 96 GB, een Ryzen AI Max+-machine met 128 GB of de DGX Spark.
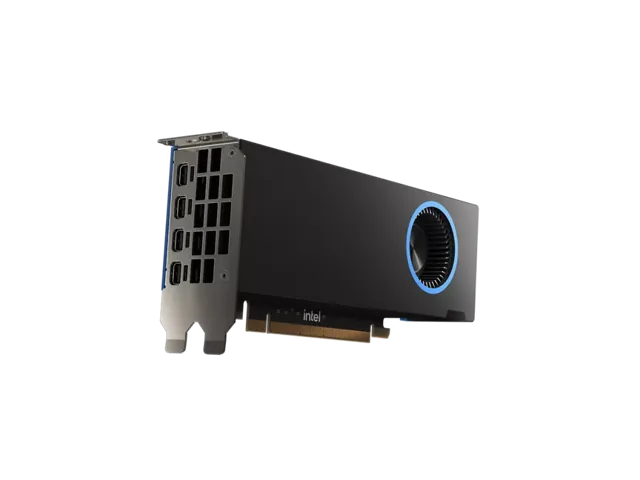
Intel
Intel Arc Pro B50
- 16 GB
- Intel Xe2 (Battlemage)
Draait tot 13–14B op 4-bit
Er is geen voedingskabel nodig, dus de kaart is geschikt voor small-form-factor-machines. Met 16 GB draai je modellen van 7B tot 14B op 4-bit; voor alles wat groter is heb je een grotere kaart nodig.
€ 299
NVIDIA
NVIDIA GeForce RTX 5090
- 32 GB
- NVIDIA Blackwell (GB202)
Draait tot 30–34B op 4-bit
Met 32 GB draai je modellen van de 30B-klasse probleemloos op 4-bit, maar een 70B-model past niet op één kaart. Reken voor 70B op twee kaarten of een systeem met veel unified memory.
€ 1.999
Apple
Apple Mac Studio (M3 Ultra)
- 96 GB unified
- 60 cores; optie met 80 cores
Draait tot 70B op 4-bit
macOS reserveert een deel van de unified memory voor het systeem, dus reken erop dat de GPU het grootste deel gebruikt, niet alles. Kies een configuratie met wat ruimte boven de modelgrootte.
€ 3.999
Beelink
Beelink GTR9 Pro
- 128 GB unified
- AMD Ryzen AI Max+ 395
Draait tot 120B+ op 4-bit
Onder Windows kun je de GPU maximaal 96 GB van de 128 GB toewijzen. Controleer vóór je aankoop of het model dat je wilt draaien daarin past.
€ 4.349Een goedkopere machine volstaat als je werk met de kleine modellen af kan. Samenvatten, chatten, code aanvullen en zoeken in je eigen documenten werkt allemaal met modellen van 7–14B, en die passen in 16 GB. De modelgids laat voor elk product dat we verkopen zien wat past.
Veelgestelde vragen
Kan ik een 70B-model draaien op een videokaart met 32 GB?
Niet echt prettig. Op 4-bit heeft het ongeveer 42 GB nodig. Tools kunnen een deel van het model naar het systeemgeheugen verplaatsen, maar dat deel draait veel trager. Reken voor 70B op twee kaarten met 24 GB, één kaart met 48 GB of een machine met unified memory van 64 GB of meer.
Telt het systeemgeheugen van mijn pc mee?
Op een pc met een videokaart draait alleen het geheugen van de kaart op volle snelheid. Sommige tools kunnen een deel van een model in het systeemgeheugen plaatsen, maar dat kost veel snelheid. Op machines met unified memory is de gedeelde pool het geheugen dat de GPU gebruikt.
Hoeveel extra geheugen hebben lange documenten nodig?
Het contextgeheugen groeit mee met de lengte, dus reken op wat ruimte boven de waarden in de tabel. Kies voor lange documenten of lange chats de volgende geheugengrootte, niet de grootte waarin het model maar net past.
Is 8-bit twee keer zoveel geheugen waard?
Voor algemene chat draaien de meeste mensen op 4-bit en is het kwaliteitsverlies klein. Voor programmeren of het nauwkeurig uitlezen van gegevens is 8-bit de moeite waard als je het geheugen hebt.
Producten bij dit onderwerp: Hardware voor lokale AI · Videokaarten · Apple
Gerelateerde gidsen
Lokale AI · 5 min lezen
Mac, NVIDIA of Ryzen AI Max+ voor lokale AI
Mac, NVIDIA of Ryzen AI Max+? CUDA op NVIDIA, unified memory op een Mac of 128 GB in een mini-pc. Geheugen, software en afwegingen per soort werk.
Lees de gids →Videokaarten · 5 min lezen
GPU voor lokale AI kiezen: RTX 5090, R9700, B60
Kies een GPU voor lokale AI op basis van geheugen, software en bandbreedte: RTX 5090, Radeon AI PRO R9700, Arc Pro B60 en pro-kaarten met 48 en 96 GB.
Lees de gids →Lokale AI · 4 min lezen
DGX Spark vs Mac Studio: voor wie is de Spark?
DGX Spark vs Mac Studio: is de Spark het waard? Waar hij goed in is, waar hij trager is en hoe hij scoort tegen RTX 5090 en RTX PRO 6000 voor lokale AI.
Lees de gids →