Mac, NVIDIA of Ryzen AI Max+ voor lokale AI
Bijgewerkt op 17 november 2026 · 5 min lezen
Kies NVIDIA als je tools CUDA nodig hebben of als je de hoogste snelheid wilt op modellen die in 24–32 GB passen. Kies een Mac als je grote modellen wilt draaien in een vrijwel stille behuizing met weinig instelwerk. Kies een Ryzen AI Max+ mini-pc als je 128 GB geheugen wilt op een machine met Windows of Linux. De DGX Spark zit er tussenin: 128 GB en CUDA, gemaakt voor ontwikkelaars.
De drie platforms in één oogopslag#
| NVIDIA-videokaart | Apple Mac | Ryzen AI Max+ mini-pc | |
|---|---|---|---|
| Geheugen voor modellen | 32 GB (RTX 5090), 96 GB (RTX PRO 6000) | 24 GB (basismodel Mac mini) tot 96 GB en meer (Mac Studio) | 128 GB gedeeld; tot 96 GB voor de GPU onder Windows, meer onder Linux |
| Software | CUDA, de breedste ondersteuning | Metal en MLX | ROCm en Vulkan |
| Besturingssysteem | Windows of Linux | macOS | Windows of Linux |
| Formaat en geluid | Een tower-pc; alleen de RTX 5090 verbruikt al tot 575 W | Compact en vrijwel geruisloos | Een kleine desktopbehuizing |
| Geschikt voor | CUDA-werk, maximale snelheid bij modellen die passen, gaming | Grote modellen zonder gedoe, creatief werk | 70B- en 120B-modellen op een pc |
NVIDIA: de standaardkeuze als de software beslist#
De meeste AI-onderzoekscode, trainingsscripts en serving-tools zijn in de eerste plaats op CUDA gericht. Doe je aan fine-tuning, volg je nieuwe papers of gebruik je tools die CUDA vereisen, dan bespaart een NVIDIA-kaart je tijd.
De grens is het geheugen per kaart. De RTX 5090 heeft 32 GB: genoeg om 30B-modellen op 4-bit soepel te draaien, maar niet voor een 70B-model op één kaart. Daarboven heb je twee kaarten nodig of de RTX PRO 6000 met 96 GB, die in zijn eentje een 70B-model op 8-bit kan laden.
Daar staat snelheid tegenover: beide kaarten halen 1.792 GB/s geheugenbandbreedte, dus modellen die passen genereren snel tekst. De keerzijde is stroomverbruik en ruimte. NVIDIA adviseert een voeding van 1.000 W voor de RTX 5090; in onze inbouwgids lees je de rest.
Mac: veel geheugen, weinig geluid#
Apple silicon werkt met unified memory waar de GPU rechtstreeks uit put. De Mac Studio met M3 Ultra heeft standaard 96 GB, met 256 GB als bestelbare optie, en 819 GB/s bandbreedte. Daarmee draaien grote taalmodellen snel terwijl de machine vrijwel stil blijft.
llama.cpp, Ollama en LM Studio draaien native op een Mac via Metal, en Apples MLX-framework is speciaal voor deze hardware gemaakt. CUDA is er niet, dus tools die het vereisen werken niet. Fine-tuning kan in MLX, maar de meeste trainingscode wordt eerst voor CUDA geschreven.
Het geheugen kun je later niet uitbreiden. De Mac mini met M4 Pro begint bij 24 GB, waarmee ongeveer 14B het comfortabele maximum is. Is lokale AI je doel, kies dan bij aankoop 48 GB of 64 GB.
Ryzen AI Max+: 128 GB in een pc#
De Ryzen AI Max+ 395 combineert een CPU met 16 cores met de geïntegreerde Radeon 8060S-GPU en 128 GB LPDDR5X unified memory. Dat is genoeg voor een 70B-model op 8-bit of een 120B-model op 4-bit, in een kleine behuizing waarop je gewone Windows- of Linux-software draait.
Onder Windows kan de GPU maximaal 96 GB van de 128 GB krijgen; onder Linux kun je meer toewijzen, dus kies Linux als je de grootste modellen wilt draaien. llama.cpp draait op deze chip via Vulkan of ROCm, en de ROCm-ondersteuning hangt af van de versie die je installeert. Controleer of je andere tools de chip ondersteunen voordat je de knoop doorhakt.
In Ryzen AI Max+ 395 mini-pc's vergeleken zetten we de twee machines die we verkopen naast elkaar.
Waar de DGX Spark past#
De DGX Spark heeft dezelfde 128 GB als een Ryzen AI Max+-machine, met CUDA en de softwarestack van NVIDIA. De geheugenbandbreedte is 273 GB/s, dus het is in de eerste plaats een ontwikkelmachine en pas daarna een snelle chatbox. Lees meer in onze DGX Spark-gids.
Wat kies je?#
- Je tools vereisen CUDA, of je gamet ook: een NVIDIA-videokaart.
- Je wilt het grootste model in de stilste behuizing en macOS bevalt je prima: een Mac Studio.
- Je wilt 128 GB onder Windows of Linux in een kleine behuizing: een Ryzen AI Max+ mini-pc.
- Je ontwikkelt op CUDA en rolt uit op grotere NVIDIA-systemen: de DGX Spark.
- Je modellen zijn 14B of kleiner: dan is elk van deze opties meer dan je nodig hebt. Een Mac mini met 24 GB of een kaart met 16 GB volstaat.

NVIDIA
NVIDIA GeForce RTX 5090
- 32 GB
- NVIDIA Blackwell (GB202)
Draait tot 30–34B op 4-bit
Met 32 GB draai je modellen van de 30B-klasse probleemloos op 4-bit, maar een 70B-model past niet op één kaart. Reken voor 70B op twee kaarten of een systeem met veel unified memory.
€ 1.999
Apple
Apple Mac Studio (M3 Ultra)
- 96 GB unified
- 60 cores; optie met 80 cores
Draait tot 70B op 4-bit
macOS reserveert een deel van de unified memory voor het systeem, dus reken erop dat de GPU het grootste deel gebruikt, niet alles. Kies een configuratie met wat ruimte boven de modelgrootte.
€ 3.999
Beelink
Beelink GTR9 Pro
- 128 GB unified
- AMD Ryzen AI Max+ 395
Draait tot 120B+ op 4-bit
Onder Windows kun je de GPU maximaal 96 GB van de 128 GB toewijzen. Controleer vóór je aankoop of het model dat je wilt draaien daarin past.
€ 4.349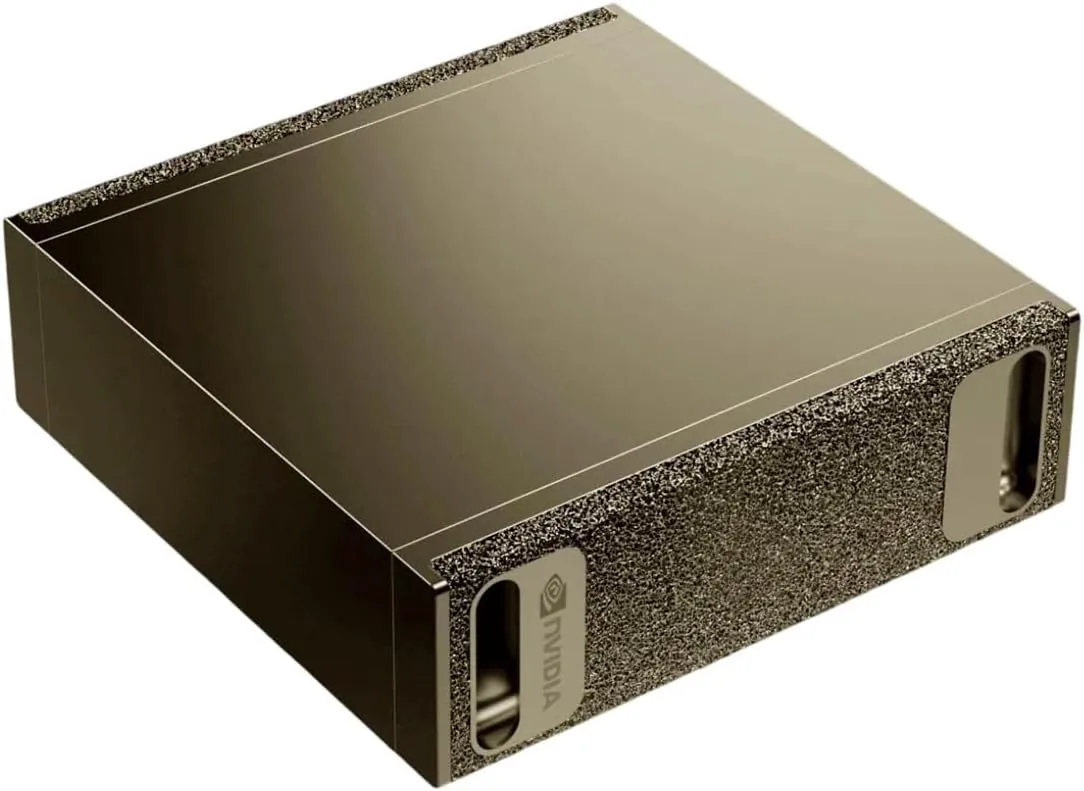
NVIDIA
NVIDIA DGX Spark
- 128 GB unified
- NVIDIA GB10 Grace Blackwell
Draait tot 120B+ op 4-bit
De geheugenbandbreedte (273 GB/s) is lager dan die van een high-end videokaart, dus grote dense modellen genereren tekst langzamer dan op een RTX 5090. De sterke punten zijn de capaciteit en de CUDA-softwarestack.
€ 4.699Veelgestelde vragen
Kan een Mac CUDA-software draaien?
Nee. CUDA draait alleen op NVIDIA-hardware. De meeste populaire tools voor lokale AI, waaronder llama.cpp, Ollama en LM Studio, draaien native op een Mac, maar tools die CUDA vereisen niet.
Is AMD lastiger in te richten voor lokale AI?
Het vraagt meer controle vooraf. PyTorch en llama.cpp ondersteunen ROCm, en llama.cpp draait ook via Vulkan, maar sommige nichetools gaan nog steeds uit van CUDA. Controleer je tools en je besturingssysteem voordat je koopt.
Welk platform is het stilst?
Macs zijn vrijwel geruisloos en verbruiken weinig stroom. Ryzen AI Max+-machines zijn kleine desktopkastjes. Een tower met een high-end videokaart is van de drie het luidst en verbruikt de meeste stroom.
Welke kan het grootste model aan?
Van de losse machines die we verkopen, kunnen de Ryzen AI Max+ mini-pc's met 128 GB, de DGX Spark en de RTX PRO 6000 met 96 GB allemaal 120B-modellen op 4-bit laden. Mac Studio-configuraties met meer dan 96 GB ook.
Producten bij dit onderwerp: Apple · Mini-pc's · Hardware voor lokale AI
Gerelateerde gidsen
Lokale AI · 5 min lezen
Hoeveel geheugen heb je nodig voor een lokaal LLM?
Hoeveel geheugen een lokaal LLM nodig heeft: 7B- tot 120B+-modellen op 4-bit en 8-bit, unified memory vs. VRAM, en welke machines welke grootte aankunnen.
Lees de gids →Mini-pc's · 4 min lezen
Ryzen AI Max+ 395 mini-pc's vergeleken
Ryzen AI Max+ 395 mini-pc's vergeleken: Beelink GTR9 Pro of Minisforum MS-S1 Max, 128 GB unified memory, poorten, uitbreiding en welke modellen ze draaien.
Lees de gids →Lokale AI · 4 min lezen
DGX Spark vs Mac Studio: voor wie is de Spark?
DGX Spark vs Mac Studio: is de Spark het waard? Waar hij goed in is, waar hij trager is en hoe hij scoort tegen RTX 5090 en RTX PRO 6000 voor lokale AI.
Lees de gids →