Categorie
AI-acceleratorkaarten en desktops om modellen te bouwen
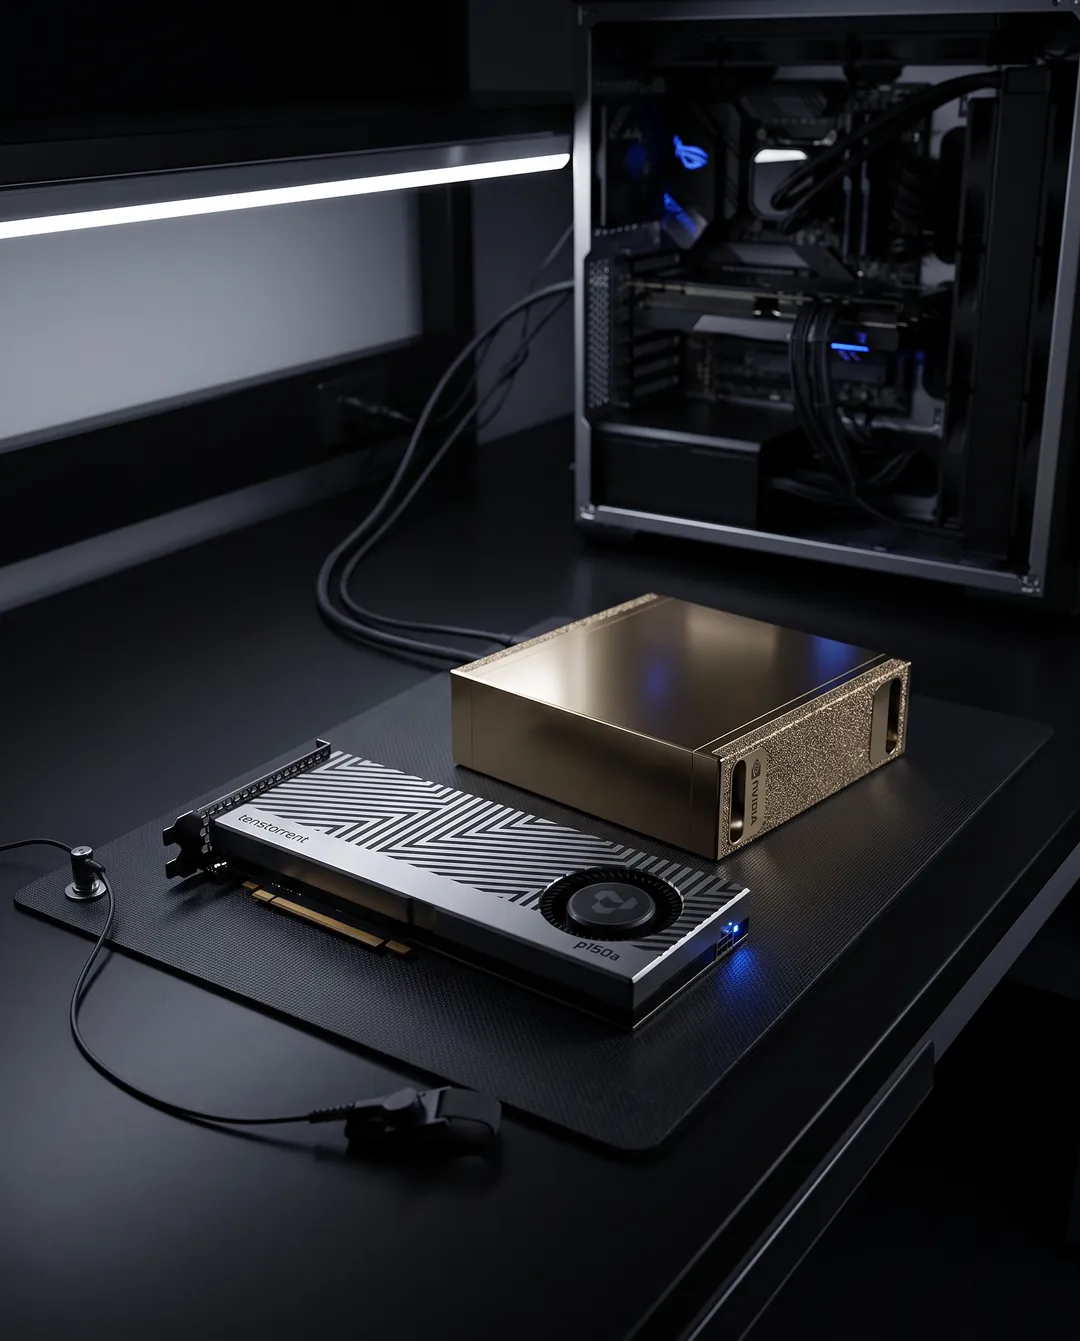
AI-acceleratorkaarten en desktops die in de eerste plaats voor AI zijn gebouwd: Tenstorrent-kaarten met een opensource-softwarestack en de NVIDIA DGX Spark-desktop.
Kies een AI-accelerator in de eerste plaats op de software. De NVIDIA DGX Spark is een CUDA-ontwikkelmachine met 128 GB, en code die je erop schrijft, neem je mee naar grotere DGX-systemen en de cloud; de Tenstorrent-kaarten werken met een volledig opensourcestack die je tot op kernelniveau kunt programmeren. Wil je vooral grote modellen snel draaien in plaats van ze te bouwen, dan past een Mac Studio of een videokaart vaak beter.
Onze keuzes
CUDA-ontwikkeling met 128 GB
DGX Spark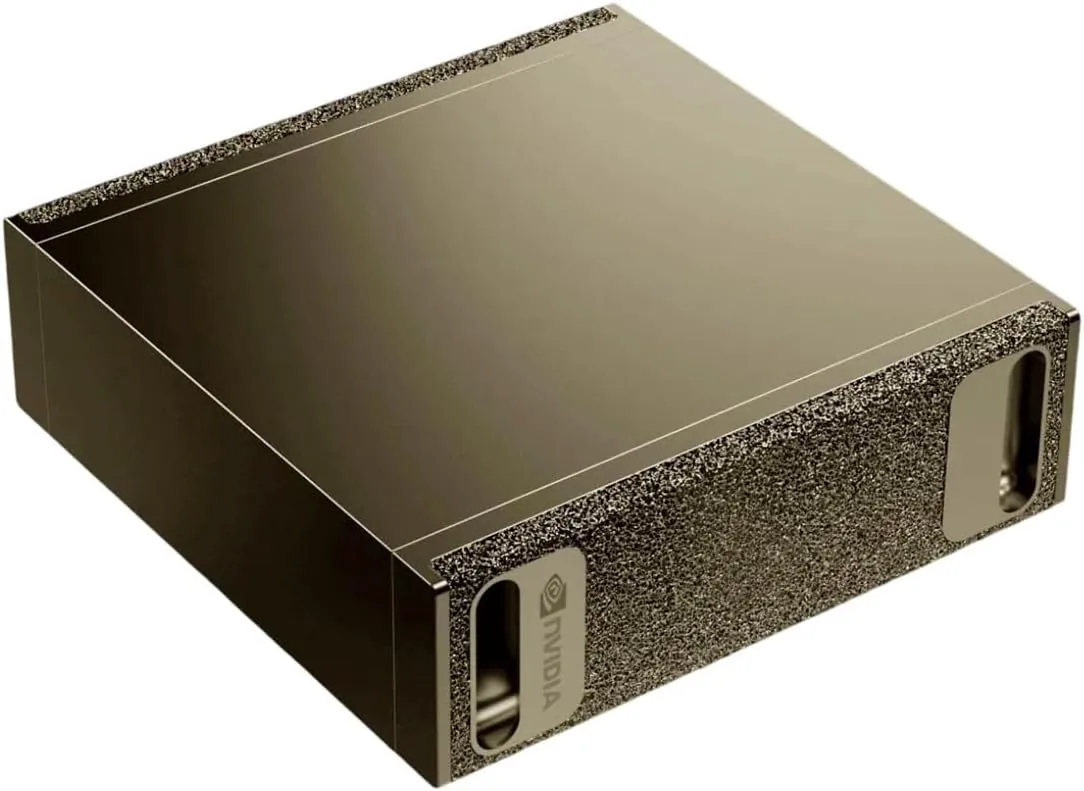
NVIDIA
NVIDIA DGX Spark
- 128 GB unified
- NVIDIA GB10 Grace Blackwell
Draait tot 120B+ op 4-bit
De geheugenbandbreedte (273 GB/s) is lager dan die van een high-end videokaart, dus grote dense modellen genereren tekst langzamer dan op een RTX 5090. De sterke punten zijn de capaciteit en de CUDA-softwarestack.
€ 4.699Een vierkante desktopbox van 150 mm met de softwarestack van NVIDIA, om te prototypen en te fine-tunen voordat je overstapt op grotere NVIDIA-hardware.
Meeste geheugen op een kaart met open stack
Tenstorrent Blackhole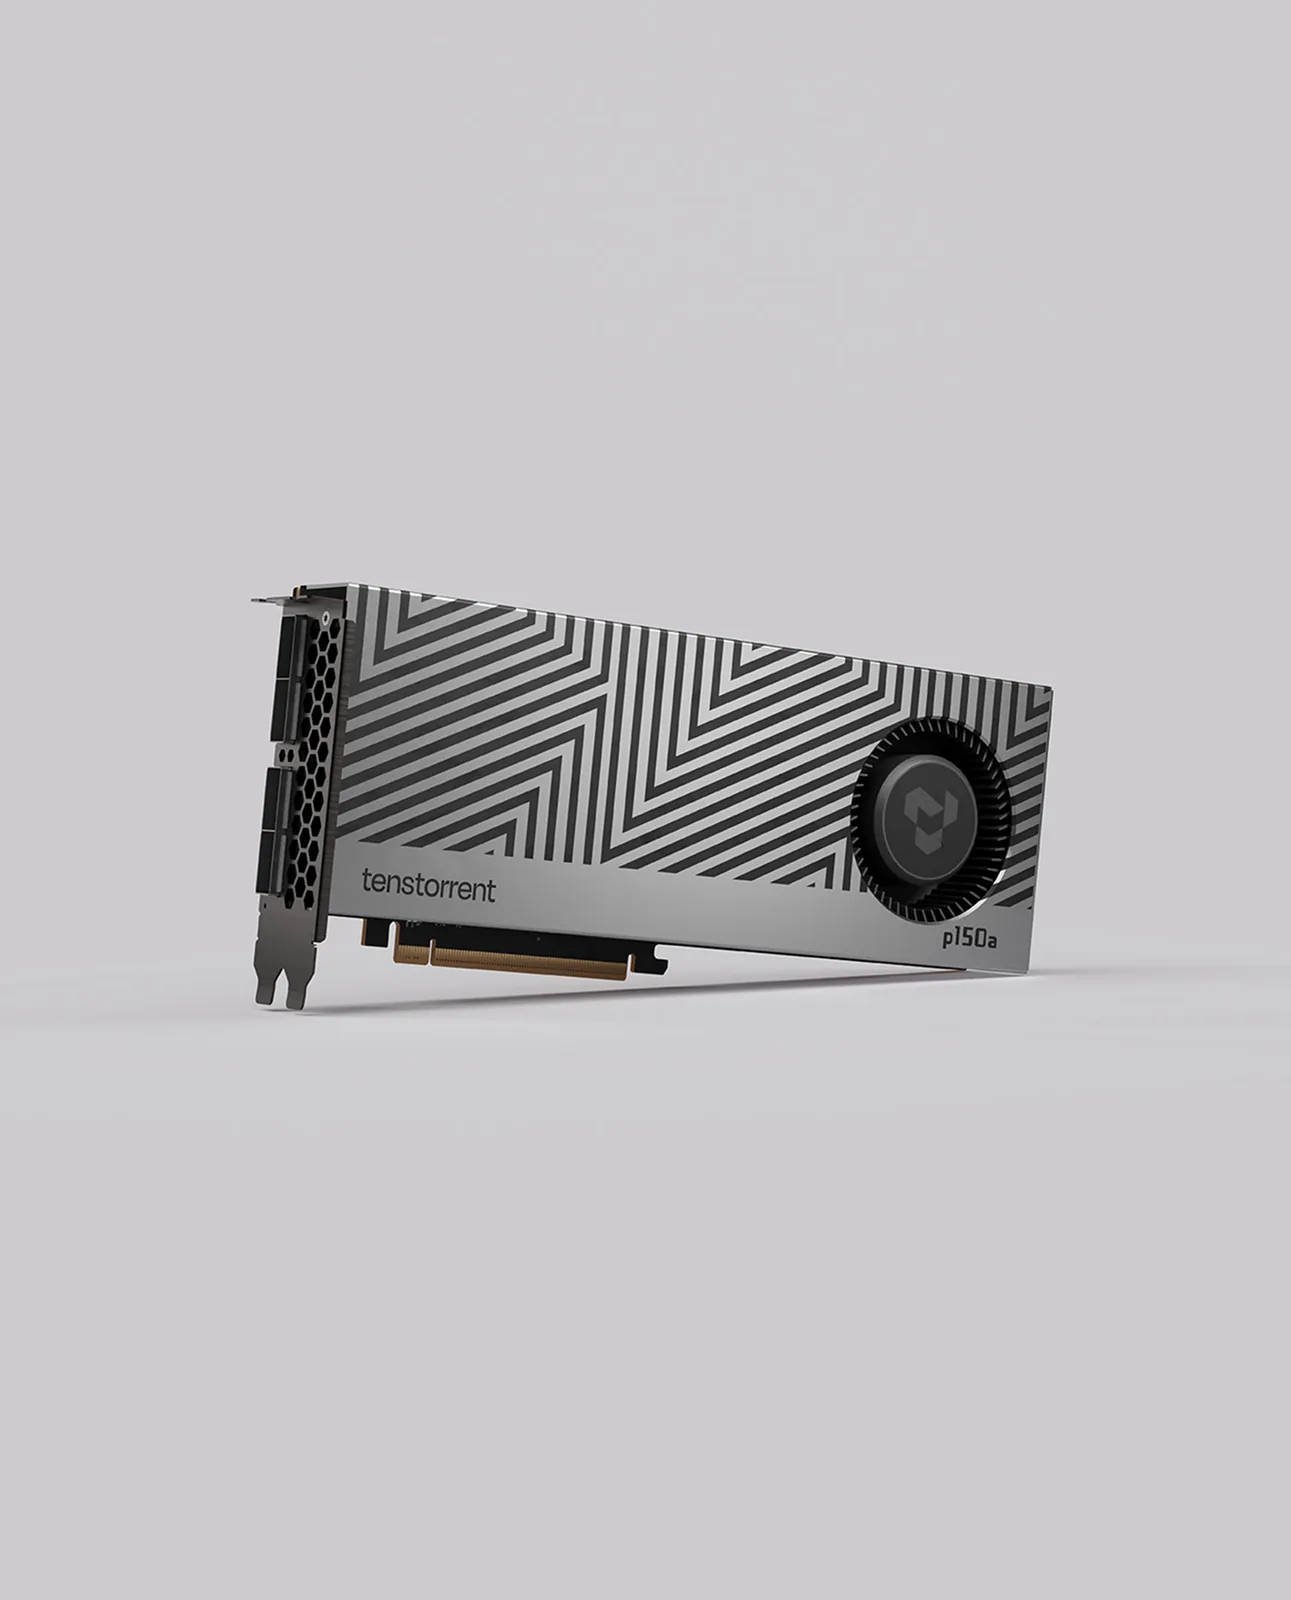
Tenstorrent
Tenstorrent Blackhole p150a
- 32 GB
- Tenstorrent Blackhole
Draait tot 30–34B op 4-bit
Dit is geen CUDA-kaart. Controleer voor aankoop of de modellen die je nodig hebt worden ondersteund in de opensource-modelbibliotheek van Tenstorrent.
€ 1.39932 GB GDDR6, 120 Tensix-cores en vier 800G-poorten om kaarten te koppelen, met software die je kunt inzien en aanpassen.
Instapmodel van Tenstorrent
Tenstorrent Wormhole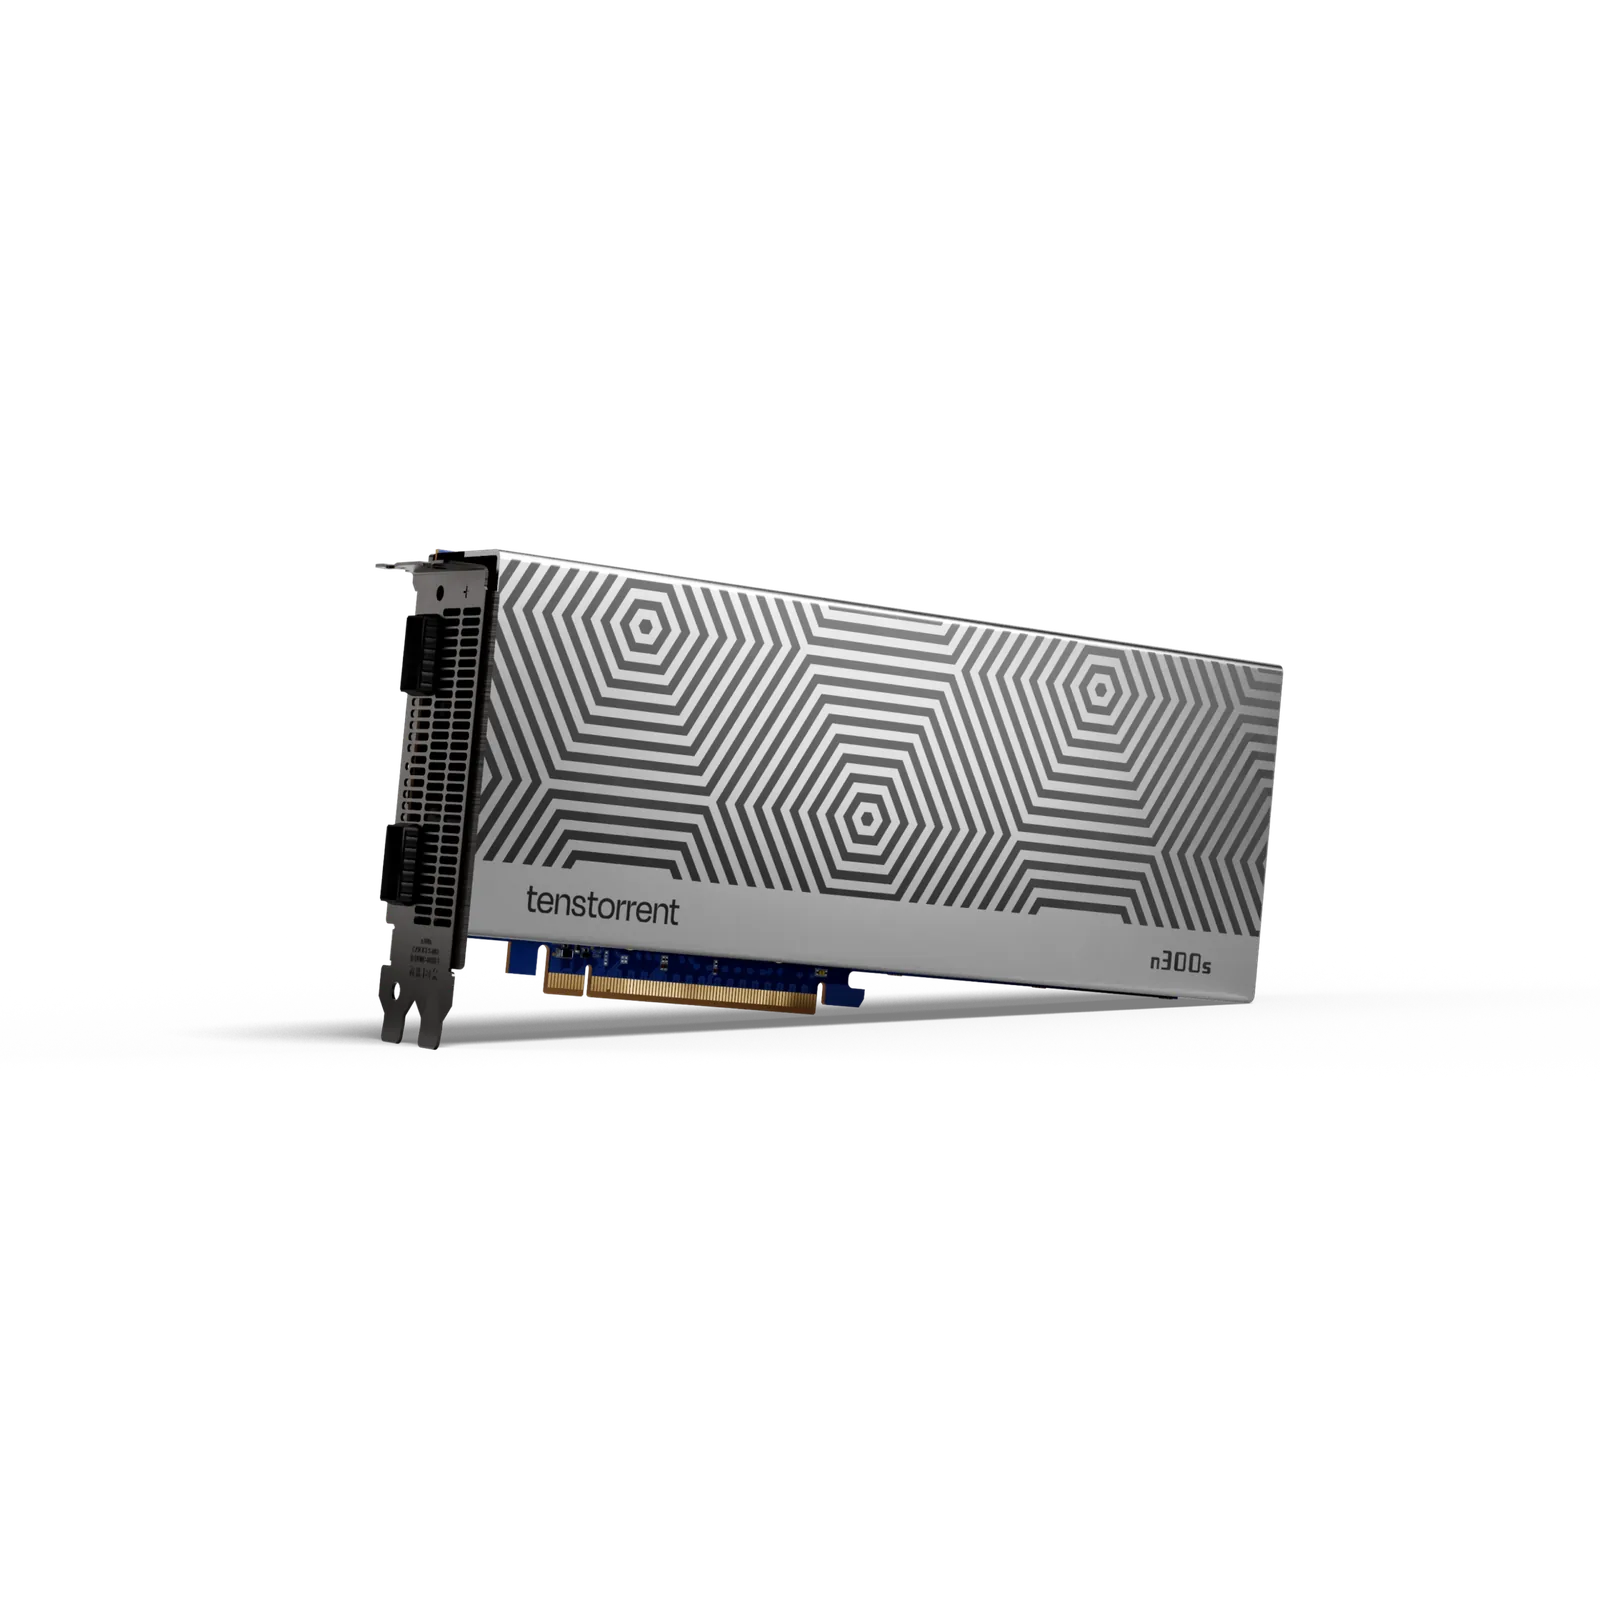
Tenstorrent
Tenstorrent Wormhole n300s
- 24 GB
Draait tot 30–34B op 4-bit
De 24 GB is verdeeld over twee chips (12 GB per chip), dus grotere modellen moeten over beide worden verdeeld. Controleer of er voor het model dat je wilt een werkende multi-chipversie bestaat.
€ 1.399Twee Wormhole-chips en 24 GB op één kaart, met dezelfde opensourcesoftware als Blackhole, om de stack te leren kennen en erop te bouwen.
NVIDIA
NVIDIA DGX Spark
- 128 GB unified
- NVIDIA GB10 Grace Blackwell
Draait tot 120B+ op 4-bit
De geheugenbandbreedte (273 GB/s) is lager dan die van een high-end videokaart, dus grote dense modellen genereren tekst langzamer dan op een RTX 5090. De sterke punten zijn de capaciteit en de CUDA-softwarestack.
€ 4.699Tenstorrent
Tenstorrent Blackhole p150a
- 32 GB
- Tenstorrent Blackhole
Draait tot 30–34B op 4-bit
Dit is geen CUDA-kaart. Controleer voor aankoop of de modellen die je nodig hebt worden ondersteund in de opensource-modelbibliotheek van Tenstorrent.
€ 1.399Tenstorrent
Tenstorrent Wormhole n300s
- 24 GB
Draait tot 30–34B op 4-bit
De 24 GB is verdeeld over twee chips (12 GB per chip), dus grotere modellen moeten over beide worden verdeeld. Controleer of er voor het model dat je wilt een werkende multi-chipversie bestaat.
€ 1.399Zo kies je een AI-accelerator
- CUDA of open source
- De DGX Spark wordt geleverd met de AI-softwarestack van NVIDIA, dus code die je erop schrijft, zet je met weinig aanpassingen over naar grotere DGX-systemen. Tenstorrent-kaarten draaien TT-Metalium en TT-Forge, open source van de low-level kernels tot en met de modelcompiler. Het zijn geen CUDA-kaarten.
- Controleer eerst de modelondersteuning
- Controleer voordat je een Tenstorrent-kaart koopt of de modellen die je nodig hebt in de opensource-modelbibliotheek van Tenstorrent staan. Op de Wormhole n300 is de 24 GB verdeeld in 12 GB per chip, dus voor grotere modellen is een werkende multichipversie nodig.
- Het geheugen bepaalt de bovengrens
- Volgens de rekenregel van onze modelgids past in de 128 GB unified memory van de Spark een 70B-model op 8-bit of een model uit de 120B-klasse op 4-bit. De Blackhole p150a heeft 32 GB GDDR6 met 512 GB/s, genoeg geheugen voor een model uit de 30B-klasse op 4-bit, mits de bibliotheek het ondersteunt.
- Capaciteit is geen snelheid
- De geheugenbandbreedte van de Spark is 273 GB/s, tegenover 1.792 GB/s bij een RTX 5090. Grote dense modellen genereren er trager tekst op; mixture-of-experts-modellen, die per token maar een deel van hun gewichten lezen, merken het verschil minder.
- Houd rekening met opschalen
- Twee DGX Sparks koppel je via de ingebouwde ConnectX-7-netwerkaansluiting op 200 Gb/s. De p150a heeft vier QSFP-DD 800G-poorten en de n300 twee QSFP-DD-poorten om kaarten aan elkaar te koppelen. Elke Tenstorrent-kaart verbruikt 300 W en heeft een PCIe x16-slot nodig, dus houd rekening met de voeding en de luchtstroom van het hostsysteem.
Veelgestelde vragen
Kan ik beter een AI-accelerator of een videokaart kopen?
Een accelerator koop je om de software: de DGX Spark voor CUDA-ontwikkeling met 128 GB, een Tenstorrent-kaart voor een open stack. Wil je de hoogste snelheid bij modellen tot ongeveer 30B, of game je ook, dan is een videokaart zoals de RTX 5090 de betere keuze.
Draait mijn CUDA-code op een Tenstorrent-kaart?
Nee. Tenstorrent-kaarten draaien hun eigen opensourcestack, TT-Metalium en TT-Forge. Controleer vóór aankoop of jouw modellen in de modelbibliotheek van Tenstorrent worden ondersteund.
Kan de DGX Spark Windows of games draaien?
Nee. Hij draait NVIDIA DGX OS, een Linux-systeem op basis van Ubuntu, op een Arm-cpu. Software die alleen voor x86-Windows is gemaakt, werkt niet, en het is geen gamemachine.
Kan ik modellen fine-tunen op de DGX Spark?
Ja. Fine-tuning vraagt meer geheugen dan een model draaien, en parameter-efficiënte methoden zoals LoRA verlagen die behoefte flink. De 128 GB van de Spark biedt daar ruimte voor bij modelgroottes die een kaart met 32 GB niet haalt.
Gerelateerde pagina's: Hardware voor lokale AI · Apple
Gidsen
Lokale AI · 4 min lezen
DGX Spark vs Mac Studio: voor wie is de Spark?
DGX Spark vs Mac Studio: is de Spark het waard? Waar hij goed in is, waar hij trager is en hoe hij scoort tegen RTX 5090 en RTX PRO 6000 voor lokale AI.
Lees de gids →Lokale AI · 5 min lezen
Mac, NVIDIA of Ryzen AI Max+ voor lokale AI
Mac, NVIDIA of Ryzen AI Max+? CUDA op NVIDIA, unified memory op een Mac of 128 GB in een mini-pc. Geheugen, software en afwegingen per soort werk.
Lees de gids →Lokale AI · 5 min lezen
Hoeveel geheugen heb je nodig voor een lokaal LLM?
Hoeveel geheugen een lokaal LLM nodig heeft: 7B- tot 120B+-modellen op 4-bit en 8-bit, unified memory vs. VRAM, en welke machines welke grootte aankunnen.
Lees de gids →