Kies op gebruik
AI-workstation voor lokale LLM's: welke machine draait welk model
Draai taal- en beeldmodellen op je eigen AI-workstation: privé, offline en zonder maandelijkse kosten.
Kooptip: Het geheugen bepaalt welke modellen passen. Snelheid komt op de tweede plaats. Kijk eerst naar de modelgrootte en kies dan de machine.
Het geheugen bepaalt welke modellen je kunt draaien; snelheid komt op de tweede plaats. Een 7–8B-model op 4-bit past in ongeveer 6 GB, een 70B-model in ongeveer 42 GB en een model uit de 120B-klasse in ongeveer 80 GB. Ga dus uit van het grootste model dat je wilt draaien en kies een machine met genoeg bruikbaar geheugen. Kies daarna het softwareplatform: CUDA bij NVIDIA, Metal en MLX op een Mac, of ROCm en Vulkan bij AMD.
Onze keuzes
Modellen van 70B en uit de 120B-klasse in één kleine behuizing
Ryzen AI Max+ 395
Beelink
Beelink GTR9 Pro
- 128 GB unified
- AMD Ryzen AI Max+ 395
Draait tot 120B+ op 4-bit
Onder Windows kun je de GPU maximaal 96 GB van de 128 GB toewijzen. Controleer vóór je aankoop of het model dat je wilt draaien daarin past.
€ 4.349128 GB unified memory, waarvan ongeveer 96 GB voor modellen, onder Windows of Linux; kies Linux als je de GPU zoveel mogelijk geheugen wilt geven.
Hoogste snelheid bij modellen tot 30B
GeForce RTX 5090
NVIDIA
NVIDIA GeForce RTX 5090
- 32 GB
- NVIDIA Blackwell (GB202)
Draait tot 30–34B op 4-bit
Met 32 GB draai je modellen van de 30B-klasse probleemloos op 4-bit, maar een 70B-model past niet op één kaart. Reken voor 70B op twee kaarten of een systeem met veel unified memory.
€ 1.99932 GB GDDR7 met 1.792 GB/s en CUDA. Een 70B-model past niet op één kaart.
Grote modellen, vrijwel geruisloos
Mac Studio M3 Ultra
Apple
Apple Mac Studio (M3 Ultra)
- 96 GB unified
- 60 cores; optie met 80 cores
Draait tot 70B op 4-bit
macOS reserveert een deel van de unified memory voor het systeem, dus reken erop dat de GPU het grootste deel gebruikt, niet alles. Kies een configuratie met wat ruimte boven de modelgrootte.
€ 3.999Standaard 96 GB en 819 GB/s, dus een 70B-model op 4-bit draait vlot terwijl de machine vrijwel stil blijft.
NVIDIA
NVIDIA GeForce RTX 5090
- 32 GB
- NVIDIA Blackwell (GB202)
Draait tot 30–34B op 4-bit
Met 32 GB draai je modellen van de 30B-klasse probleemloos op 4-bit, maar een 70B-model past niet op één kaart. Reken voor 70B op twee kaarten of een systeem met veel unified memory.
€ 1.999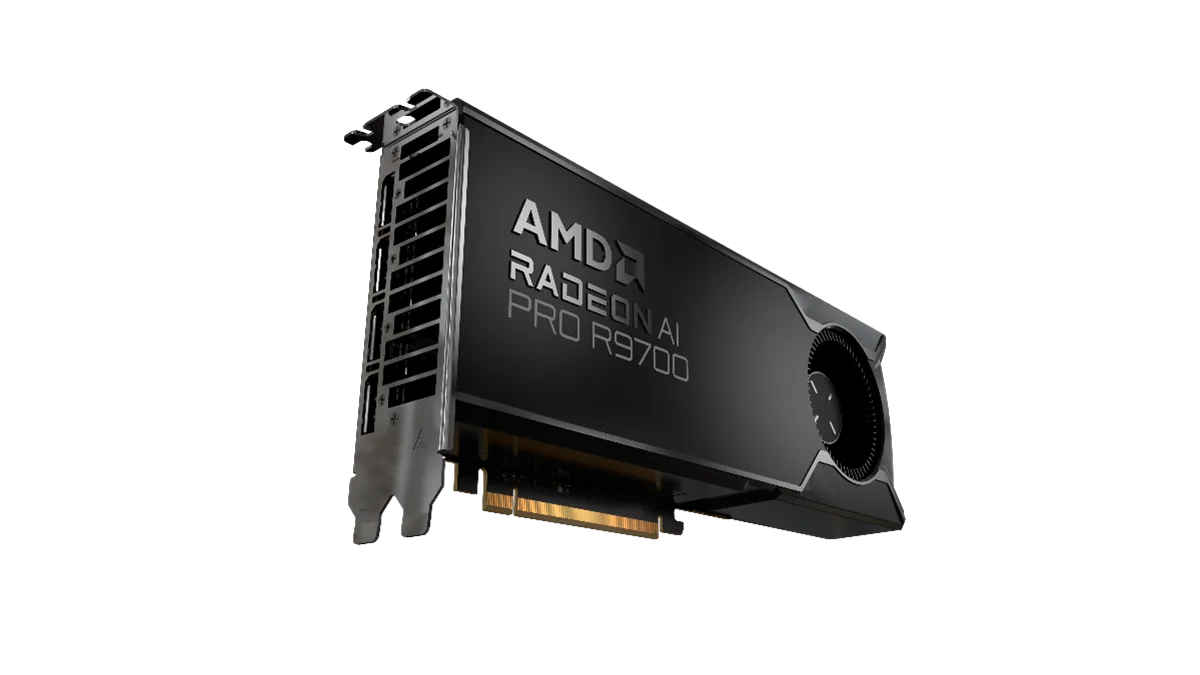
PowerColor
PowerColor AMD Radeon AI PRO R9700 32GB
- 32 GB
- AMD RDNA 4 (Navi 48)
Draait tot 30–34B op 4-bit
Controleer voor je koopt of je tools ROCm ondersteunen op je besturingssysteem. PyTorch en llama.cpp doen dat; sommige nichetools gaan nog uit van CUDA.
€ 1.299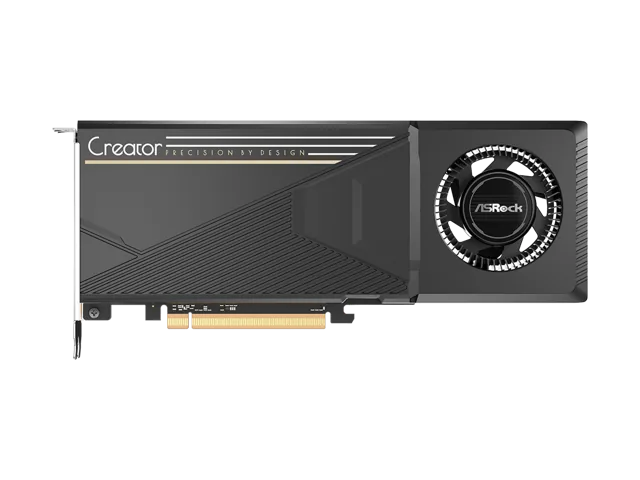
ASRock
ASRock Intel Arc Pro B60 Creator 24GB
- 24 GB
- Intel Xe2 (Battlemage)
Draait tot 30–34B op 4-bit
Dit is een kaart met één GPU en 24 GB. Hij gebruikt een PCIe 5.0-slot met x8-aansluiting en werkt ook in PCIe 4.0-slots. Controleer de specificaties van ASRock voor de exacte lengte en de voedingsaansluiting voordat je bestelt.
€ 599,99Beelink
Beelink GTR9 Pro
- 128 GB unified
- AMD Ryzen AI Max+ 395
Draait tot 120B+ op 4-bit
Onder Windows kun je de GPU maximaal 96 GB van de 128 GB toewijzen. Controleer vóór je aankoop of het model dat je wilt draaien daarin past.
€ 4.349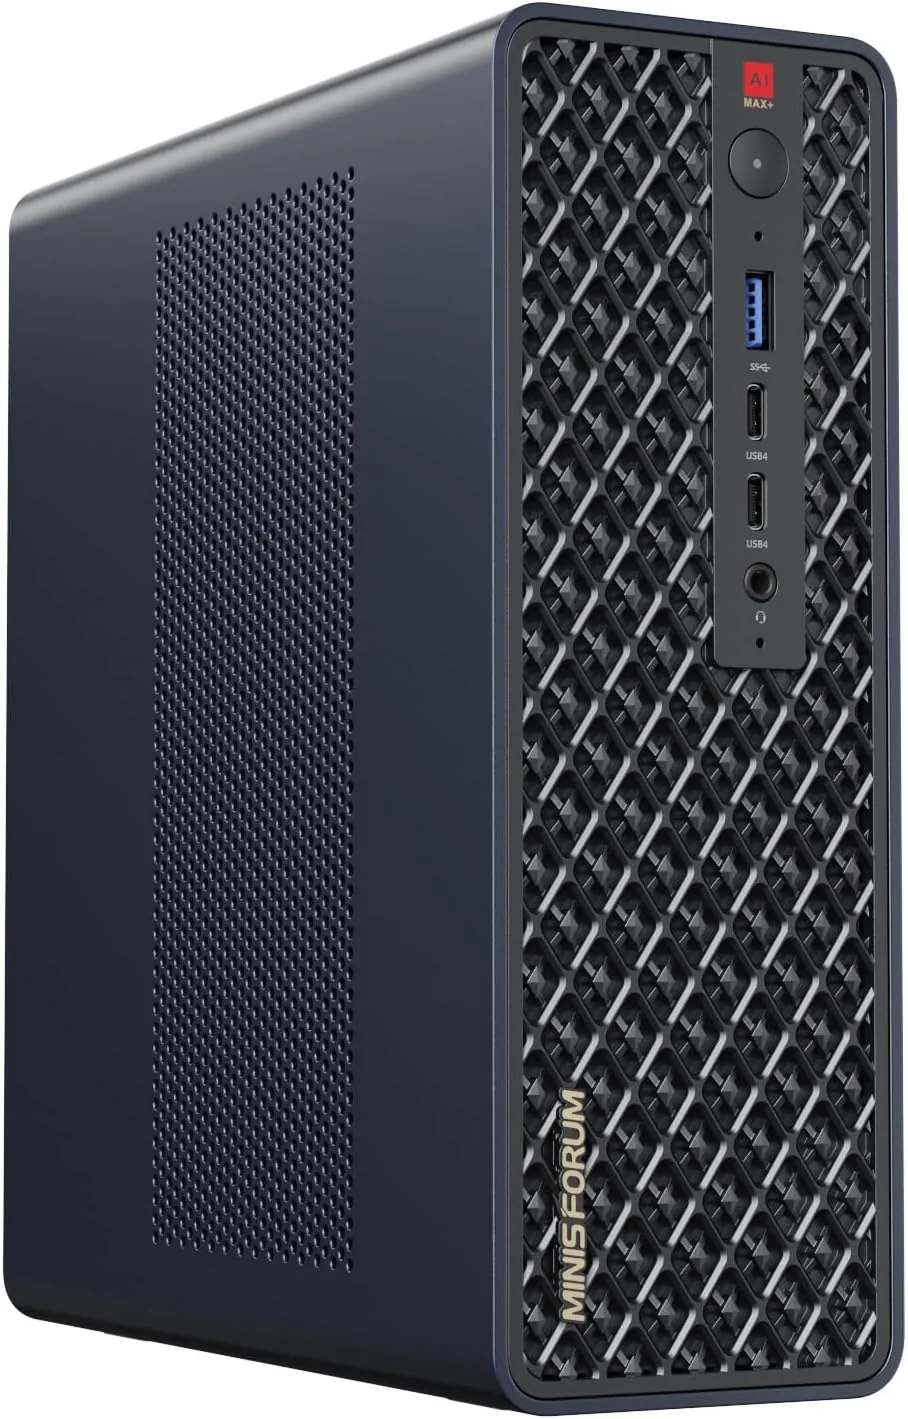
Minisforum
Minisforum MS-S1 Max
- 128 GB unified
- AMD Ryzen AI Max+ 395
Draait tot 120B+ op 4-bit
Het PCIe-slot is geschikt voor low-profile kaarten en werkt met x4 lanes. Ideaal voor een snellere netwerkkaart, niet voor een videokaart van volledige grootte.
€ 2.469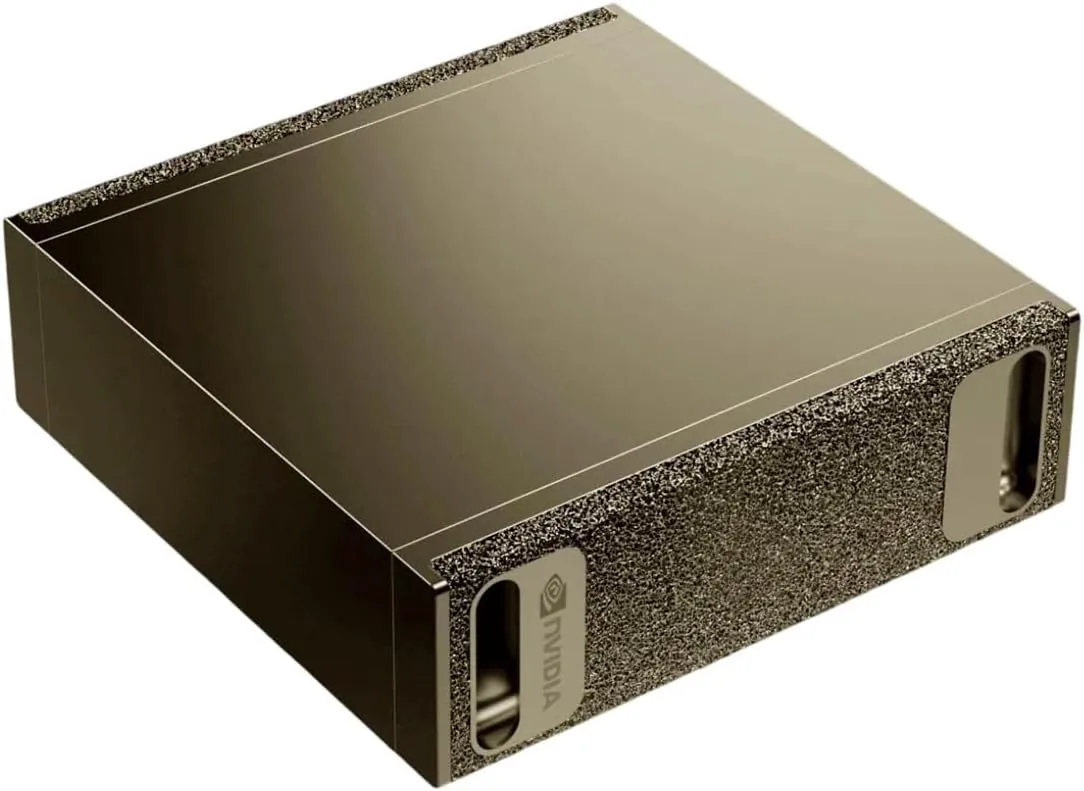
NVIDIA
NVIDIA DGX Spark
- 128 GB unified
- NVIDIA GB10 Grace Blackwell
Draait tot 120B+ op 4-bit
De geheugenbandbreedte (273 GB/s) is lager dan die van een high-end videokaart, dus grote dense modellen genereren tekst langzamer dan op een RTX 5090. De sterke punten zijn de capaciteit en de CUDA-softwarestack.
€ 4.699Apple
Apple Mac Studio (M3 Ultra)
- 96 GB unified
- 60 cores; optie met 80 cores
Draait tot 70B op 4-bit
macOS reserveert een deel van de unified memory voor het systeem, dus reken erop dat de GPU het grootste deel gebruikt, niet alles. Kies een configuratie met wat ruimte boven de modelgrootte.
€ 3.999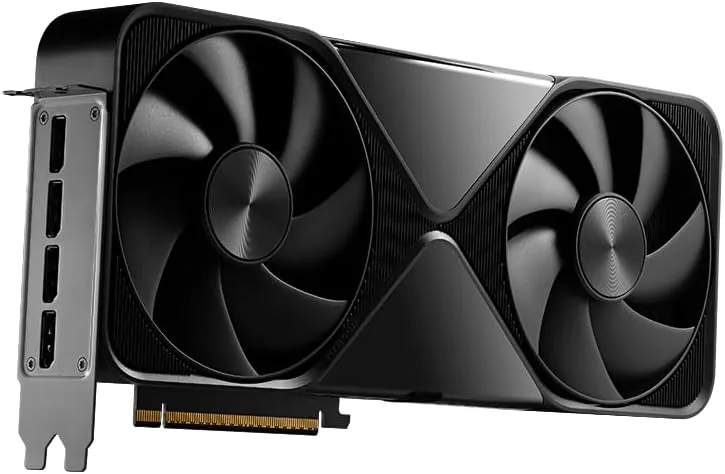
NVIDIA
NVIDIA RTX PRO 6000 Blackwell Workstation Edition (96 GB)
- 96 GB
- NVIDIA Blackwell (GB202)
Draait tot 120B+ op 4-bit
Dit is de Workstation Edition van 600 W met een dubbele flow-through-koeler. Je hebt een 16-pins stroomkabel nodig, een behuizing waarin een kaart van 12 inch past en een goede airflow.
€ 13.250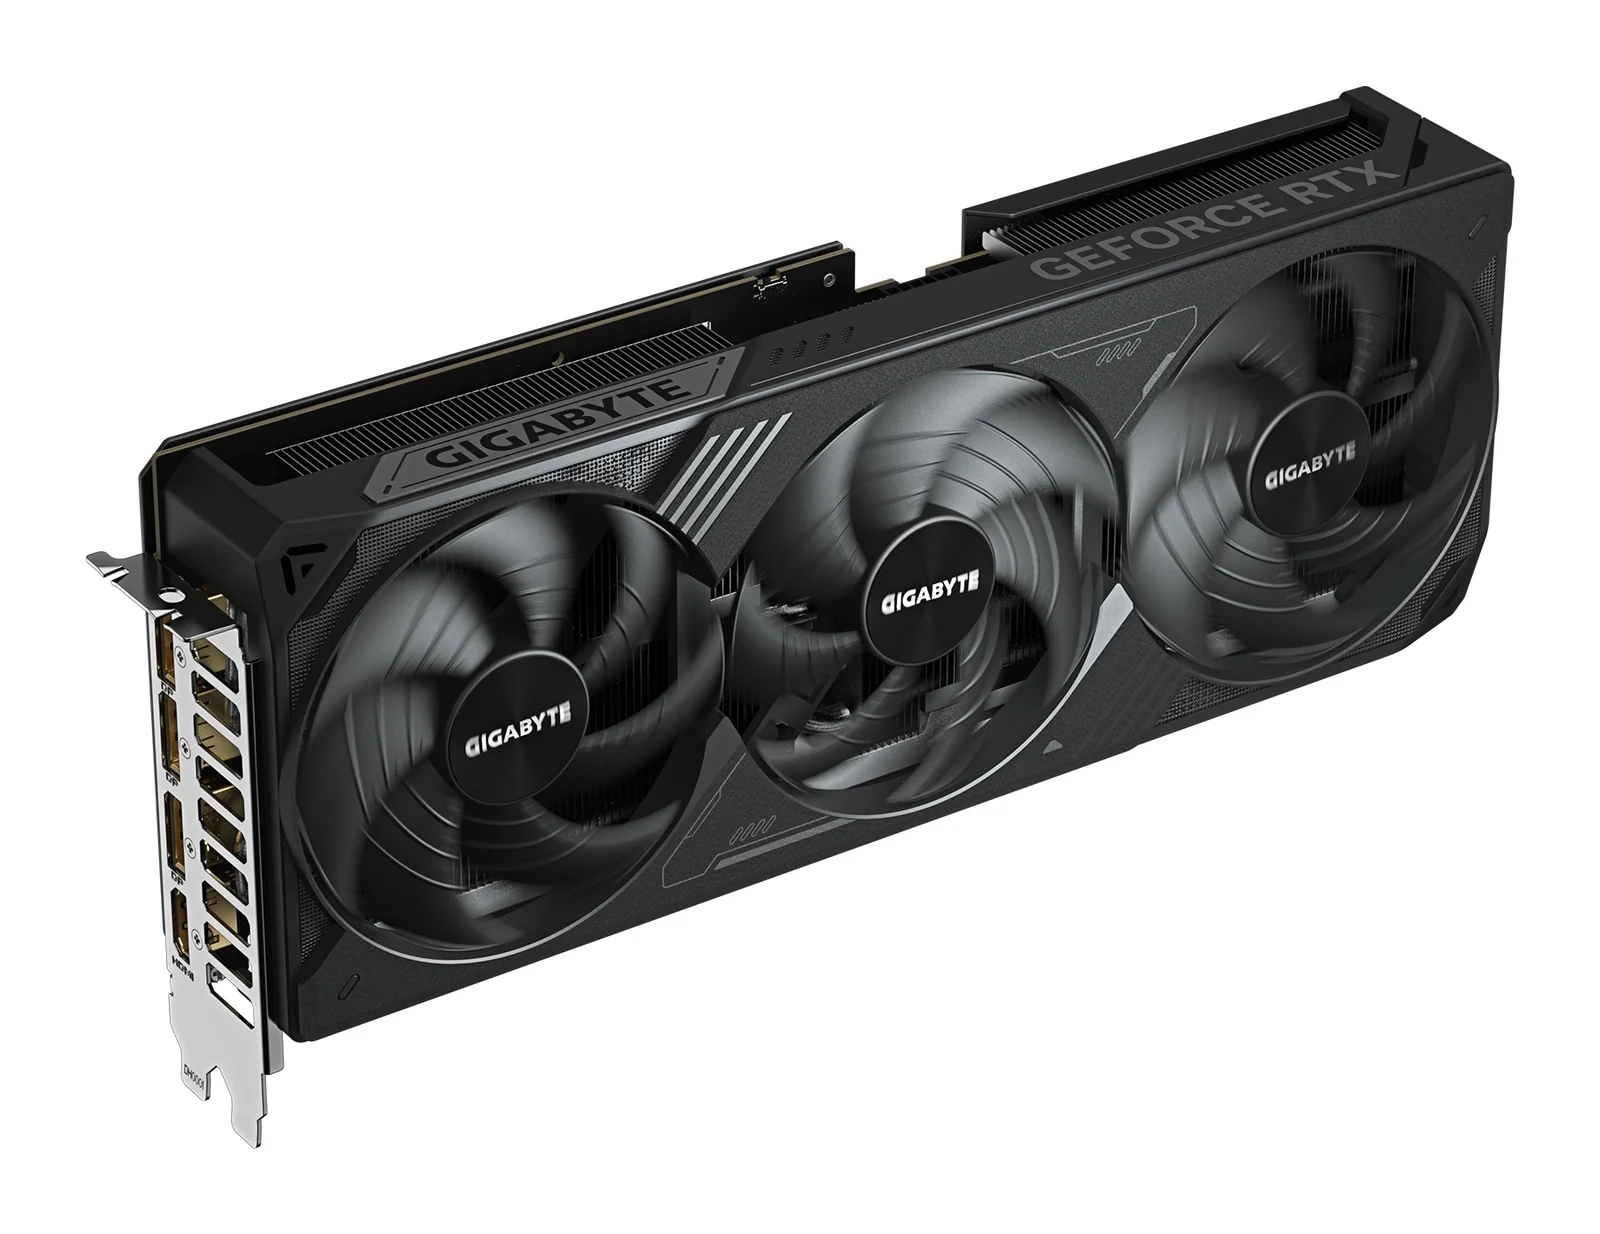
GIGABYTE
GIGABYTE GeForce RTX 5070 Ti WINDFORCE OC SFF 16G
- 16 GB
- NVIDIA GeForce RTX 5070 Ti (Blackwell)
Draait tot 13–14B op 4-bit
De kaart heeft één 16-pins voedingskabel nodig, of de meegeleverde adapter die op twee 8-pins PCIe-kabels aansluit. GIGABYTE adviseert een voeding van 750 W.
€ 849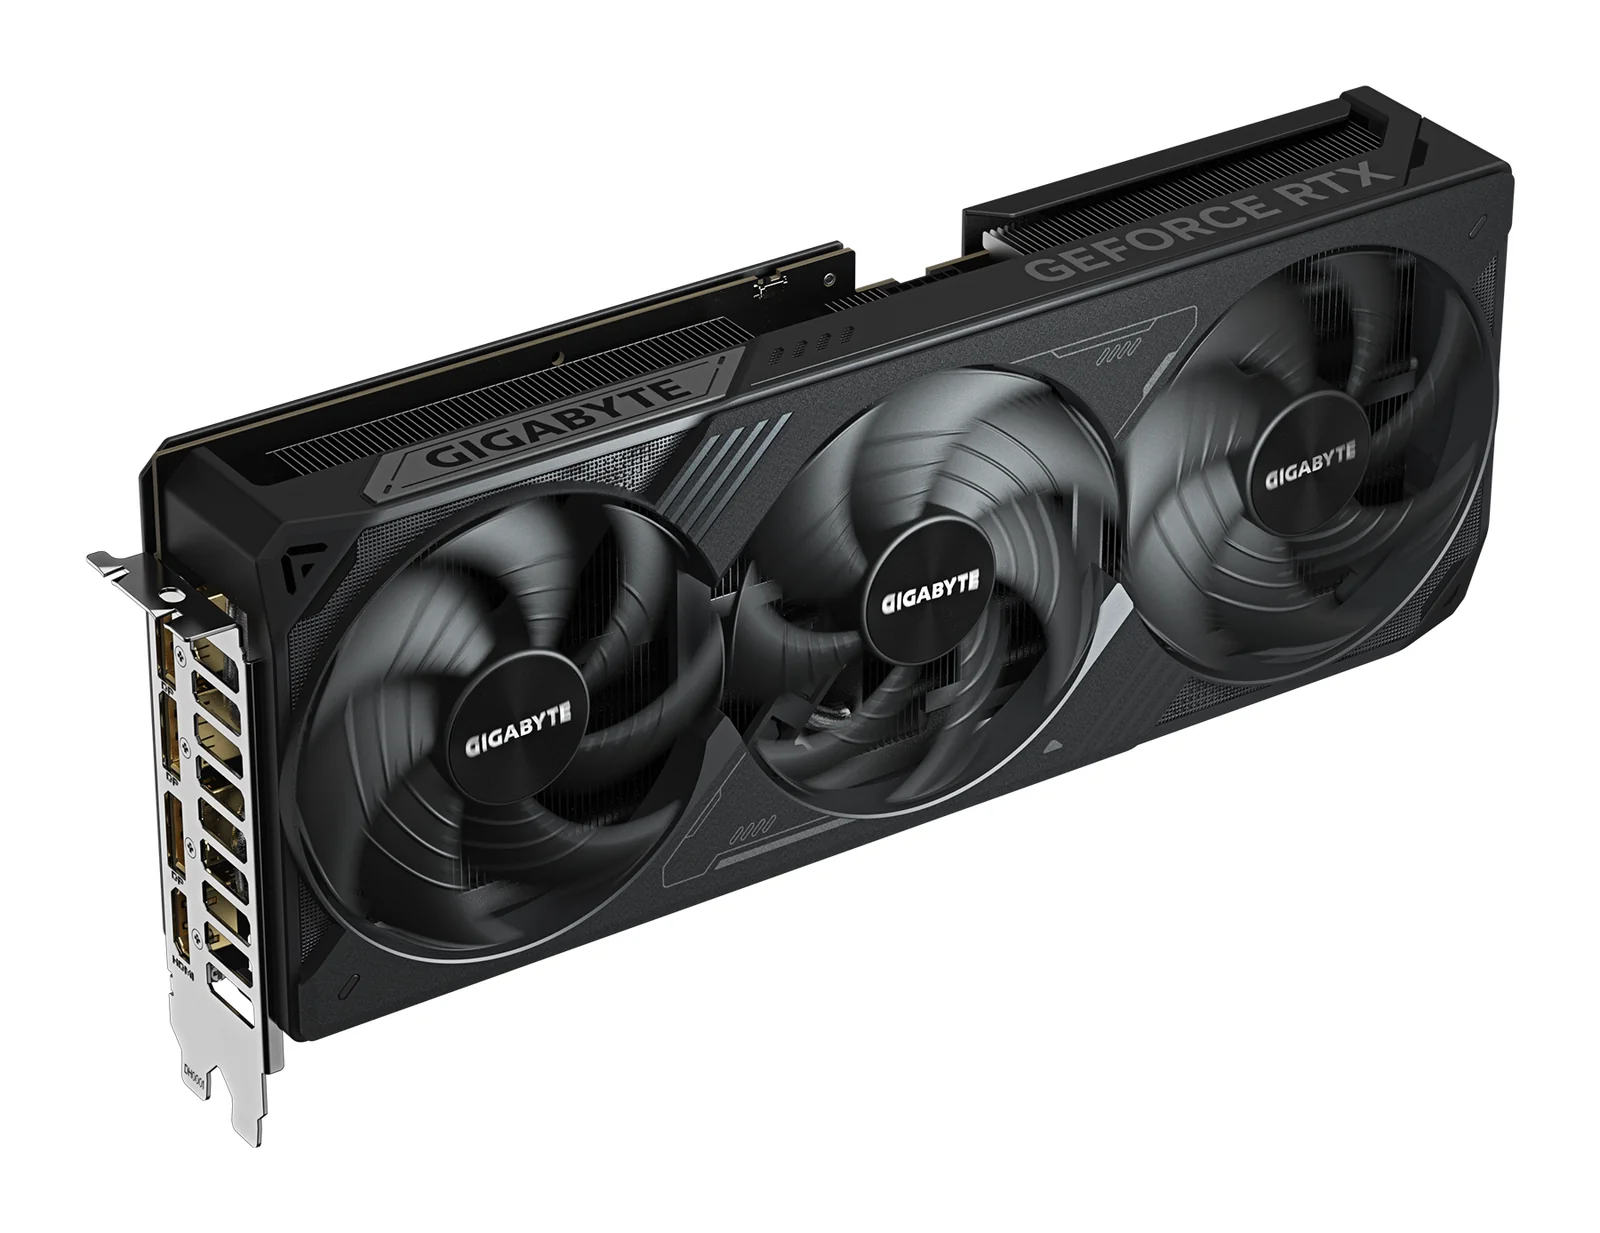
GIGABYTE
GIGABYTE GeForce RTX 5080 WINDFORCE OC SFF 16G
- 16 GB
- NVIDIA GeForce RTX 5080 (Blackwell)
Draait tot 13–14B op 4-bit
Hij heeft dezelfde 16 GB als de RTX 5070 Ti, dus grotere AI-modellen passen er niet op; hij draait ze wel sneller. Wil je meer geheugen op één kaart, kijk dan naar de RTX 5090 of een kaart met 24 tot 32 GB.
€ 1.079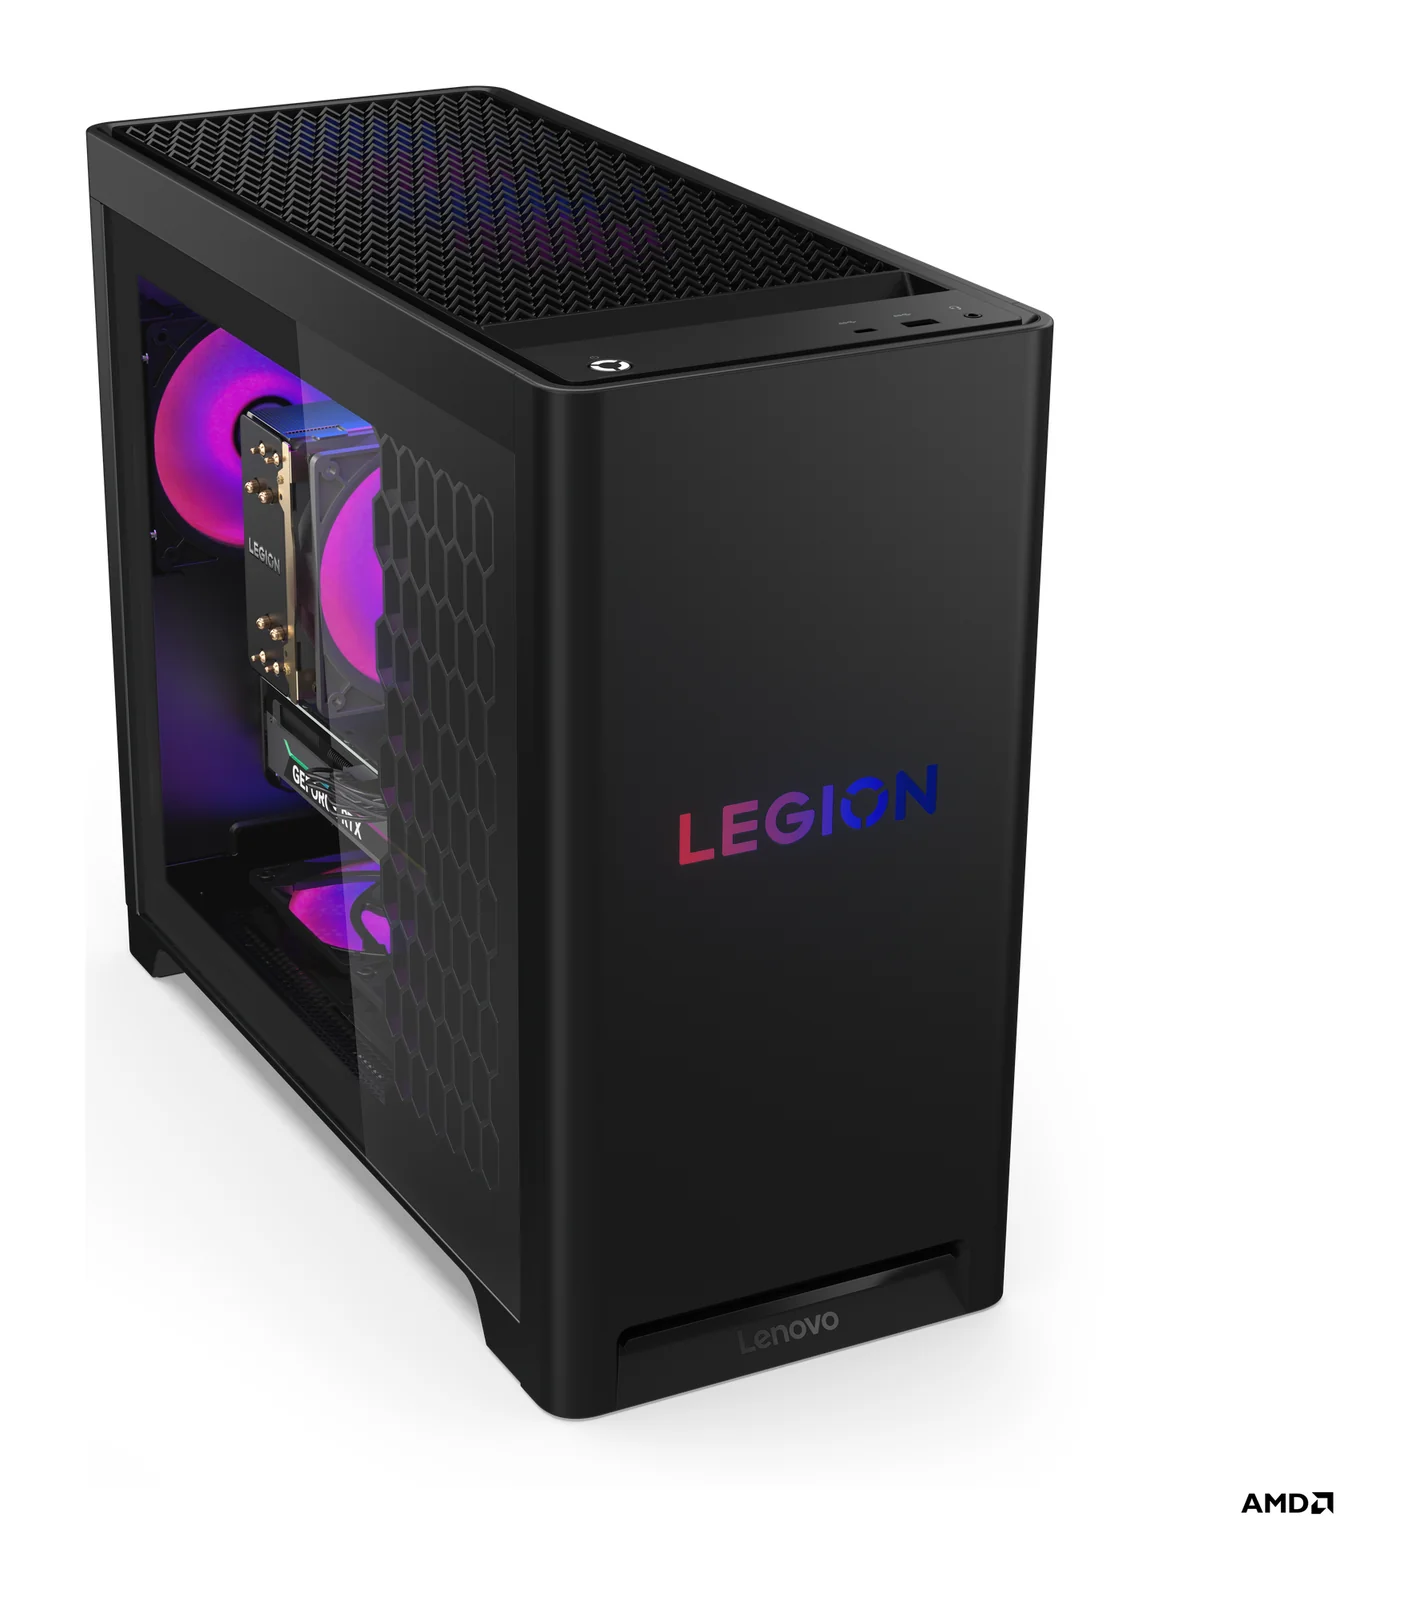
Lenovo
Lenovo Legion Tower 5 Gen 10 (RTX 5070 Ti)
- 32 GB
- AMD Ryzen 7 7800X3D (8 cores / 16 threads, 4,2 / 5,0 GHz, 96 MB L3)
Het werkgeheugen bestaat uit twee modules van 16 GB, en Lenovo geeft 32 GB op als maximum voor deze tower. Reken dus voor de hele levensduur op 32 GB. Opslag kun je wel uitbreiden: er zijn drie M.2-slots en een 3,5-inch bay.
€ 2.159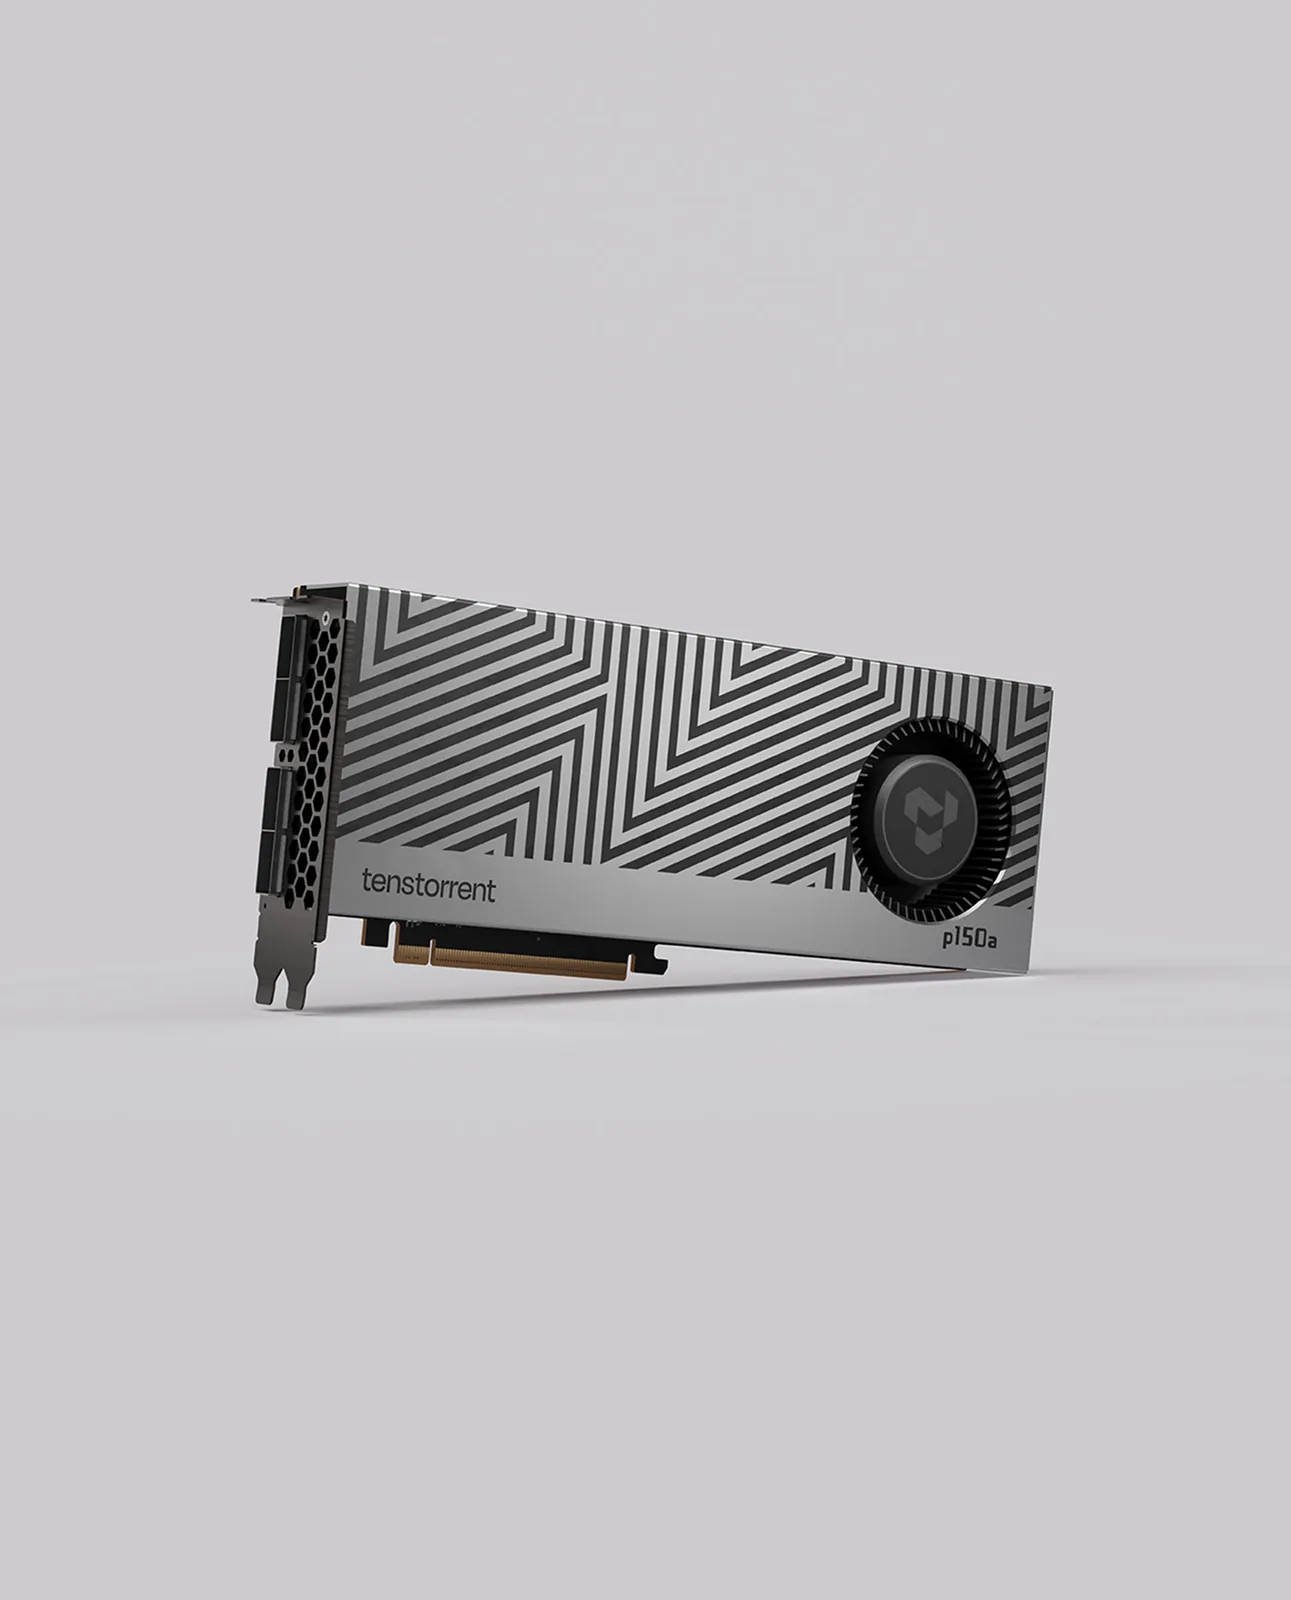
Tenstorrent
Tenstorrent Blackhole p150a
- 32 GB
- Tenstorrent Blackhole
Draait tot 30–34B op 4-bit
Dit is geen CUDA-kaart. Controleer voor aankoop of de modellen die je nodig hebt worden ondersteund in de opensource-modelbibliotheek van Tenstorrent.
€ 1.399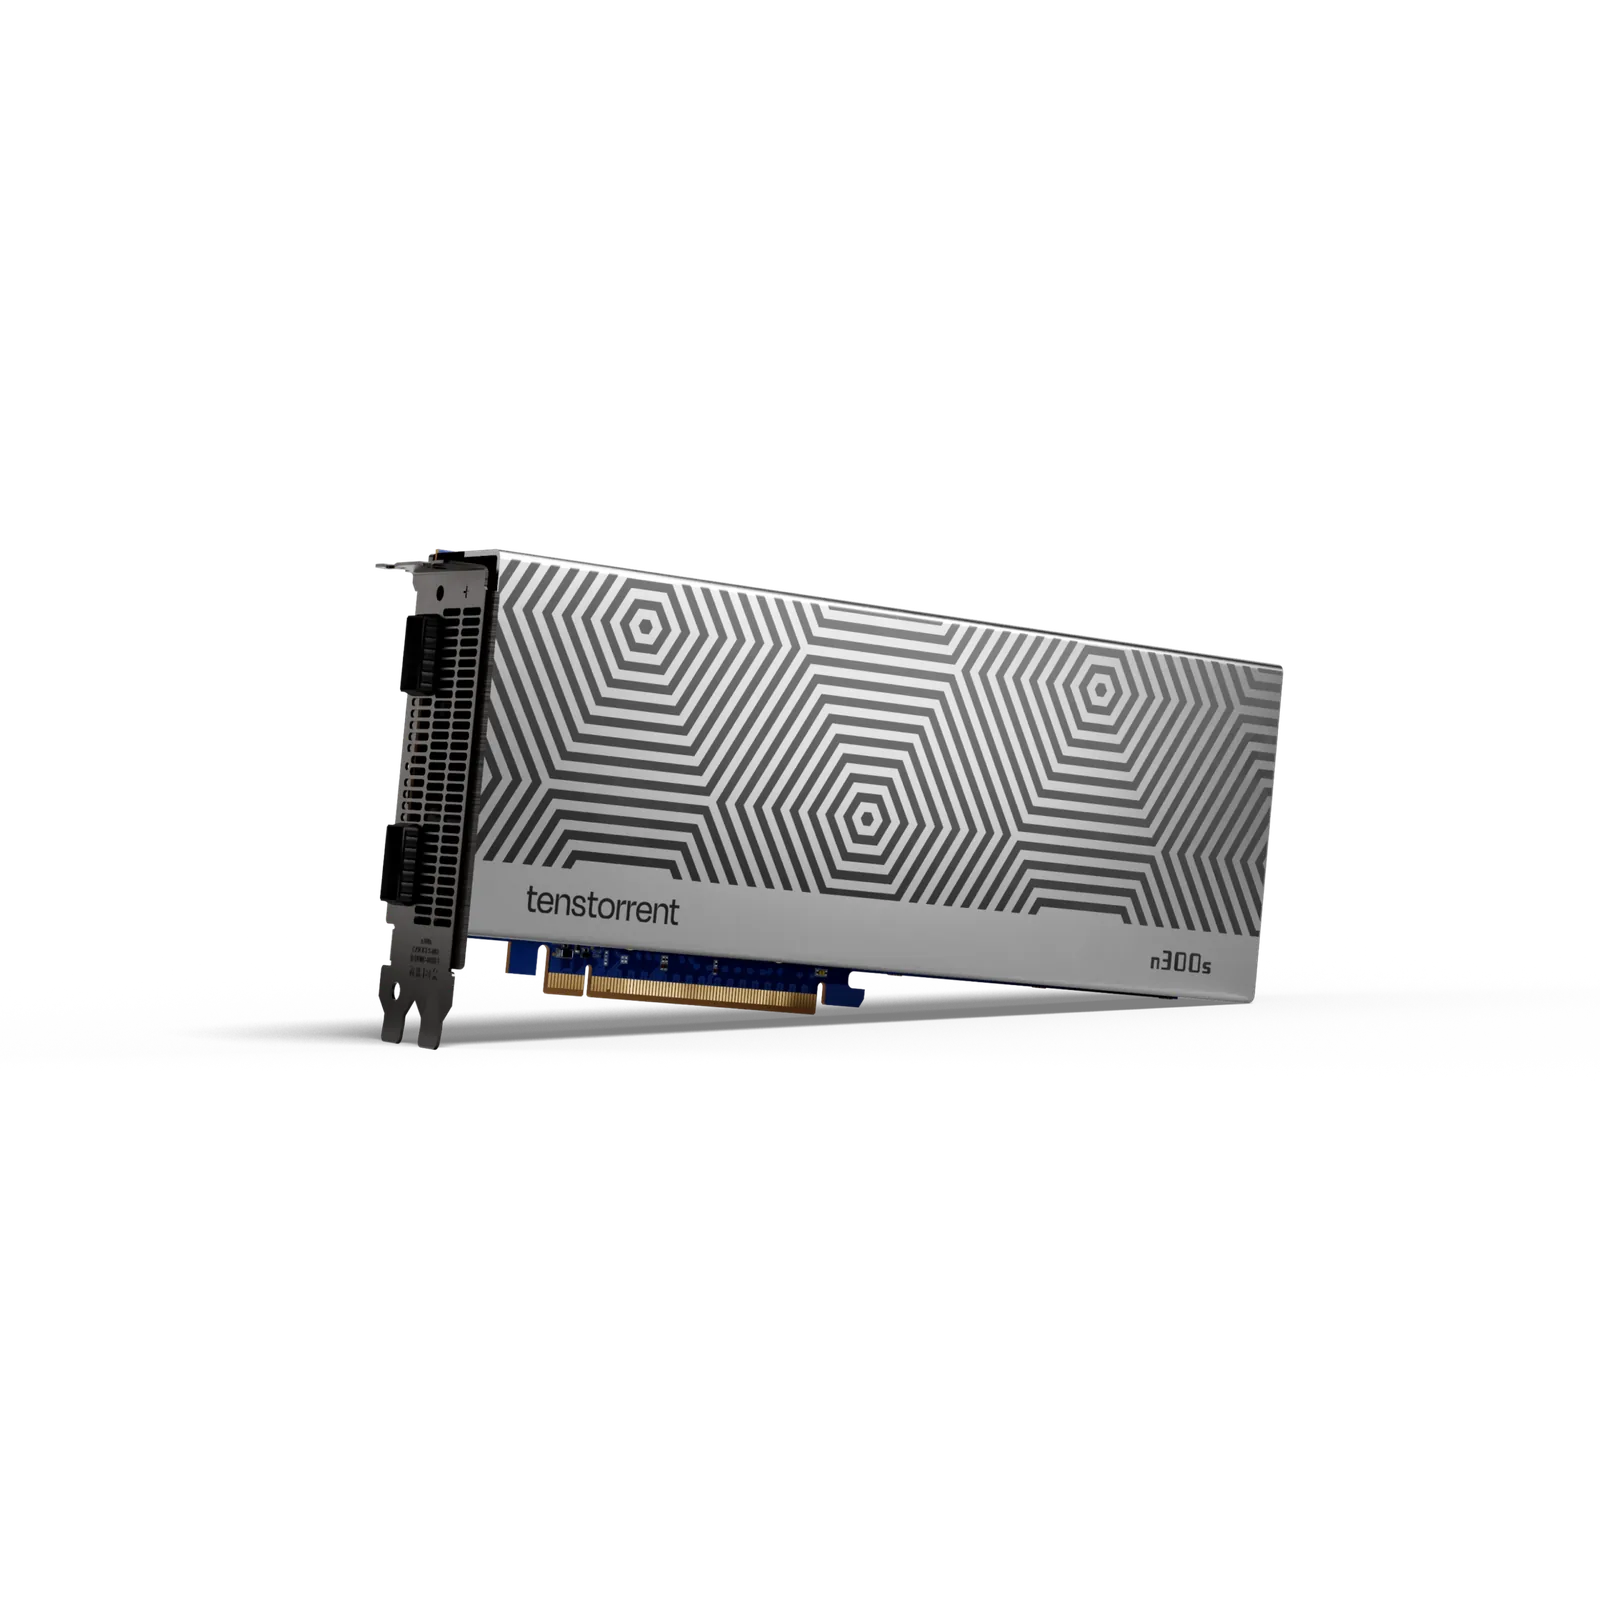
Tenstorrent
Tenstorrent Wormhole n300s
- 24 GB
Draait tot 30–34B op 4-bit
De 24 GB is verdeeld over twee chips (12 GB per chip), dus grotere modellen moeten over beide worden verdeeld. Controleer of er voor het model dat je wilt een werkende multi-chipversie bestaat.
€ 1.399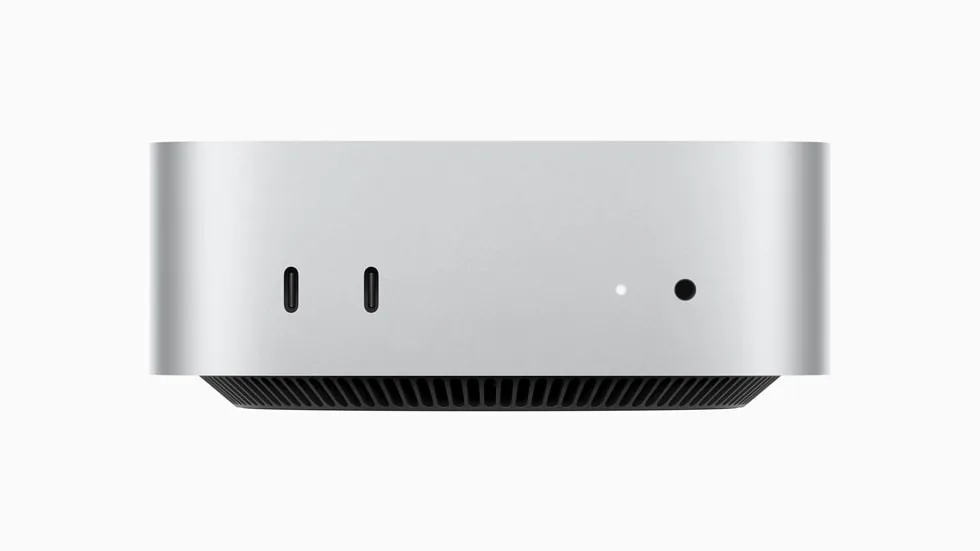
Apple
Apple Mac mini (M4 Pro)
- 24 GB unified
- 16-core; optie: 20-core
Draait tot 13–14B op 4-bit
Het geheugen is na aankoop niet uit te breiden. Wil je lokale AI draaien, kies dan nu voor 48 GB of 64 GB. Met 24 GB wordt het krap bij modellen boven ongeveer 14B parameters.
€ 1.399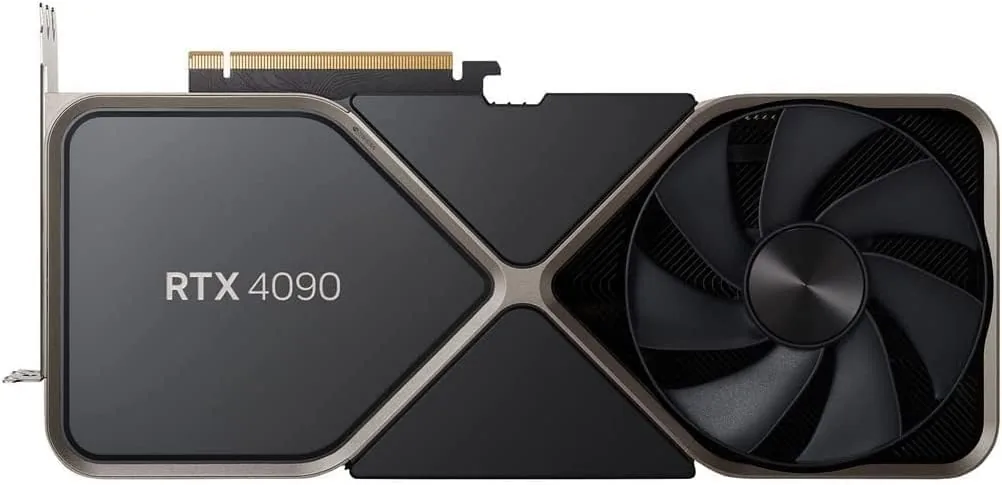
NVIDIA
NVIDIA GeForce RTX 4090
- 24 GB
- NVIDIA Ada Lovelace (AD102)
Draait tot 30–34B op 4-bit
Duw de 16-pins voedingskabel volledig in de kaart en vermijd scherpe bochten vlak bij de stekker. Een losse connector is de meest voorkomende oorzaak van problemen met deze kaart.
€ 1.599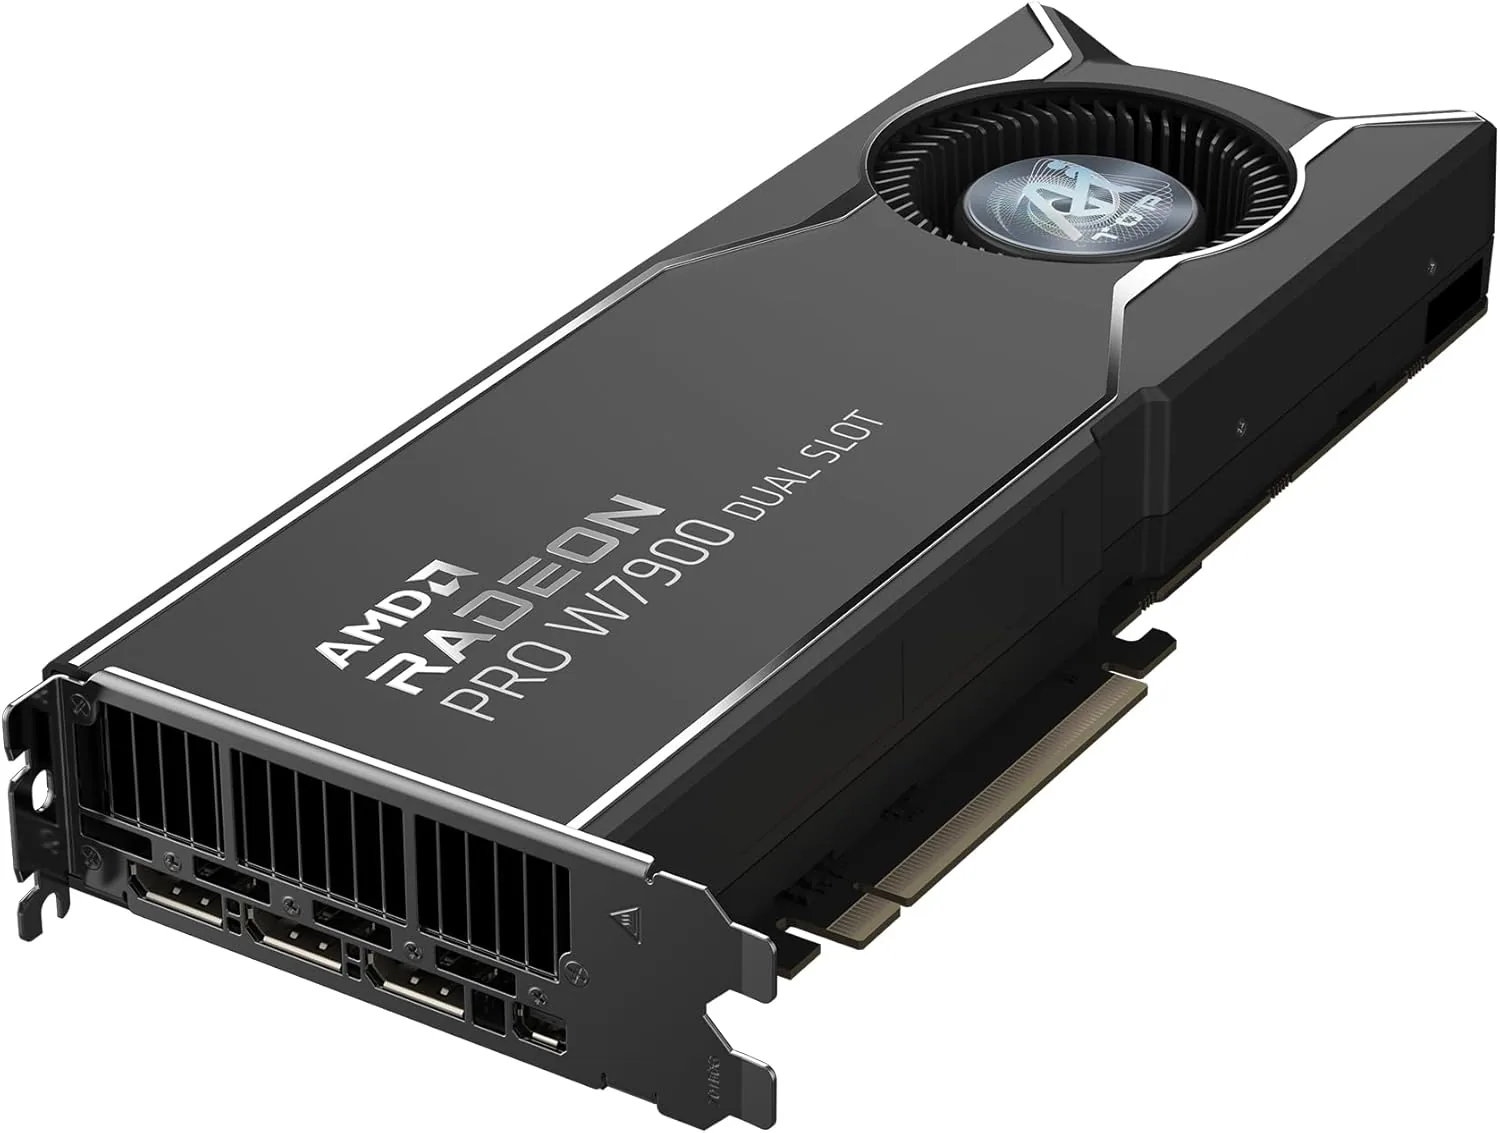
AMD
AMD Radeon PRO W7900 (48 GB)
- 48 GB
- AMD RDNA 3 (Navi 31)
Draait tot 70B op 4-bit
Kies de W7900 als de grootte van je model of scène het zwaarst weegt. De nieuwere R9700 heeft minder geheugen (32 GB), maar ondersteunt FP8 en is per watt sneller voor AI.
€ 3.592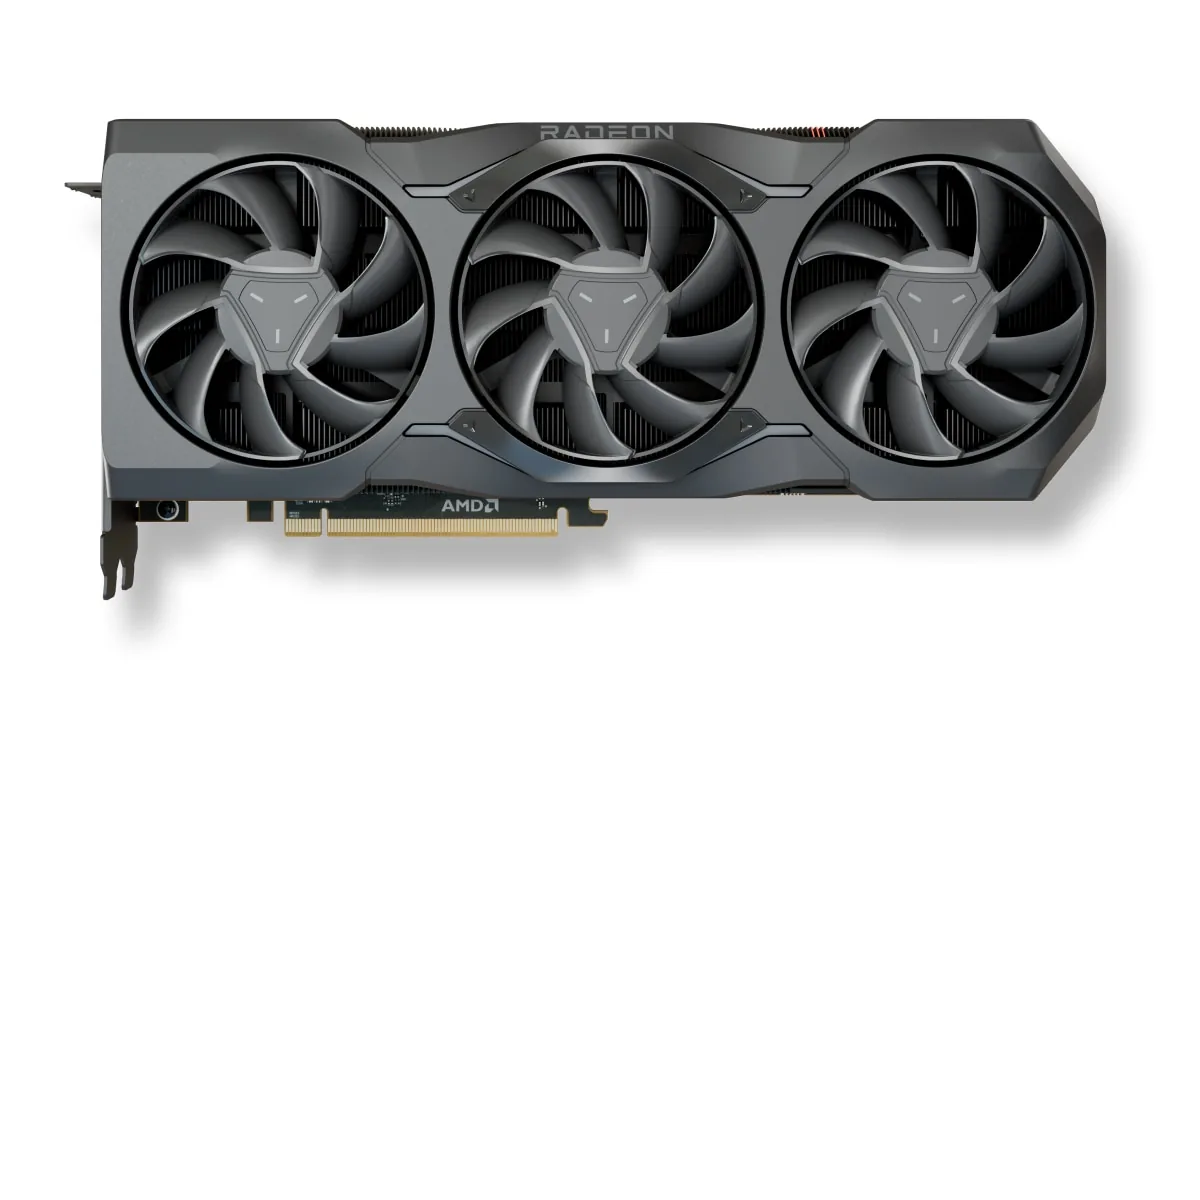
SAPPHIRE
SAPPHIRE PULSE AMD Radeon RX 7900 XTX 24GB
- 24 GB
- AMD RDNA 3 (Navi 31)
Draait tot 30–34B op 4-bit
De PULSE is 313 mm lang en 2,7 slots dik, met drie 8-pins voedingsaansluitingen. Meet je behuizing op en controleer je voeding (minimaal 800 W) voordat je bestelt.
€ 899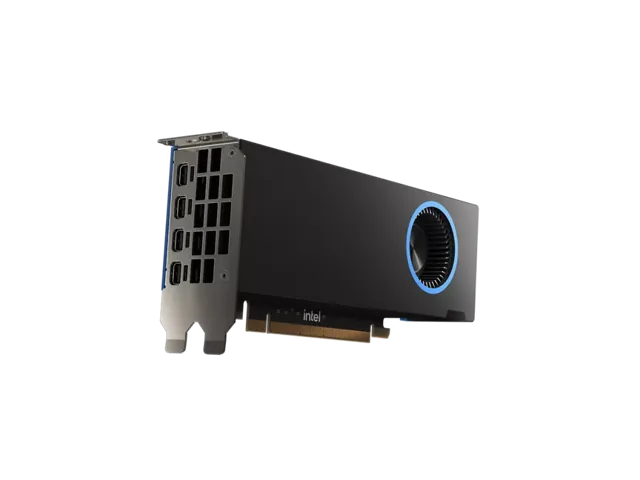
Intel
Intel Arc Pro B50
- 16 GB
- Intel Xe2 (Battlemage)
Draait tot 13–14B op 4-bit
Er is geen voedingskabel nodig, dus de kaart is geschikt voor small-form-factor-machines. Met 16 GB draai je modellen van 7B tot 14B op 4-bit; voor alles wat groter is heb je een grotere kaart nodig.
€ 299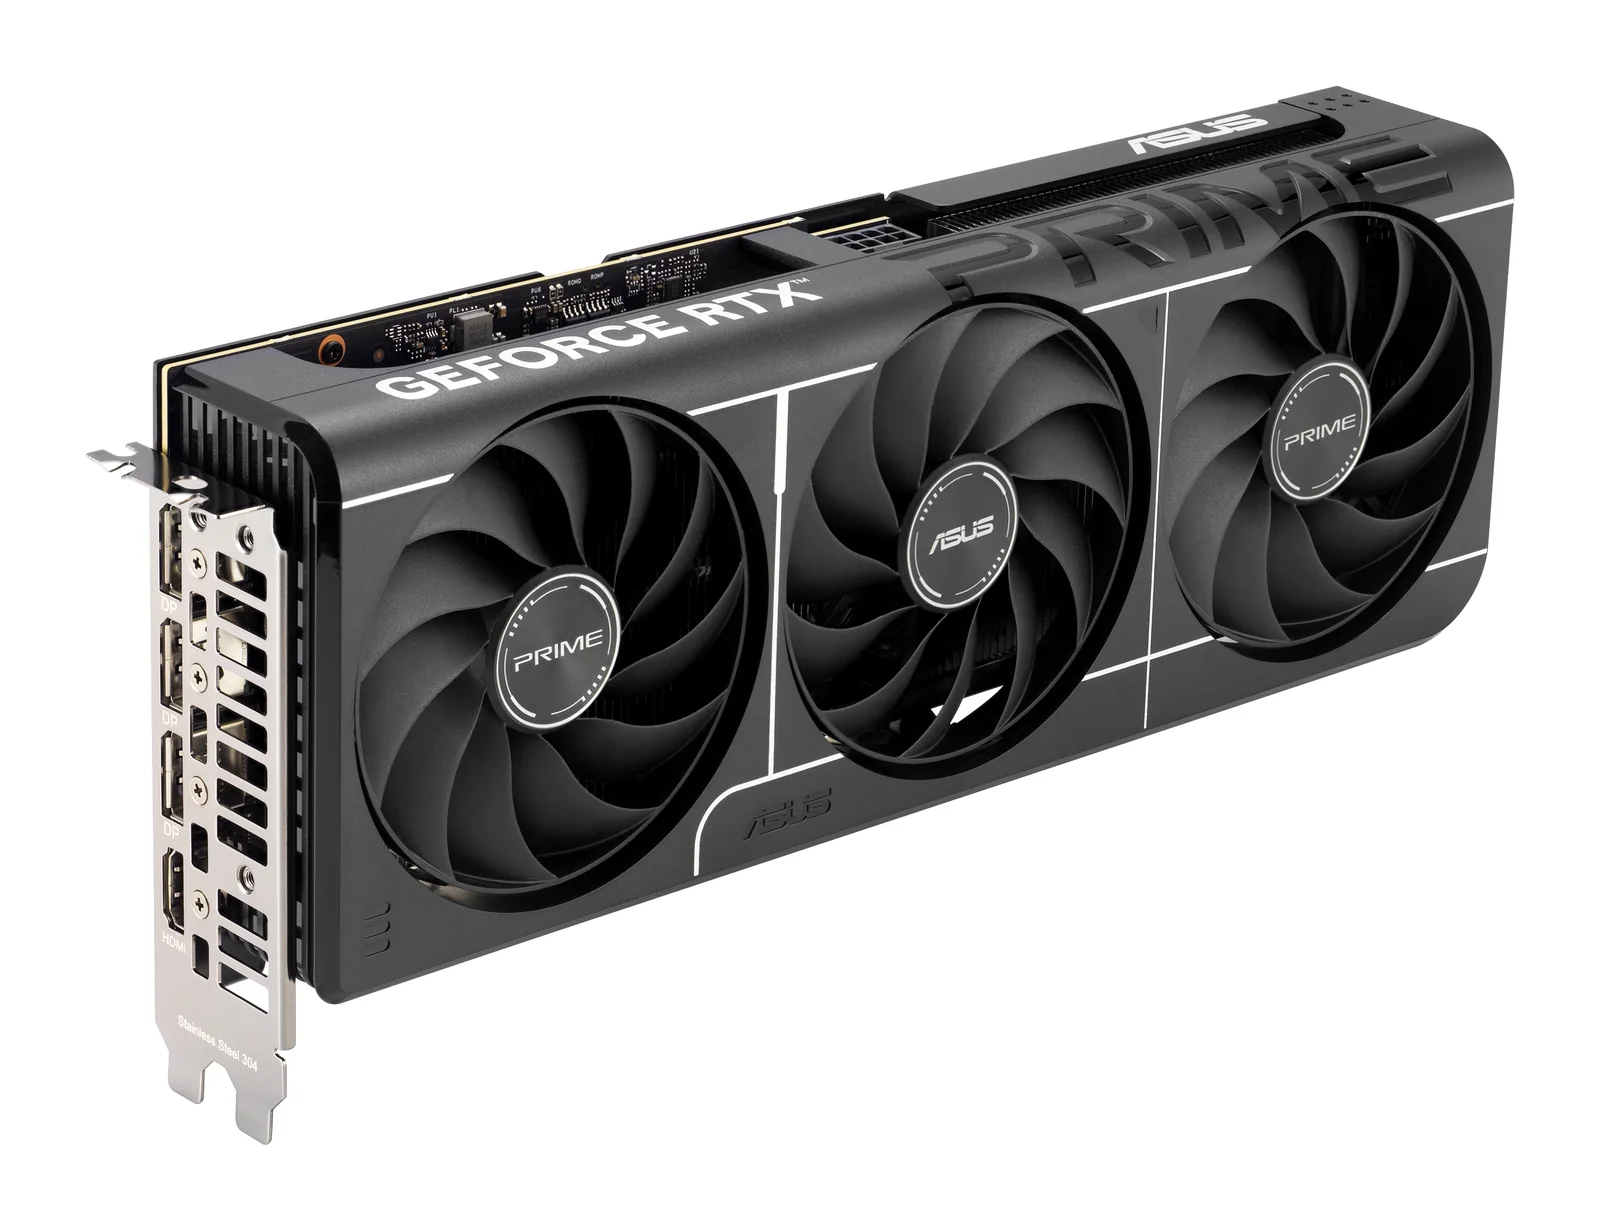
ASUS
ASUS Prime GeForce RTX 5060 Ti 16GB OC Edition
- 16 GB
- NVIDIA GeForce RTX 5060 Ti (Blackwell)
Draait tot 13–14B op 4-bit
Koop voor lokale AI alleen de 16GB-versie; dit is die versie. De geheugenbus van 128 bit is smaller dan die van de grotere kaarten, dus modellen genereren tekst langzamer dan op een RTX 5070 Ti.
€ 369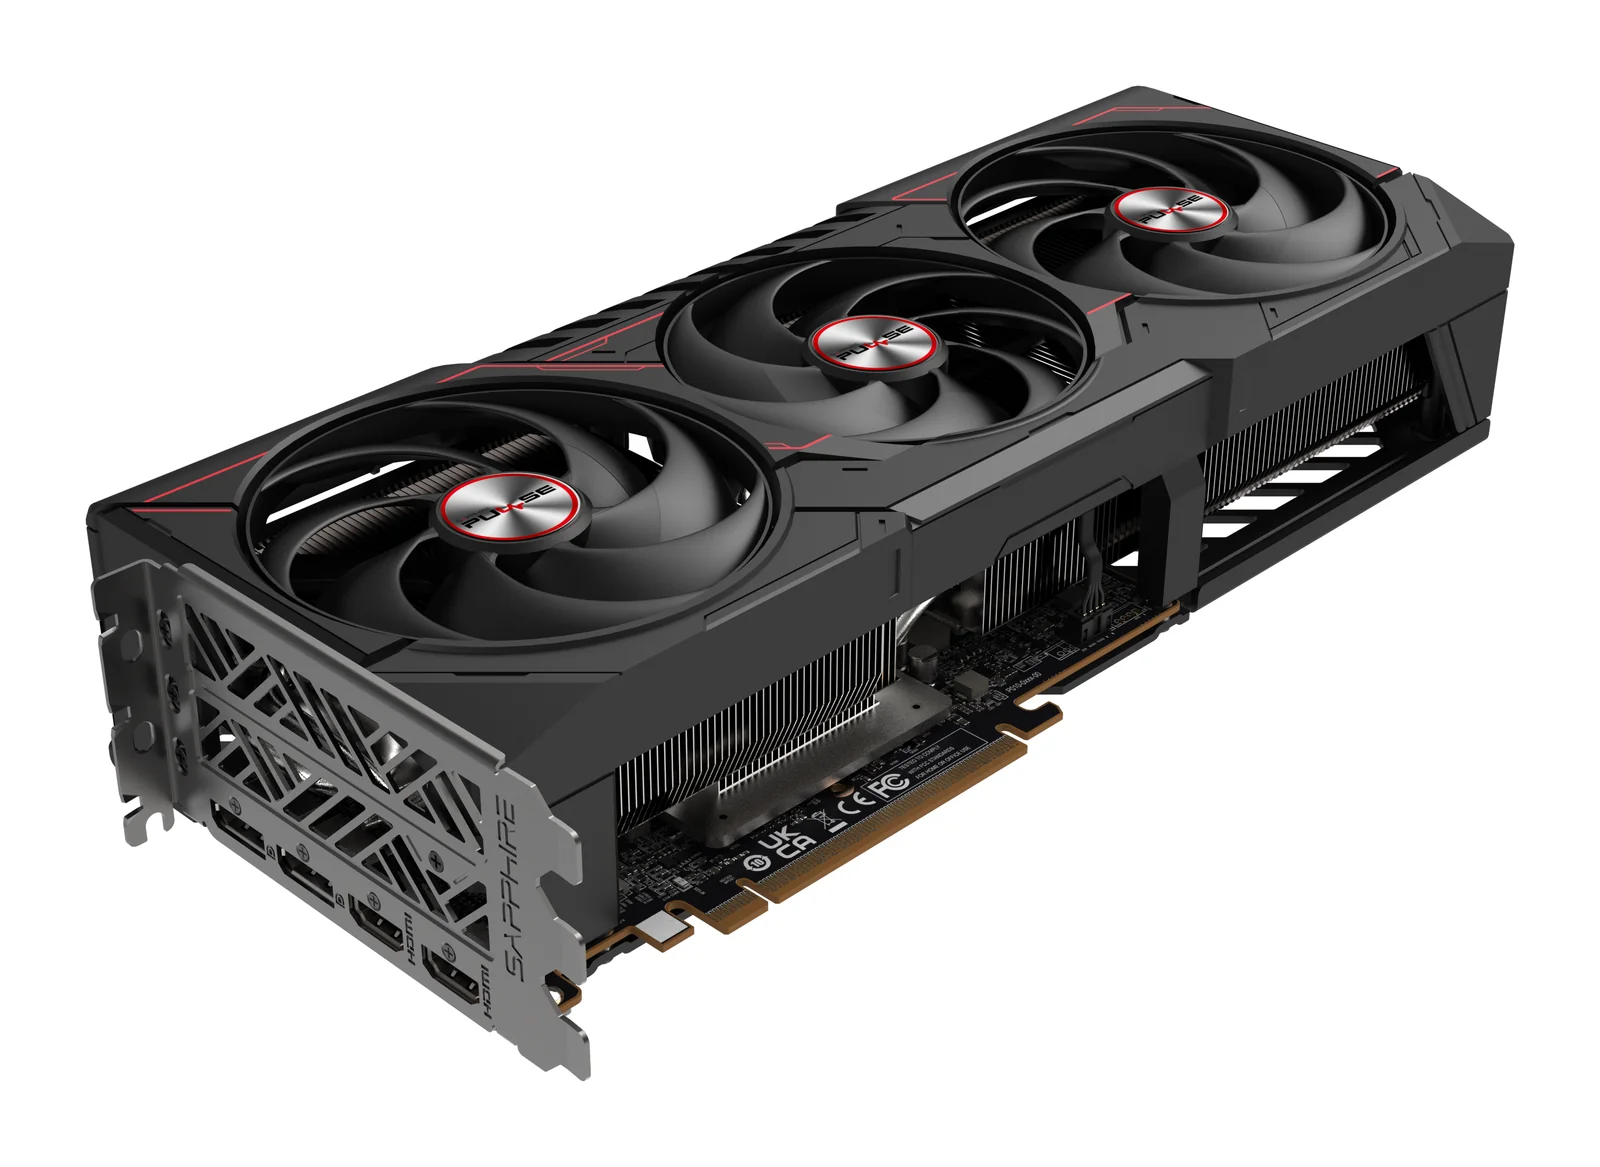
SAPPHIRE
SAPPHIRE PULSE AMD Radeon RX 9070 XT 16GB
- 16 GB
- AMD Radeon RX 9070 XT (RDNA 4)
Draait tot 13–14B op 4-bit
De kaart is 320 mm lang en drie slots dik, en heeft twee 8-pins stroomkabels nodig. SAPPHIRE adviseert een voeding van minimaal 750 W, dus meet eerst je behuizing op.
€ 519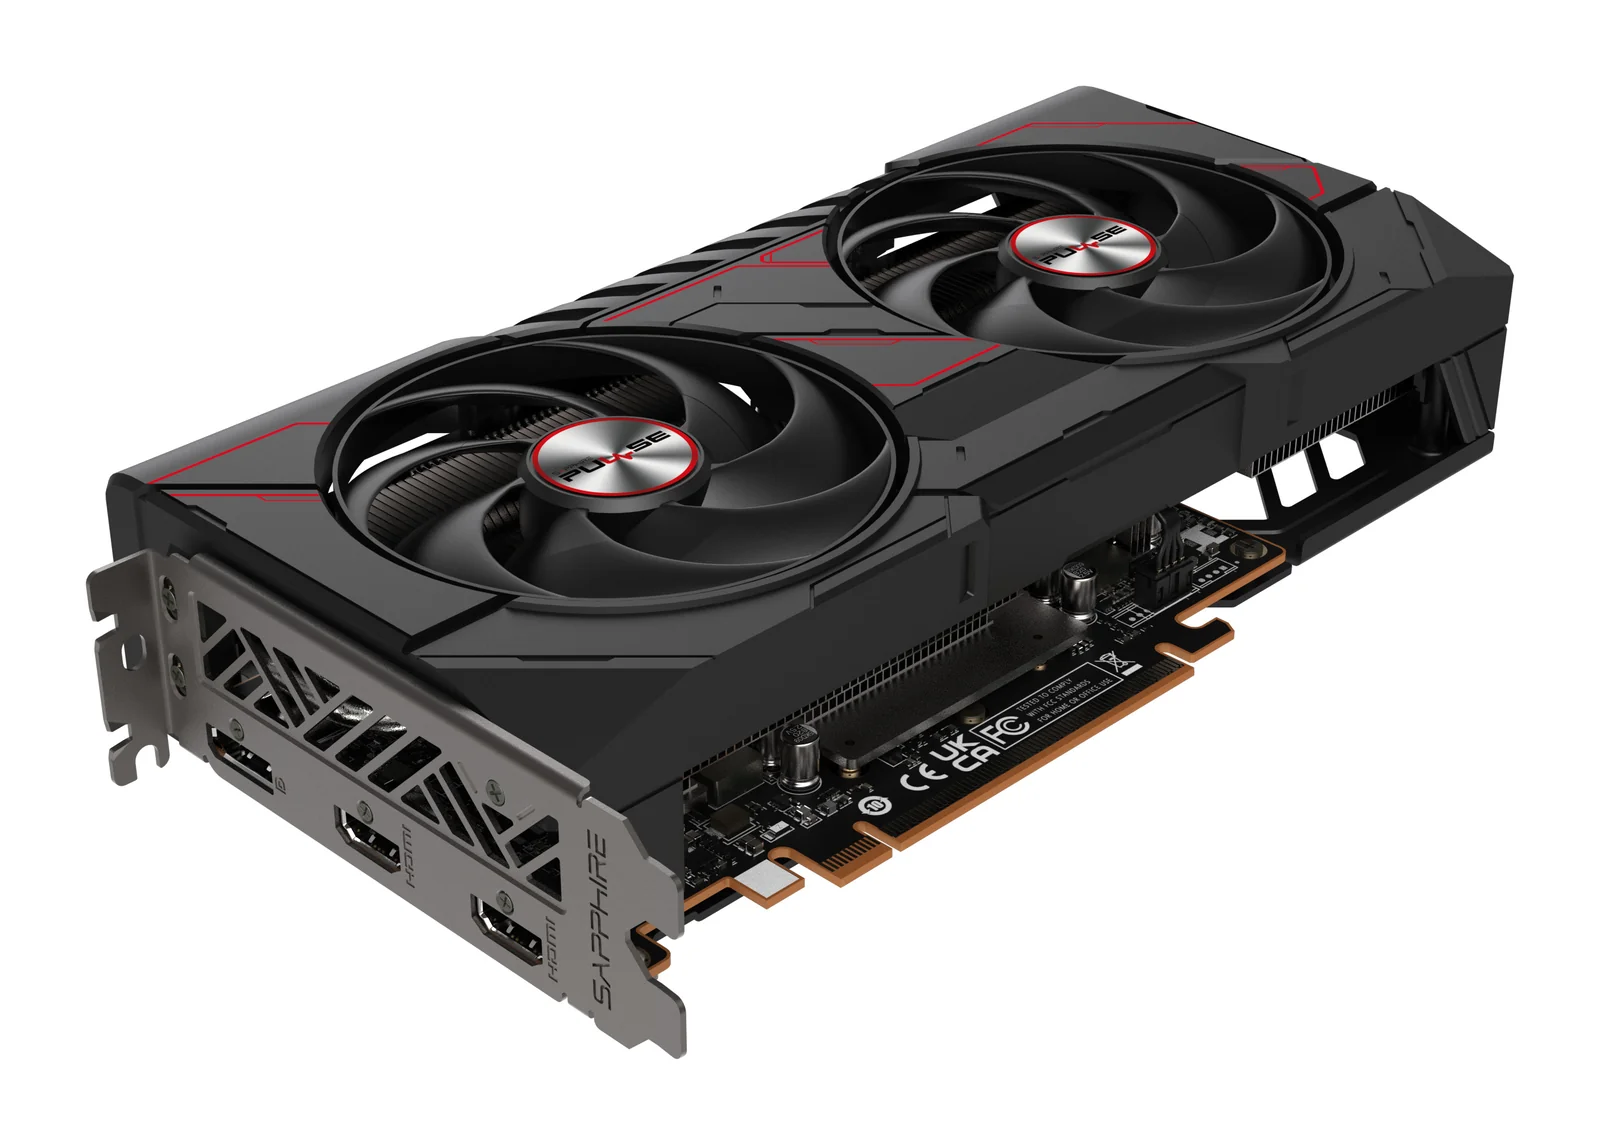
SAPPHIRE
SAPPHIRE PULSE AMD Radeon RX 9060 XT 16GB
- 16 GB
- AMD Radeon RX 9060 XT (RDNA 4)
Draait tot 13–14B op 4-bit
Dit is de 16GB-versie; de 8GB-versie is een andere kaart en komt in nieuwe games nu al geheugen tekort. Eén 8-pins kabel en een voeding van 450 W zijn genoeg.
€ 299Zo kies je hardware voor lokale AI
- Reken met bruikbaar geheugen, niet met het getal op de doos
- Onze modelgids rekent 90% van het geheugen van een videokaart als bruikbaar en 75% van unified memory, omdat het besturingssysteem een deel van het gedeelde geheugen reserveert. Een Mac met 64 GB stelt ongeveer 48 GB beschikbaar voor modellen, een kaart met 48 GB ongeveer 43 GB.
- Stem het geheugen af op de modelgrootte
- Tot 14B op 4-bit: een kaart met 16 GB of een Mac mini met 24 GB. 30B-klasse op 4-bit: één kaart met 24 GB of 32 GB. 70B op 4-bit: een kaart met 48 GB, twee kaarten met 24 GB of 64 GB+ unified memory. 70B op 8-bit en 120B-klasse op 4-bit: een kaart met 96 GB of een machine met 128 GB unified memory.
- Kies het platform dat je software nodig heeft
- NVIDIA als je software CUDA nodig heeft of als je ook gamet. Een Mac Studio voor grote modellen in een vrijwel geruisloze behuizing. Een Ryzen AI Max+ mini-pc voor 128 GB onder Windows of Linux. De DGX Spark als je op CUDA ontwikkelt en uitrolt naar grotere NVIDIA-systemen.
- Past het model, dan bepaalt bandbreedte de snelheid
- Voor elk nieuw token worden de gewichten doorgelezen, dus een model schrijft sneller op een machine met meer geheugenbandbreedte: 1.792 GB/s bij de RTX 5090, 819 GB/s bij de Mac Studio, 273 GB/s bij de Mac mini M4 Pro en de DGX Spark.
- Wanneer een goedkopere machine volstaat
- Chatten, samenvatten, code aanvullen en zoeken in je eigen documenten lukt allemaal met modellen van 7B tot 14B, en die passen in 16 GB. De Arc Pro B50 of een Mac mini met 24 GB is daar genoeg voor. Neem wat extra ruimte als je met lange documenten werkt.
Veelgestelde vragen
Kan ik een 70B-model op één videokaart draaien?
Alleen op een kaart met 48 GB of meer. Op de Radeon PRO W7900 (48 GB) past het net op 4-bit, op de RTX PRO 6000 (96 GB) past het op 8-bit. Een kaart met 32 GB, zoals de RTX 5090, is niet genoeg.
Wat betekenen 4-bit en 8-bit voor de hardware die ik nodig heb?
Op 4-bit neemt het model ongeveer de helft van het geheugen van 8-bit in, met een klein kwaliteitsverlies; zo draaien de meeste mensen modellen thuis. Op 8-bit blijft er meer kwaliteit over en heb je ongeveer twee keer zoveel geheugen nodig, wat de moeite waard is voor programmeren of exacte data-extractie.
Hoeveel extra geheugen hebben lange chats en documenten nodig?
Het contextgeheugen groeit met elk token dat het model in beeld houdt, dus reken op meer dan de omvang van het model zelf. Kies liever de eerstvolgende geheugengrootte dan een waar het model maar net in past.
Is hardware voor lokale AI geschikt voor fine-tuning?
Fine-tuning vraagt meer geheugen dan een model draaien. Parameter-efficiënte methoden zoals LoRA verlagen die behoefte flink; voor werk op basis van CUDA biedt de DGX Spark met 128 GB ruimte voor modelgroottes die een kaart met 32 GB niet haalt.
Kunnen jullie een machine bouwen voor de modellen die ik wil draaien?
Ja. Stuur een aanvraag voor een pc op maat met de modellen die je wilt draaien, je budget en je land, dan sturen we je een configuratie en een offerte.
Gerelateerde pagina's: Videokaarten · Mini-pc's · Apple · AI-accelerators
Gidsen
Lokale AI · 5 min lezen
Hoeveel geheugen heb je nodig voor een lokaal LLM?
Hoeveel geheugen een lokaal LLM nodig heeft: 7B- tot 120B+-modellen op 4-bit en 8-bit, unified memory vs. VRAM, en welke machines welke grootte aankunnen.
Lees de gids →Lokale AI · 5 min lezen
Mac, NVIDIA of Ryzen AI Max+ voor lokale AI
Mac, NVIDIA of Ryzen AI Max+? CUDA op NVIDIA, unified memory op een Mac of 128 GB in een mini-pc. Geheugen, software en afwegingen per soort werk.
Lees de gids →Videokaarten · 5 min lezen
GPU voor lokale AI kiezen: RTX 5090, R9700, B60
Kies een GPU voor lokale AI op basis van geheugen, software en bandbreedte: RTX 5090, Radeon AI PRO R9700, Arc Pro B60 en pro-kaarten met 48 en 96 GB.
Lees de gids →