Nach Einsatzzweck
KI-Workstation für lokale LLMs: welcher Rechner welches Modell schafft
Sprach- und Bildmodelle auf der eigenen KI-Workstation ausführen: privat, offline und ohne monatliche Kosten.
Kauftipp: Der Speicher entscheidet, welche Modelle passen. Die Geschwindigkeit kommt danach. Prüfen Sie zuerst die Modellgröße und wählen Sie dann den Rechner.
Der Speicher entscheidet, welche Modelle Sie ausführen können; die Geschwindigkeit kommt erst danach. Rund 6 GB fassen ein 7–8B-Modell mit 4 Bit, rund 42 GB ein 70B-Modell und rund 80 GB ein Modell der 120B-Klasse. Gehen Sie also vom größten gewünschten Modell aus und wählen Sie einen Rechner mit genug nutzbarem Speicher. Danach entscheiden Sie sich für die Softwareplattform: CUDA bei NVIDIA, Metal und MLX auf dem Mac oder ROCm und Vulkan bei AMD.
Unsere Auswahl
70B-Modelle und die 120B-Klasse in einem kleinen Gehäuse
Ryzen AI Max+ 395
Beelink
Beelink GTR9 Pro
- 128 GB Unified
- AMD Ryzen AI Max+ 395
Schafft bis zu 120B+ bei 4 Bit
Unter Windows lassen sich der GPU bis zu 96 GB der 128 GB zuweisen. Prüfen Sie vor dem Kauf, ob das Modell, das Sie nutzen möchten, in diesen Speicher passt.
4.349 €128 GB gemeinsamer Arbeitsspeicher, davon rund 96 GB für Modelle, unter Windows oder Linux; setzen Sie auf Linux, wenn die GPU möglichst viel Speicher erhalten soll.
Höchstes Tempo bei Modellen bis 30B
GeForce RTX 5090
NVIDIA
NVIDIA GeForce RTX 5090
- 32 GB
- NVIDIA Blackwell (GB202)
Schafft bis zu 30–34B bei 4 Bit
Mit 32 GB laufen Modelle der 30B-Klasse in 4 Bit problemlos, ein 70B-Modell passt aber nicht auf eine Karte. Für 70B sollten Sie zwei Karten oder ein System mit großem gemeinsamem Arbeitsspeicher einplanen.
1.999 €32 GB GDDR7 mit 1.792 GB/s und CUDA. Ein 70B-Modell passt nicht auf eine einzelne Karte.
Große Modelle, nahezu lautlos
Mac Studio M3 Ultra
Apple
Apple Mac Studio (M3 Ultra)
- 96 GB Unified
- 60 Kerne; optional 80 Kerne
Schafft bis zu 70B bei 4 Bit
macOS reserviert einen Teil des gemeinsamen Arbeitsspeichers für das System, die GPU kann also den Großteil nutzen, aber nicht alles. Wählen Sie die Konfiguration mit etwas Reserve über der Modellgröße.
3.999 €96 GB ab Werk und 819 GB/s: Ein 70B-Modell in 4 Bit läuft zügig, und das Gerät bleibt dabei nahezu lautlos.
NVIDIA
NVIDIA GeForce RTX 5090
- 32 GB
- NVIDIA Blackwell (GB202)
Schafft bis zu 30–34B bei 4 Bit
Mit 32 GB laufen Modelle der 30B-Klasse in 4 Bit problemlos, ein 70B-Modell passt aber nicht auf eine Karte. Für 70B sollten Sie zwei Karten oder ein System mit großem gemeinsamem Arbeitsspeicher einplanen.
1.999 €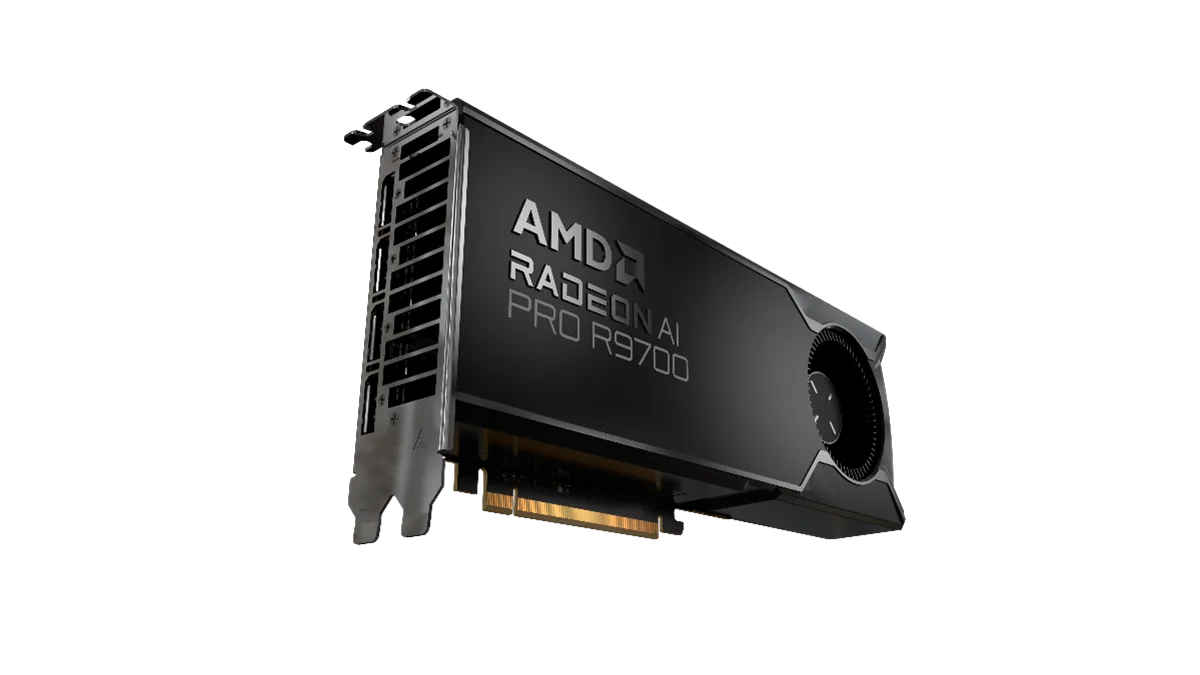
PowerColor
PowerColor AMD Radeon AI PRO R9700 32GB
- 32 GB
- AMD RDNA 4 (Navi 48)
Schafft bis zu 30–34B bei 4 Bit
Prüfen Sie vor dem Kauf, ob Ihre Tools ROCm auf Ihrem Betriebssystem unterstützen. PyTorch und llama.cpp tun das; einige Nischen-Tools setzen noch CUDA voraus.
1.299 €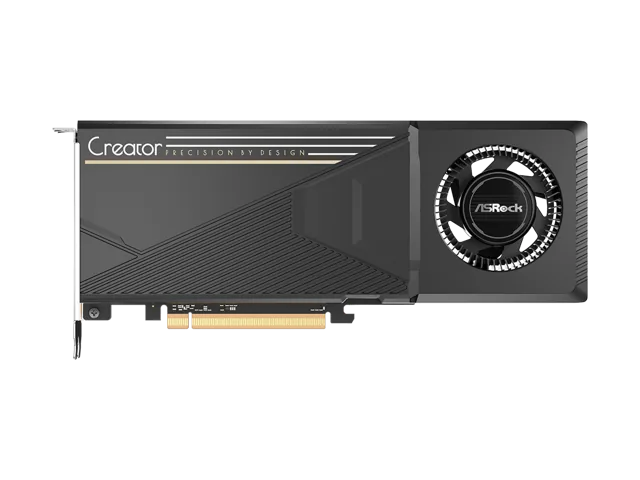
ASRock
ASRock Intel Arc Pro B60 Creator 24GB
- 24 GB
- Intel Xe2 (Battlemage)
Schafft bis zu 30–34B bei 4 Bit
Diese Karte hat eine einzelne GPU mit 24 GB. Sie nutzt einen PCIe-5.0-Steckplatz mit x8-Anbindung und läuft auch in PCIe-4.0-Steckplätzen. Prüfen Sie vor der Bestellung im Datenblatt von ASRock die genaue Länge und den Stromanschluss.
599,99 €Beelink
Beelink GTR9 Pro
- 128 GB Unified
- AMD Ryzen AI Max+ 395
Schafft bis zu 120B+ bei 4 Bit
Unter Windows lassen sich der GPU bis zu 96 GB der 128 GB zuweisen. Prüfen Sie vor dem Kauf, ob das Modell, das Sie nutzen möchten, in diesen Speicher passt.
4.349 €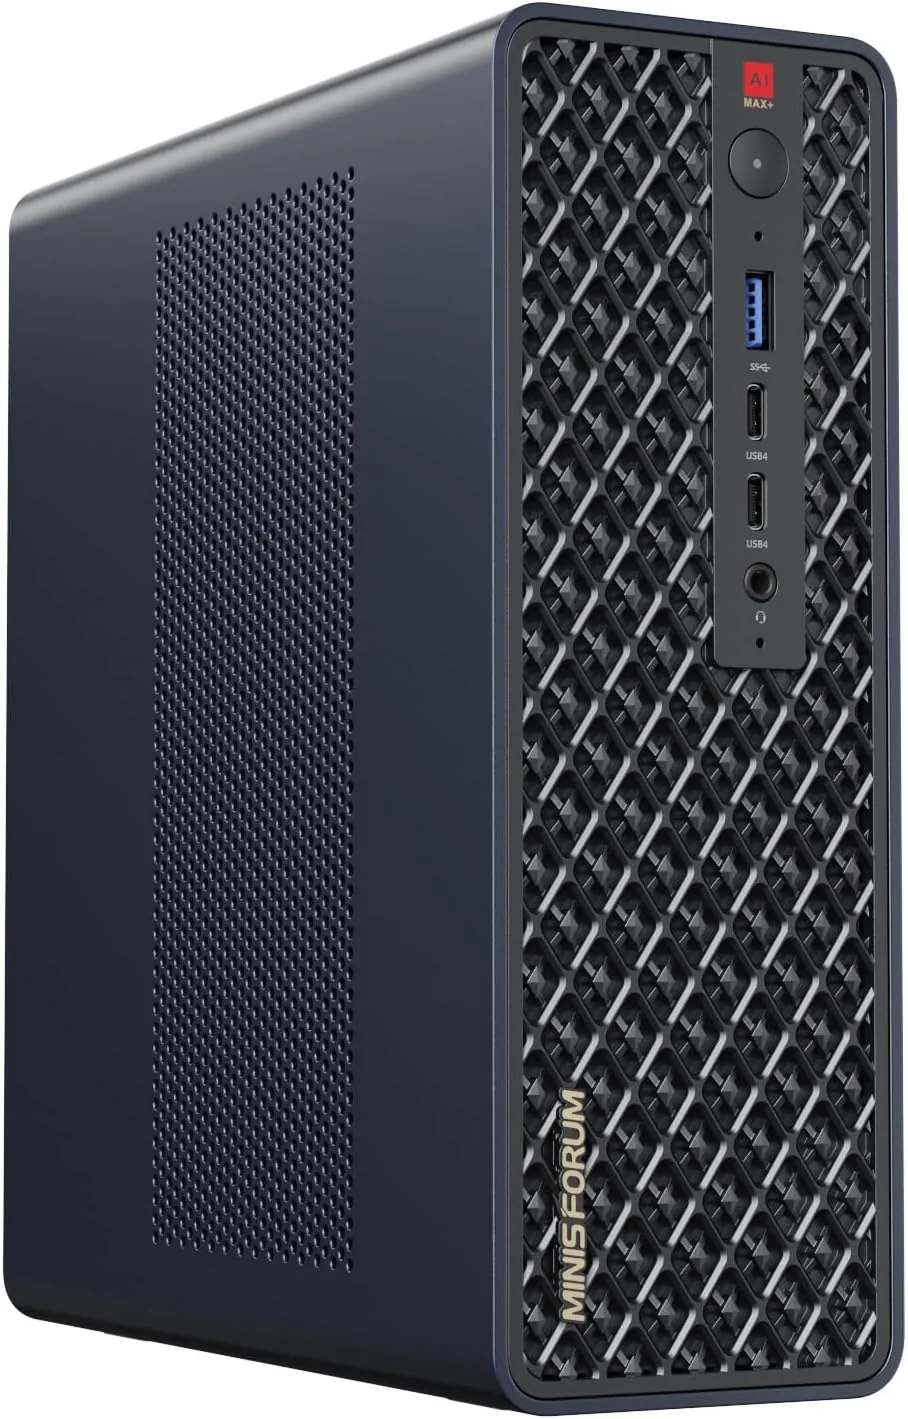
Minisforum
Minisforum MS-S1 Max
- 128 GB Unified
- AMD Ryzen AI Max+ 395
Schafft bis zu 120B+ bei 4 Bit
Der PCIe-Steckplatz nimmt Low-Profile-Karten auf und ist mit x4 angebunden. Er eignet sich ideal für eine schnellere Netzwerkkarte, nicht für eine Grafikkarte in voller Größe.
2.469 €
NVIDIA
NVIDIA DGX Spark
- 128 GB Unified
- NVIDIA GB10 Grace Blackwell
Schafft bis zu 120B+ bei 4 Bit
Seine Speicherbandbreite (273 GB/s) ist geringer als die einer High-End-Grafikkarte, daher erzeugen große dichte Modelle Text langsamer als auf einer RTX 5090. Seine Stärken sind die Kapazität und der CUDA-Software-Stack.
4.699 €Apple
Apple Mac Studio (M3 Ultra)
- 96 GB Unified
- 60 Kerne; optional 80 Kerne
Schafft bis zu 70B bei 4 Bit
macOS reserviert einen Teil des gemeinsamen Arbeitsspeichers für das System, die GPU kann also den Großteil nutzen, aber nicht alles. Wählen Sie die Konfiguration mit etwas Reserve über der Modellgröße.
3.999 €
NVIDIA
NVIDIA RTX PRO 6000 Blackwell Workstation Edition (96 GB)
- 96 GB
- NVIDIA Blackwell (GB202)
Schafft bis zu 120B+ bei 4 Bit
Dies ist die Workstation Edition mit 600 W und Double-Flow-Through-Kühler. Sie benötigt ein 16-Pin-Stromkabel, ein Gehäuse, das Karten mit 12 Zoll Länge aufnimmt, und einen guten Luftstrom.
13.250 €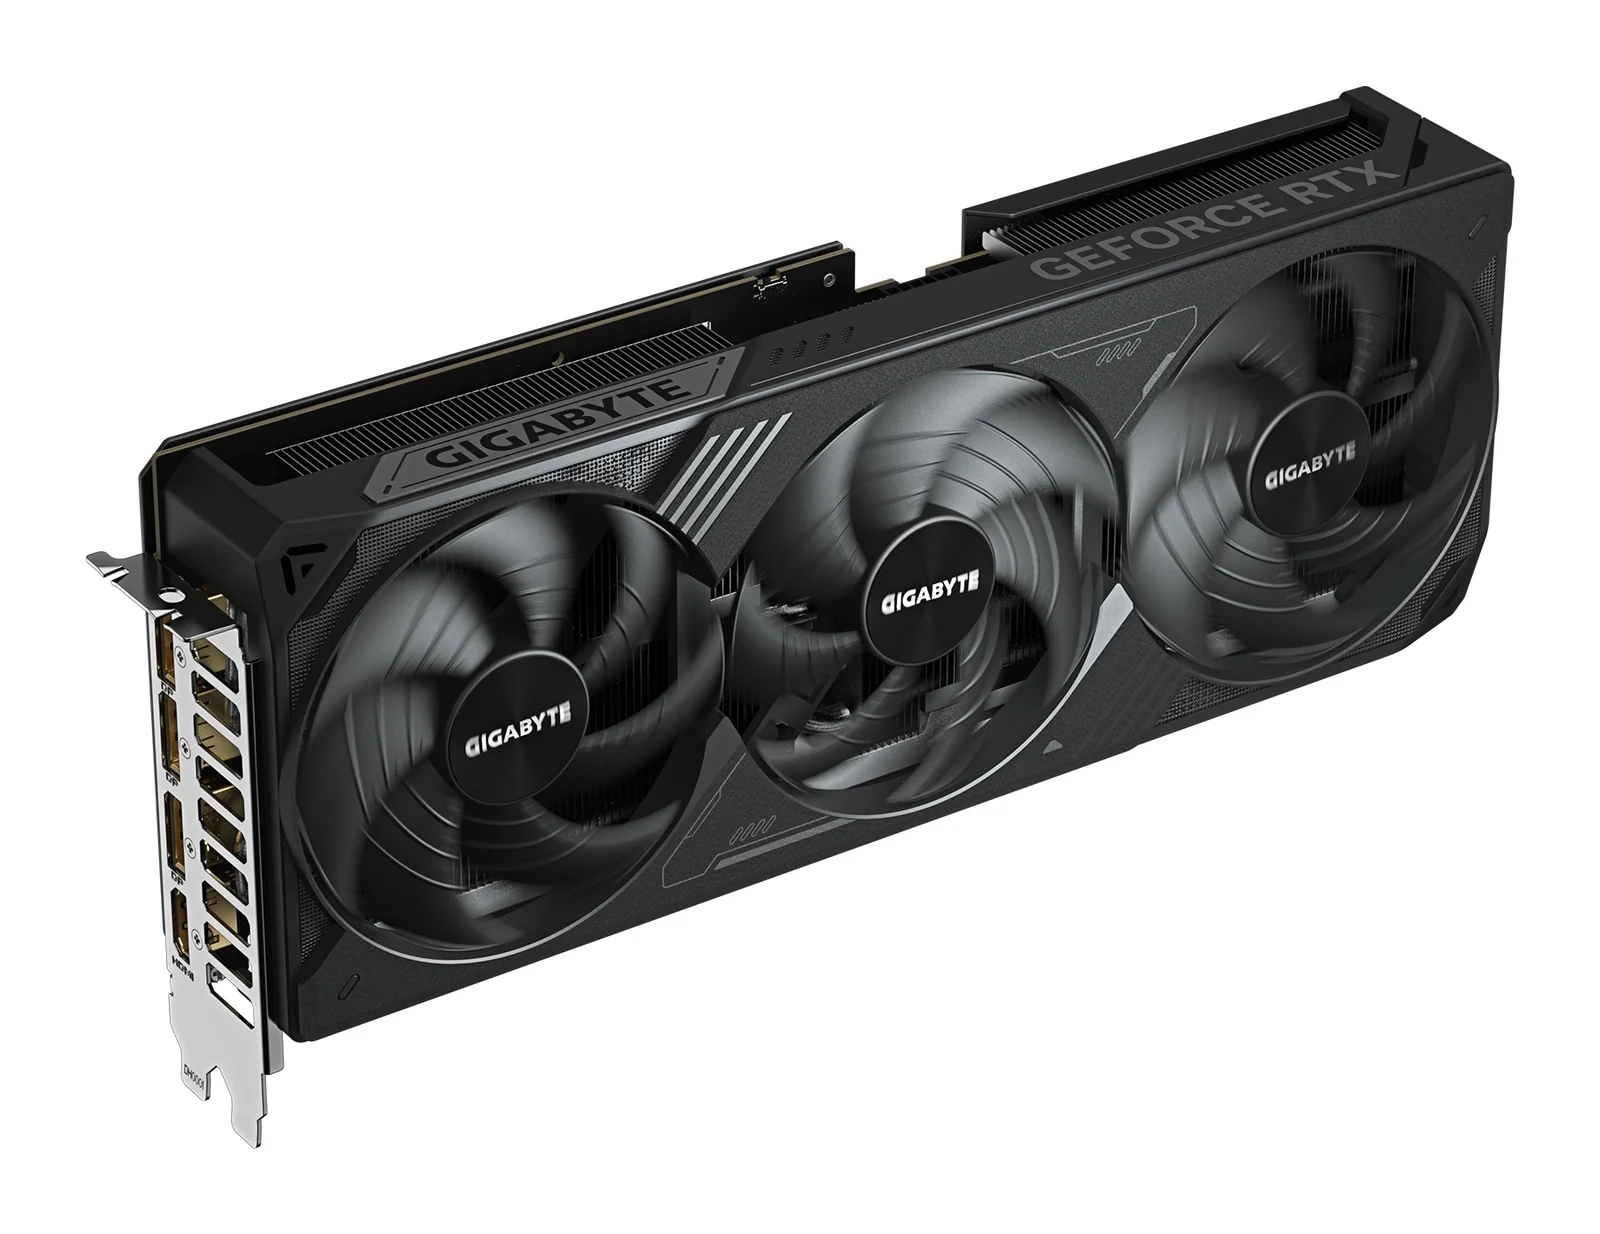
GIGABYTE
GIGABYTE GeForce RTX 5070 Ti WINDFORCE OC SFF 16G
- 16 GB
- NVIDIA GeForce RTX 5070 Ti (Blackwell)
Schafft bis zu 13–14B bei 4 Bit
Sie benötigt ein 16-Pin-Stromkabel oder den mitgelieferten Adapter, der zwei 8-Pin-PCIe-Kabel aufnimmt. GIGABYTE empfiehlt ein 750-W-Netzteil.
849 €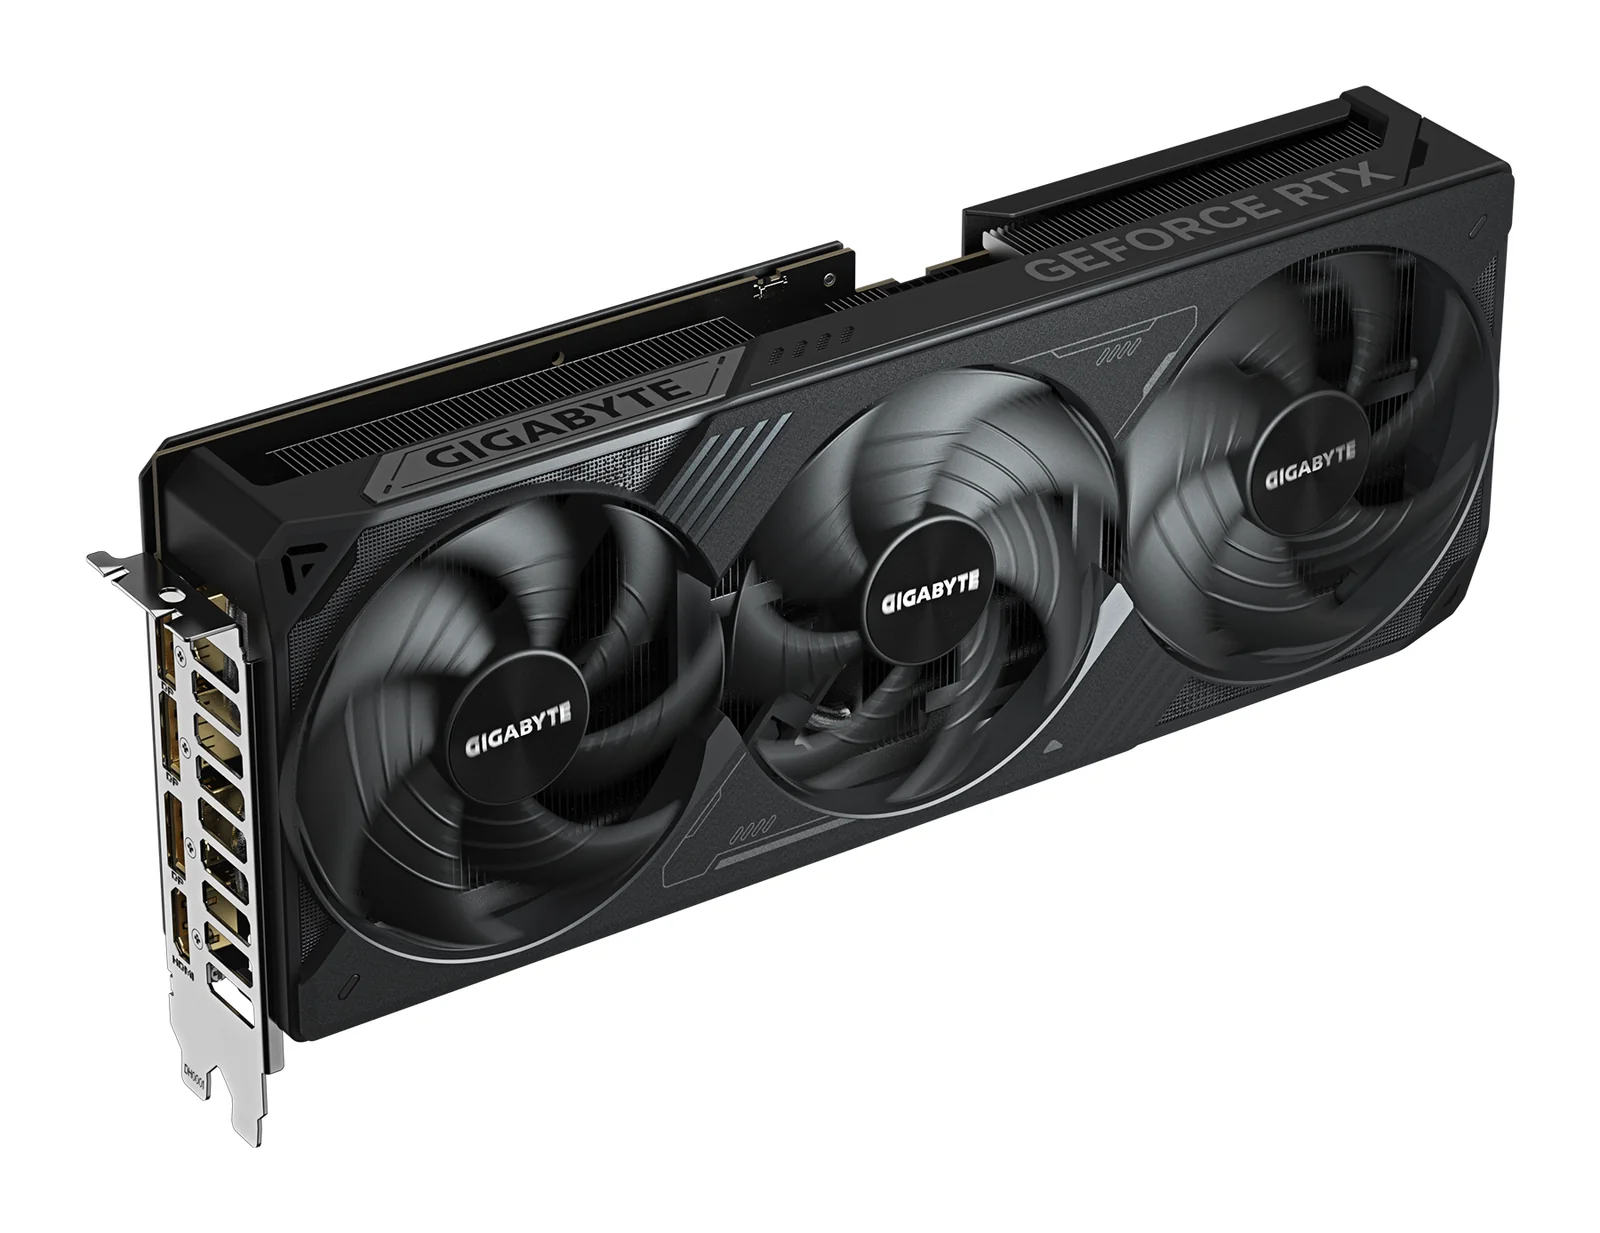
GIGABYTE
GIGABYTE GeForce RTX 5080 WINDFORCE OC SFF 16G
- 16 GB
- NVIDIA GeForce RTX 5080 (Blackwell)
Schafft bis zu 13–14B bei 4 Bit
Sie hat dieselben 16 GB wie die RTX 5070 Ti und passt daher nicht für größere KI-Modelle; sie führt sie nur schneller aus. Wer mehr Speicher auf einer Karte braucht, sollte sich die RTX 5090 oder eine Karte mit 24 bis 32 GB ansehen.
1.079 €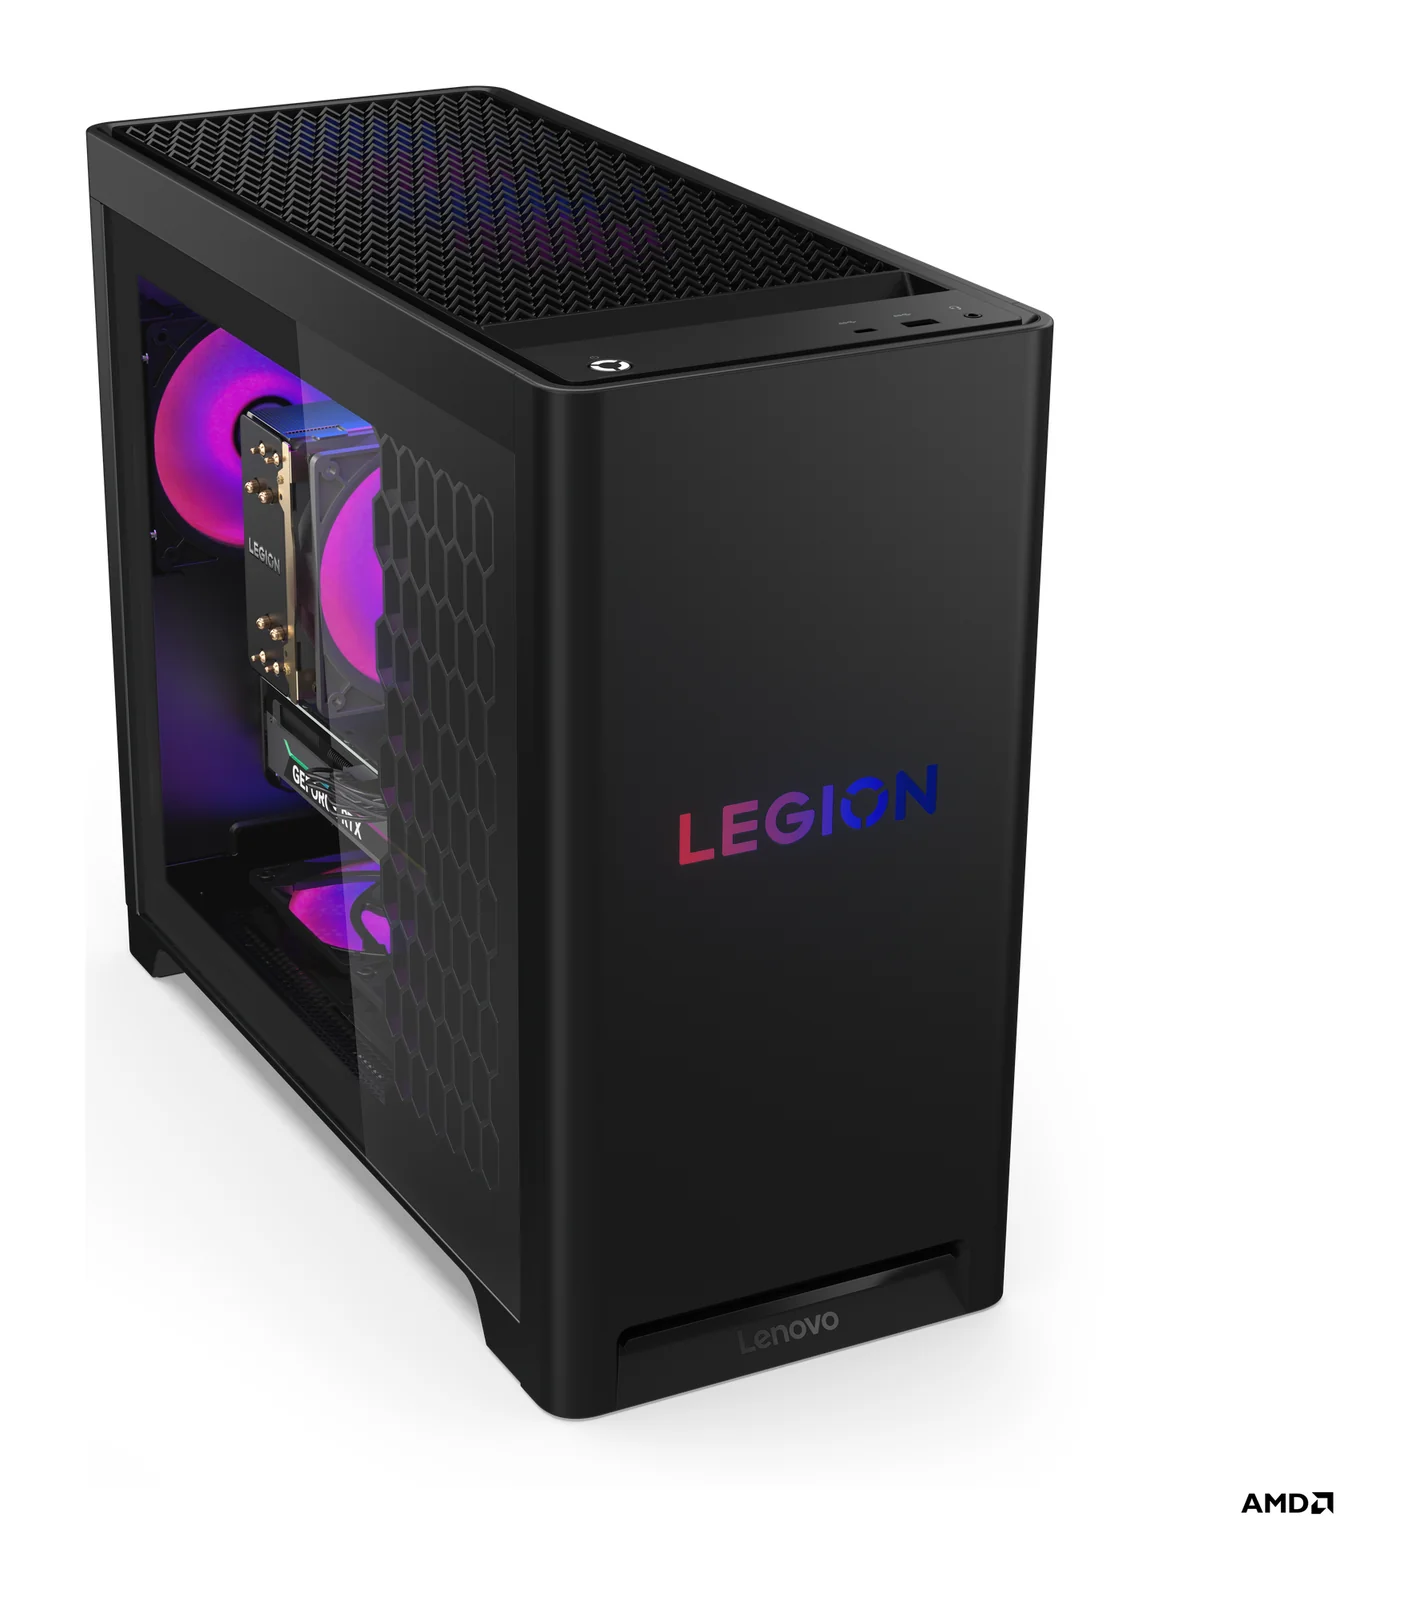
Lenovo
Lenovo Legion Tower 5 Gen 10 (RTX 5070 Ti)
- 32 GB
- AMD Ryzen 7 7800X3D (8 Kerne / 16 Threads, 4,2 / 5,0 GHz, 96 MB L3)
Der Arbeitsspeicher besteht aus zwei 16-GB-Modulen, und Lenovo gibt 32 GB als Maximum für diesen Tower an. Rechnen Sie also dauerhaft mit 32 GB. Beim Speicherplatz ist Luft nach oben: drei M.2-Steckplätze und ein 3,5-Zoll-Schacht.
2.159 €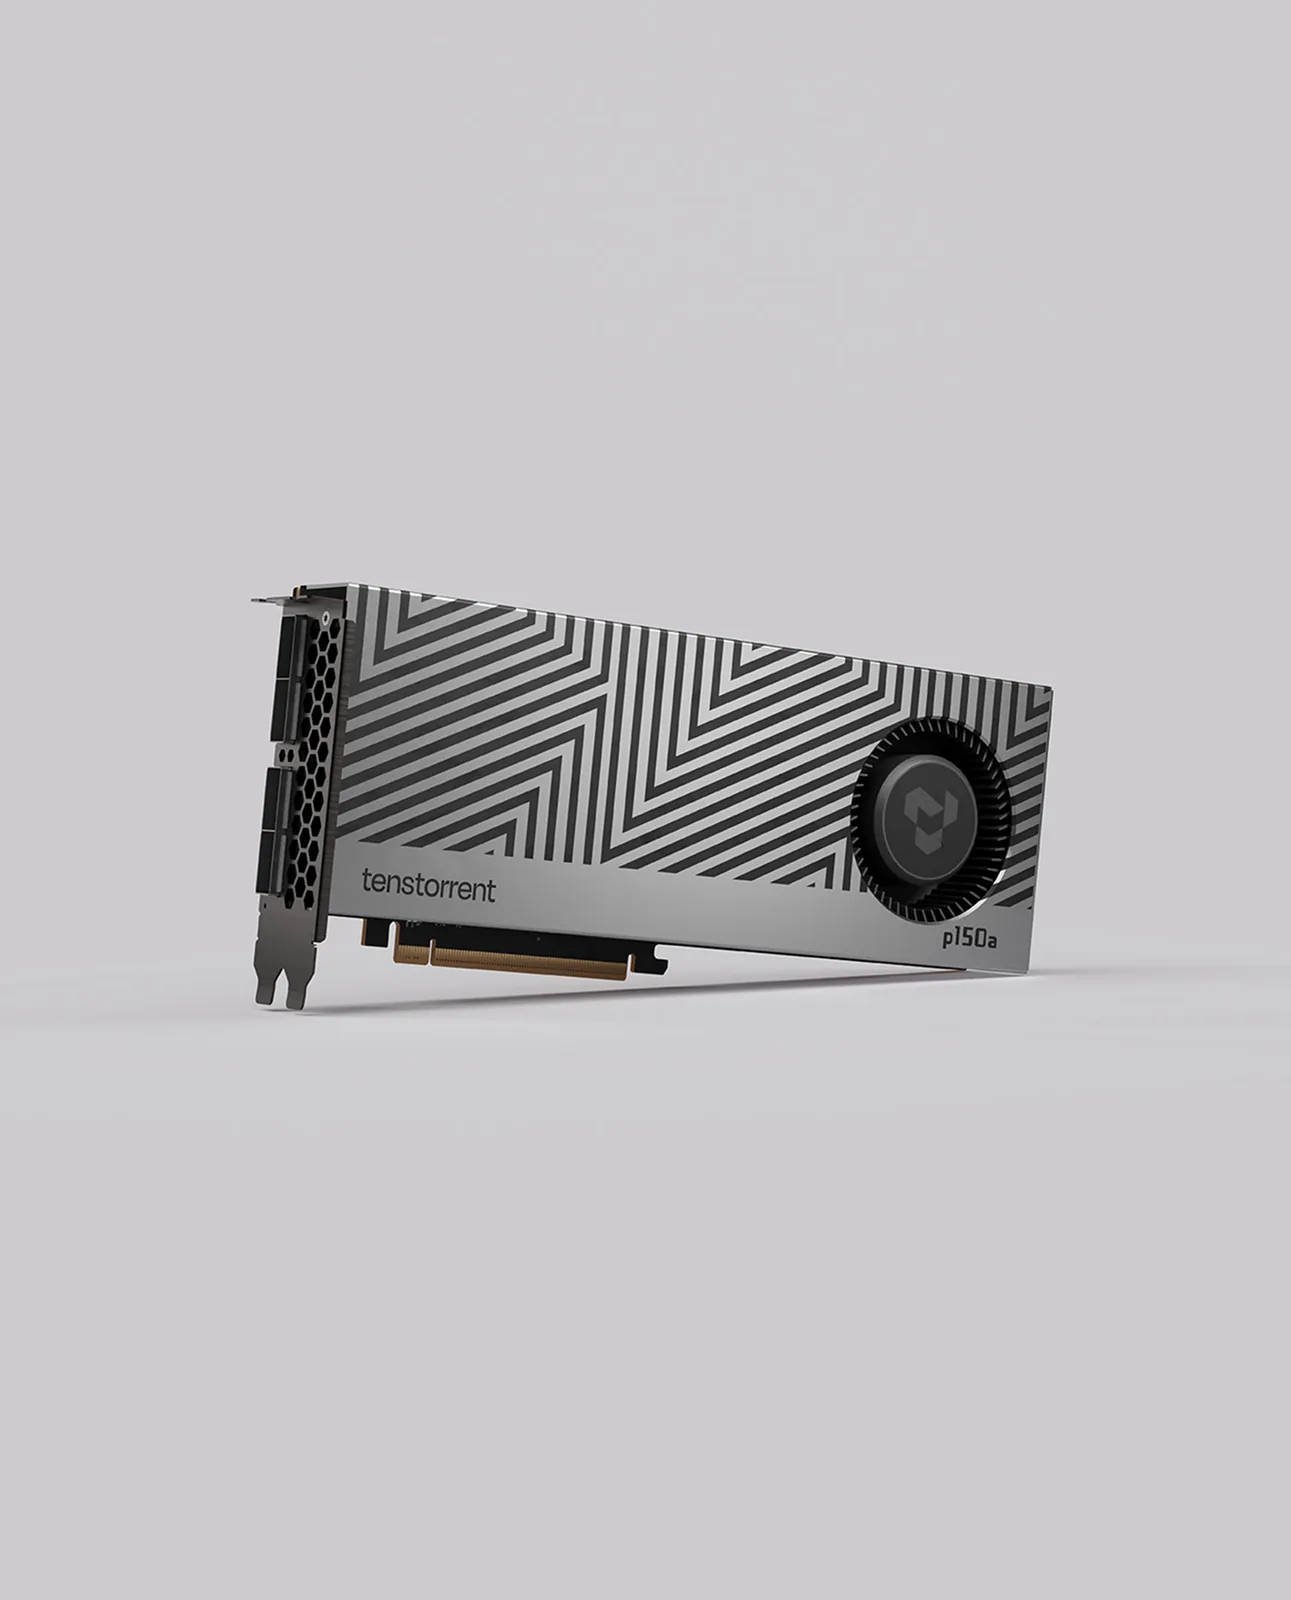
Tenstorrent
Tenstorrent Blackhole p150a
- 32 GB
- Tenstorrent Blackhole
Schafft bis zu 30–34B bei 4 Bit
Dies ist keine CUDA-Karte. Prüfen Sie vor dem Kauf, ob die benötigten Modelle in der Open-Source-Modellbibliothek von Tenstorrent unterstützt werden.
1.399 €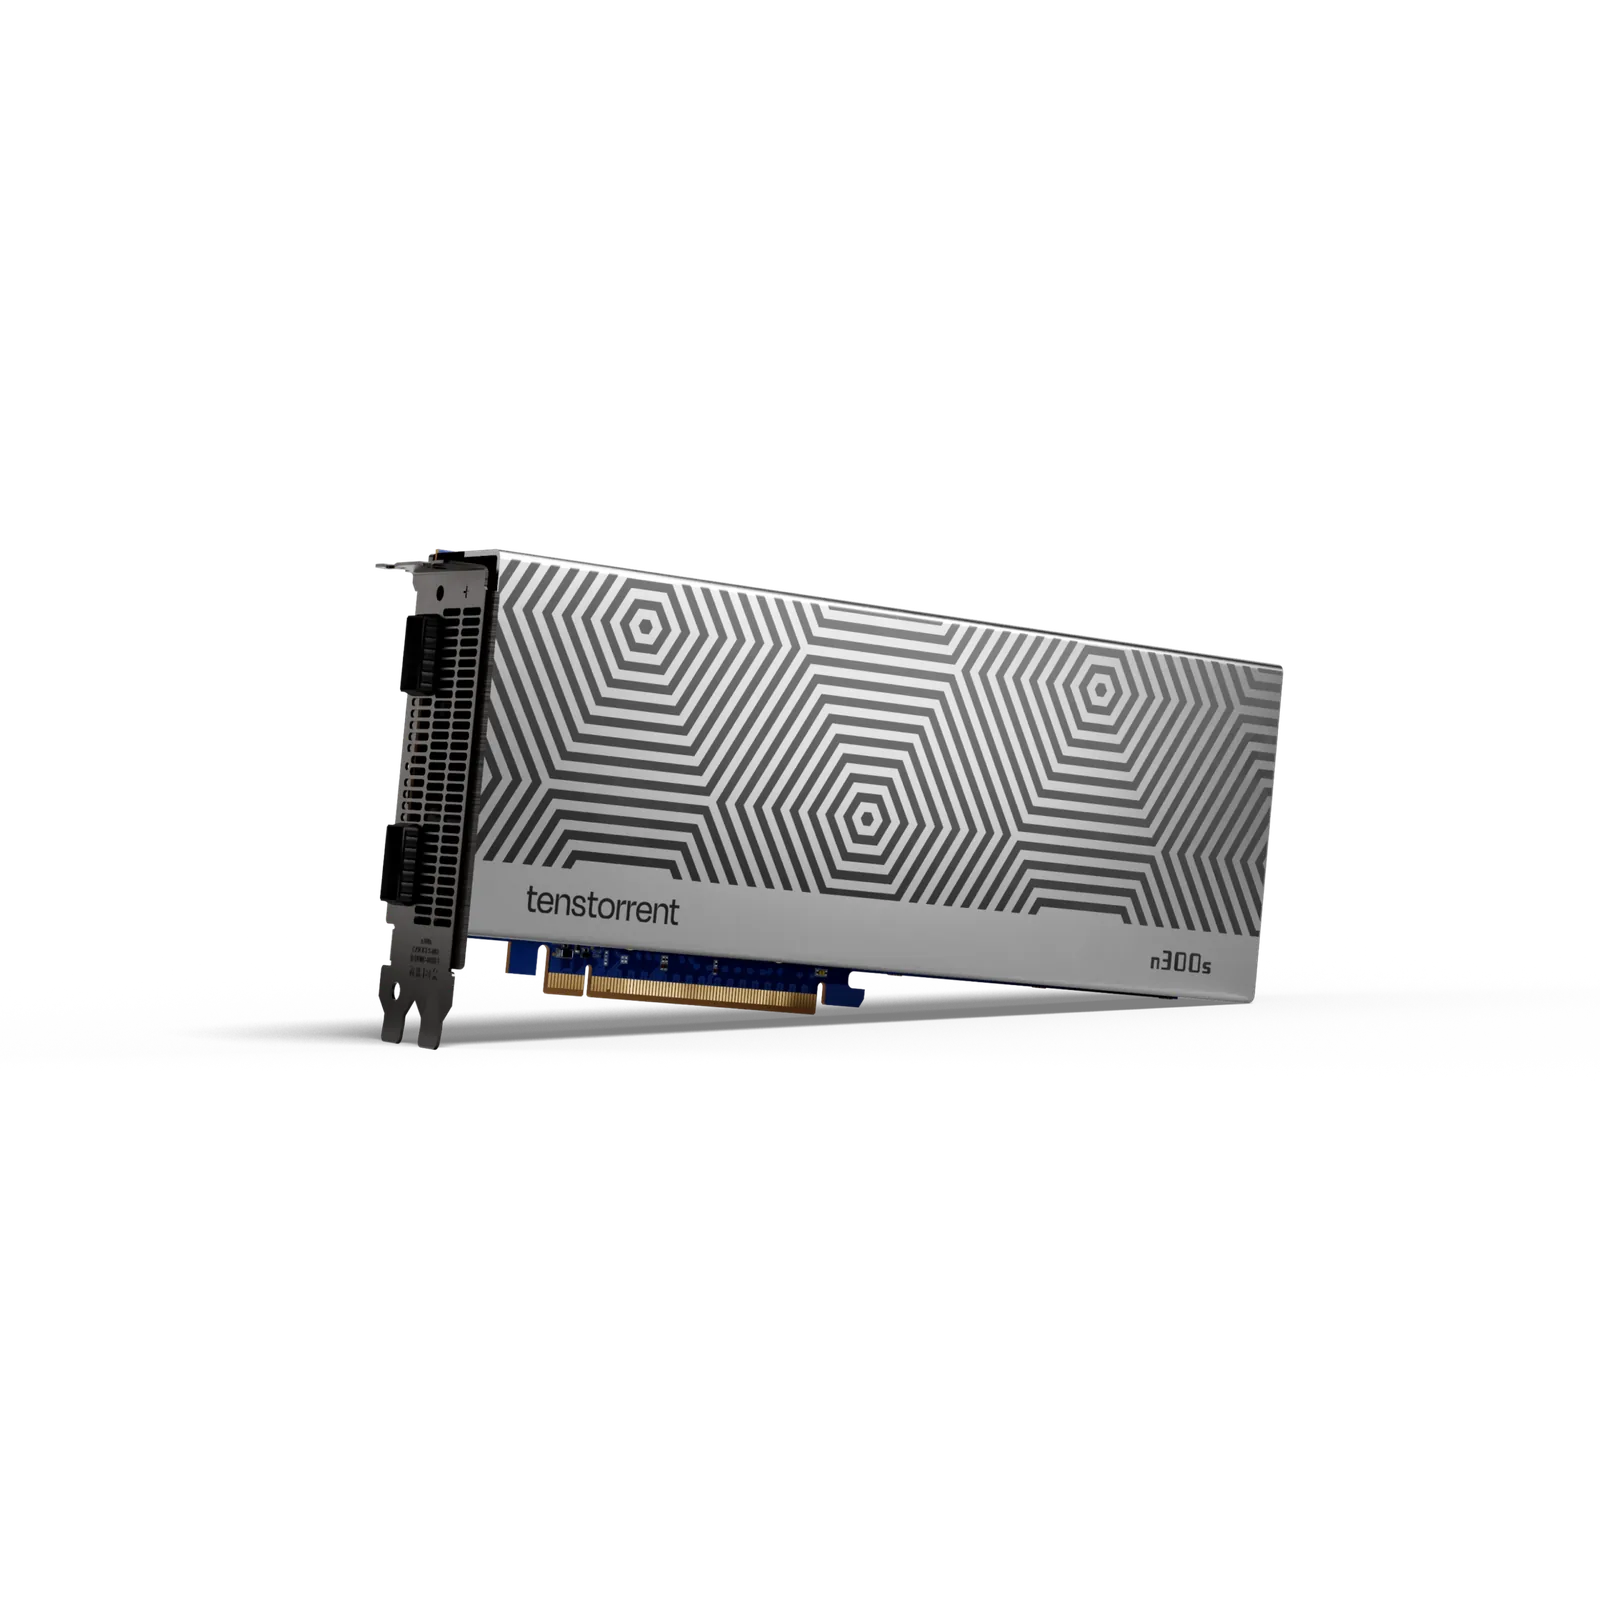
Tenstorrent
Tenstorrent Wormhole n300s
- 24 GB
Schafft bis zu 30–34B bei 4 Bit
Die 24 GB verteilen sich auf zwei Chips (je 12 GB), größere Modelle müssen also auf beide aufgeteilt werden. Prüfen Sie, ob es für Ihr gewünschtes Modell eine funktionierende Multi-Chip-Version gibt.
1.399 €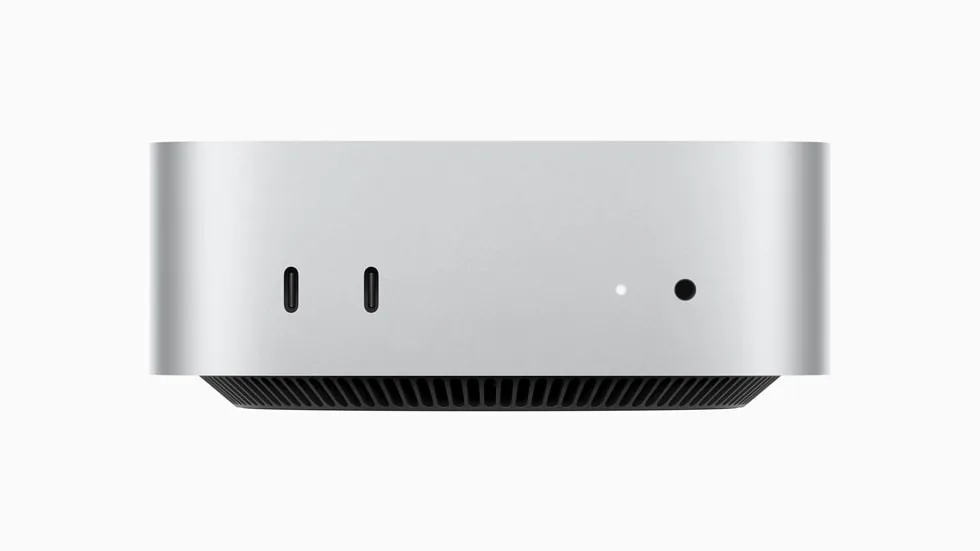
Apple
Apple Mac mini (M4 Pro)
- 24 GB Unified
- 16 Kerne; optional 20 Kerne
Schafft bis zu 13–14B bei 4 Bit
Der Arbeitsspeicher lässt sich nach dem Kauf nicht aufrüsten. Wenn lokale KI das Ziel ist, wählen Sie gleich 48 GB oder 64 GB. Mit 24 GB wird es bei Modellen über etwa 14B Parametern eng.
1.399 €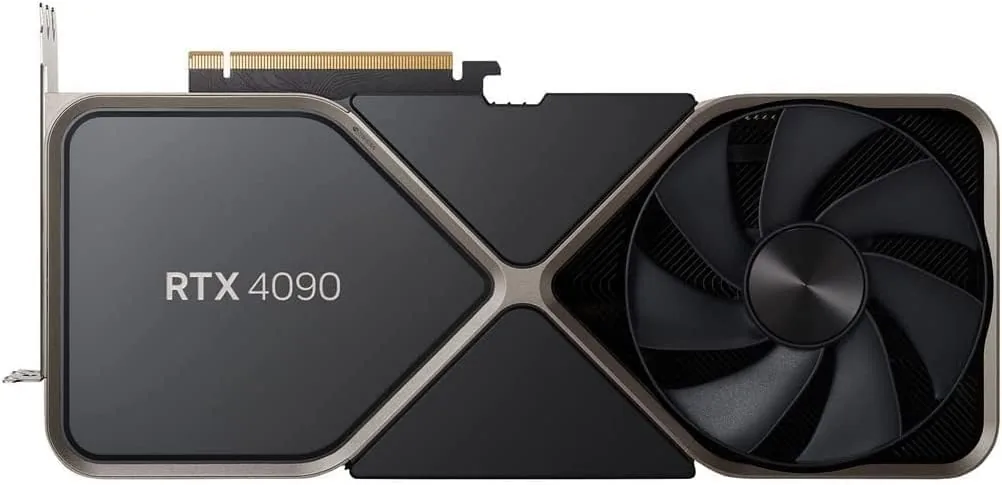
NVIDIA
NVIDIA GeForce RTX 4090
- 24 GB
- NVIDIA Ada Lovelace (AD102)
Schafft bis zu 30–34B bei 4 Bit
Stecken Sie das 16-Pin-Stromkabel vollständig in die Karte und vermeiden Sie enge Biegungen nahe am Stecker. Ein nicht ganz eingesteckter Stecker ist die häufigste Ursache für Probleme mit dieser Karte.
1.599 €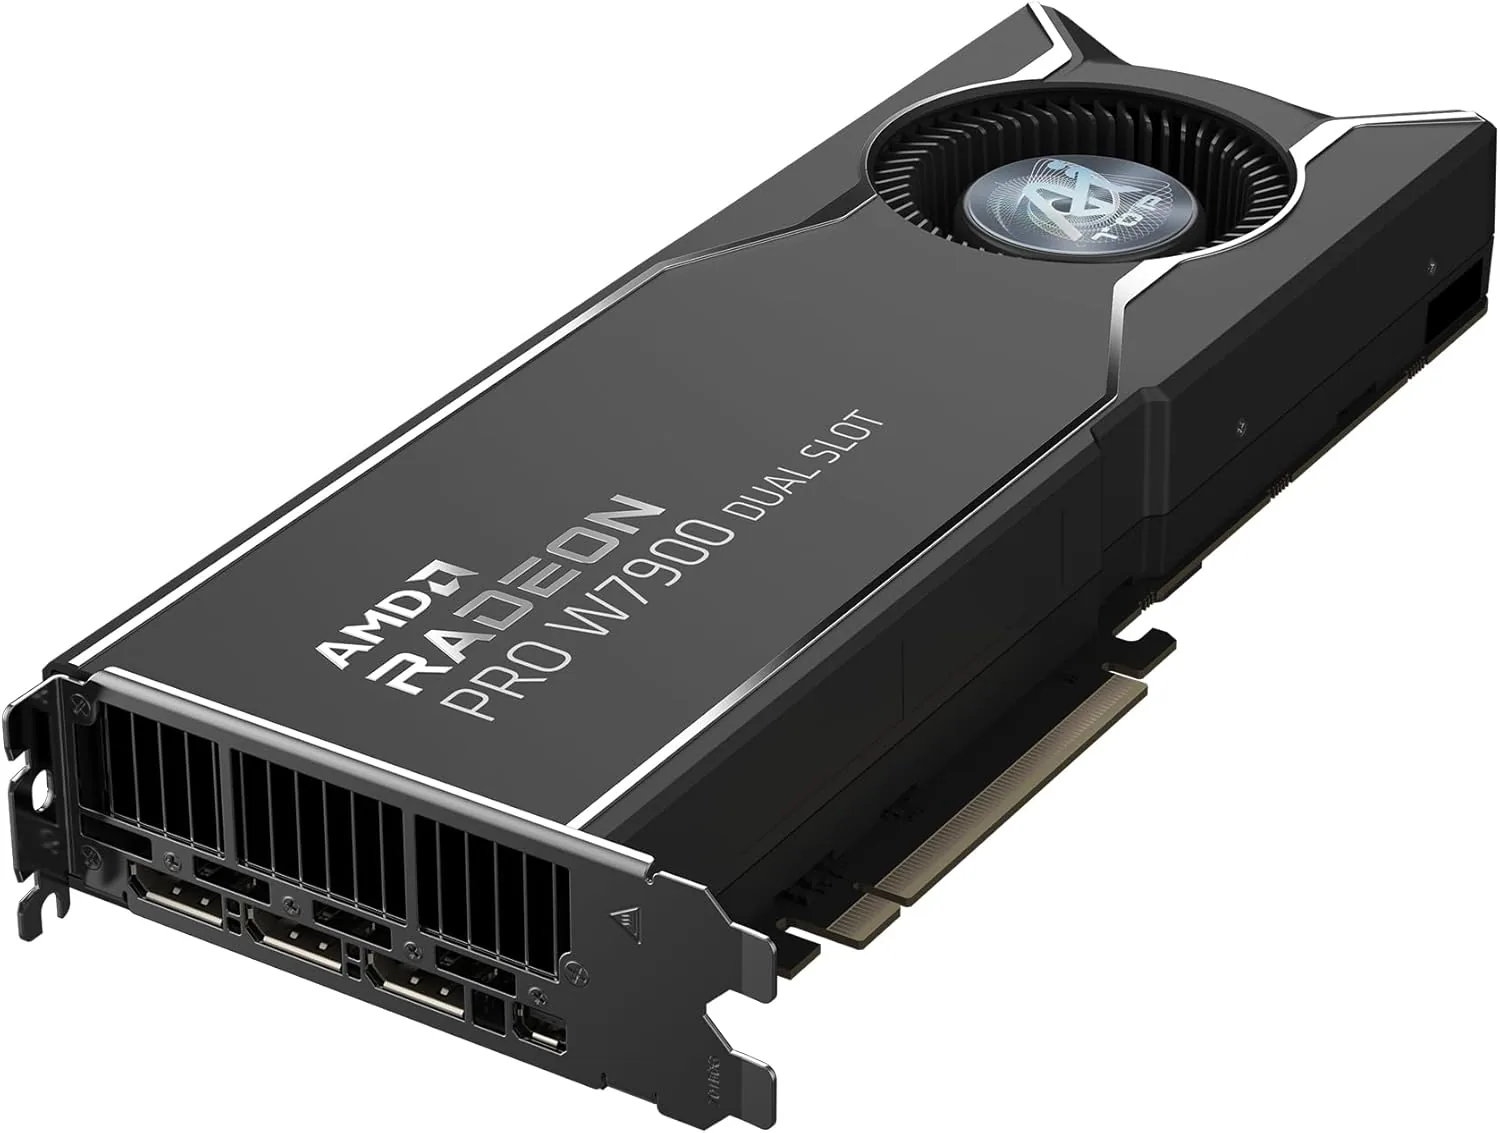
AMD
AMD Radeon PRO W7900 (48 GB)
- 48 GB
- AMD RDNA 3 (Navi 31)
Schafft bis zu 70B bei 4 Bit
Wählen Sie die W7900, wenn die Größe von Modell oder Szene entscheidend ist. Die neuere R9700 hat weniger Speicher (32 GB), unterstützt aber FP8 und ist bei KI effizienter pro Watt.
3.592 €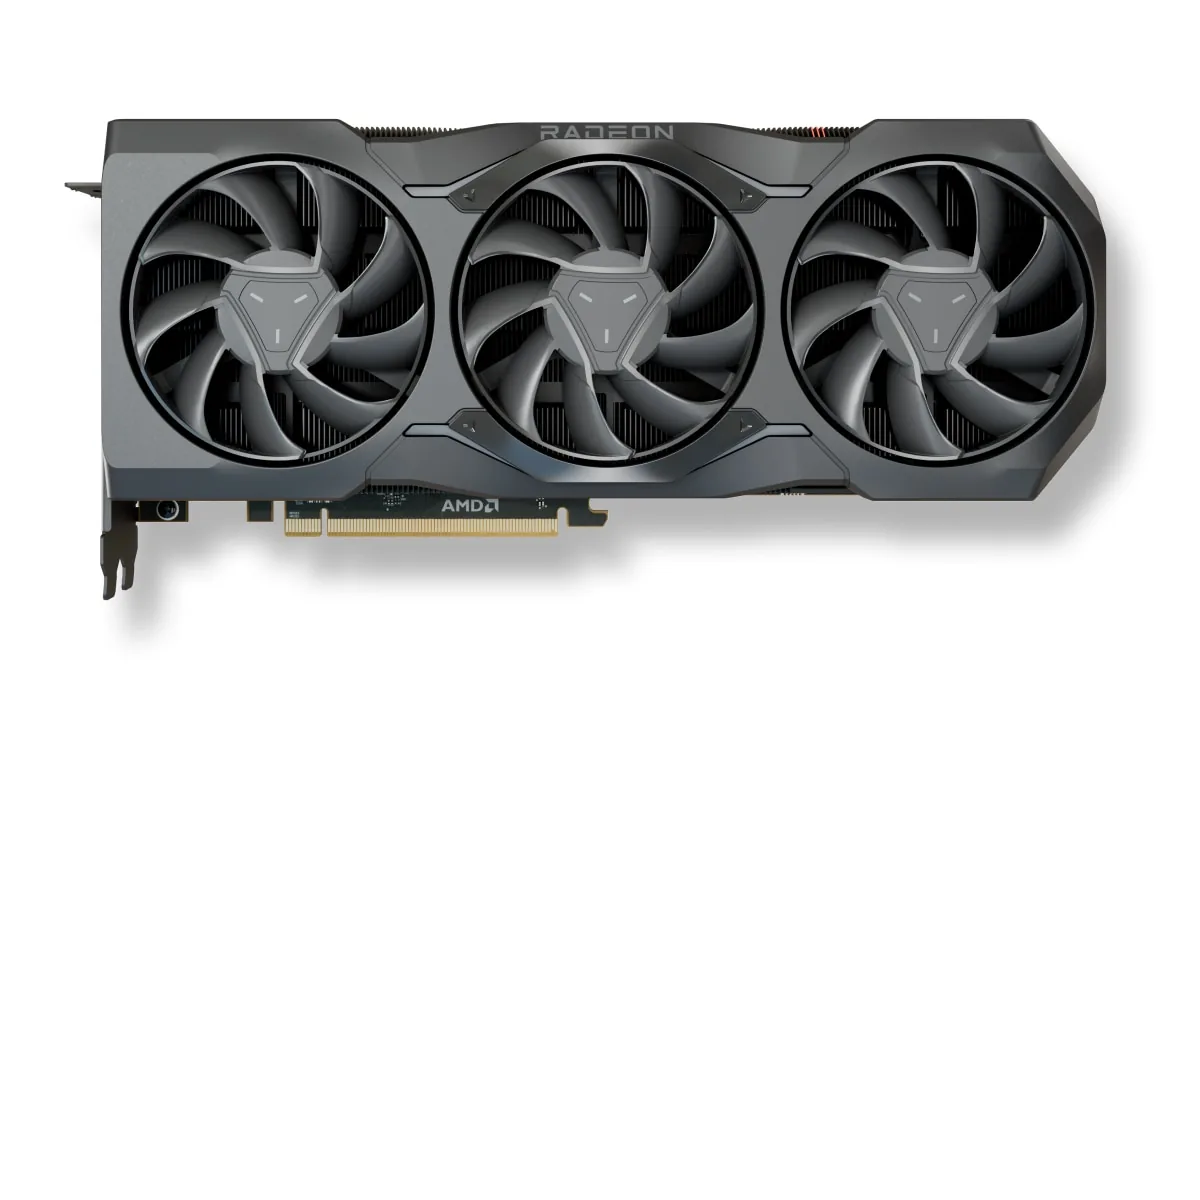
SAPPHIRE
SAPPHIRE PULSE AMD Radeon RX 7900 XTX 24GB
- 24 GB
- AMD RDNA 3 (Navi 31)
Schafft bis zu 30–34B bei 4 Bit
Die PULSE ist 313 mm lang, 2,7 Slots dick und hat drei 8-Pin-Stromanschlüsse. Messen Sie vor der Bestellung Ihr Gehäuse aus und prüfen Sie Ihr Netzteil (mindestens 800 W).
899 €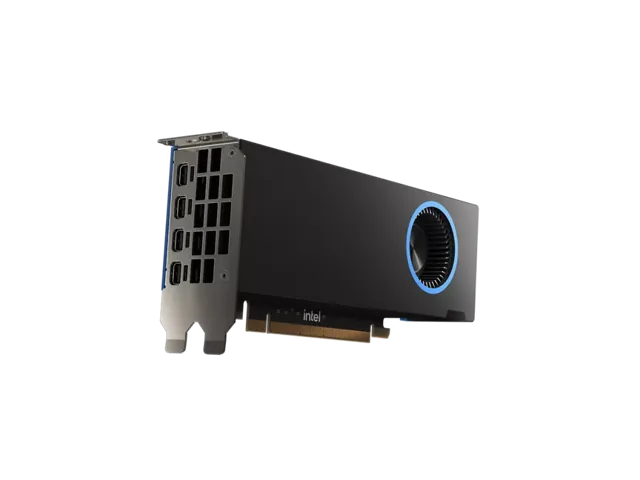
Intel
Intel Arc Pro B50
- 16 GB
- Intel Xe2 (Battlemage)
Schafft bis zu 13–14B bei 4 Bit
Ein Stromkabel ist nicht nötig, daher eignet sie sich für kompakte Rechner. 16 GB reichen für Modelle mit 7B bis 14B bei 4 Bit; größere Modelle brauchen eine größere Karte.
299 €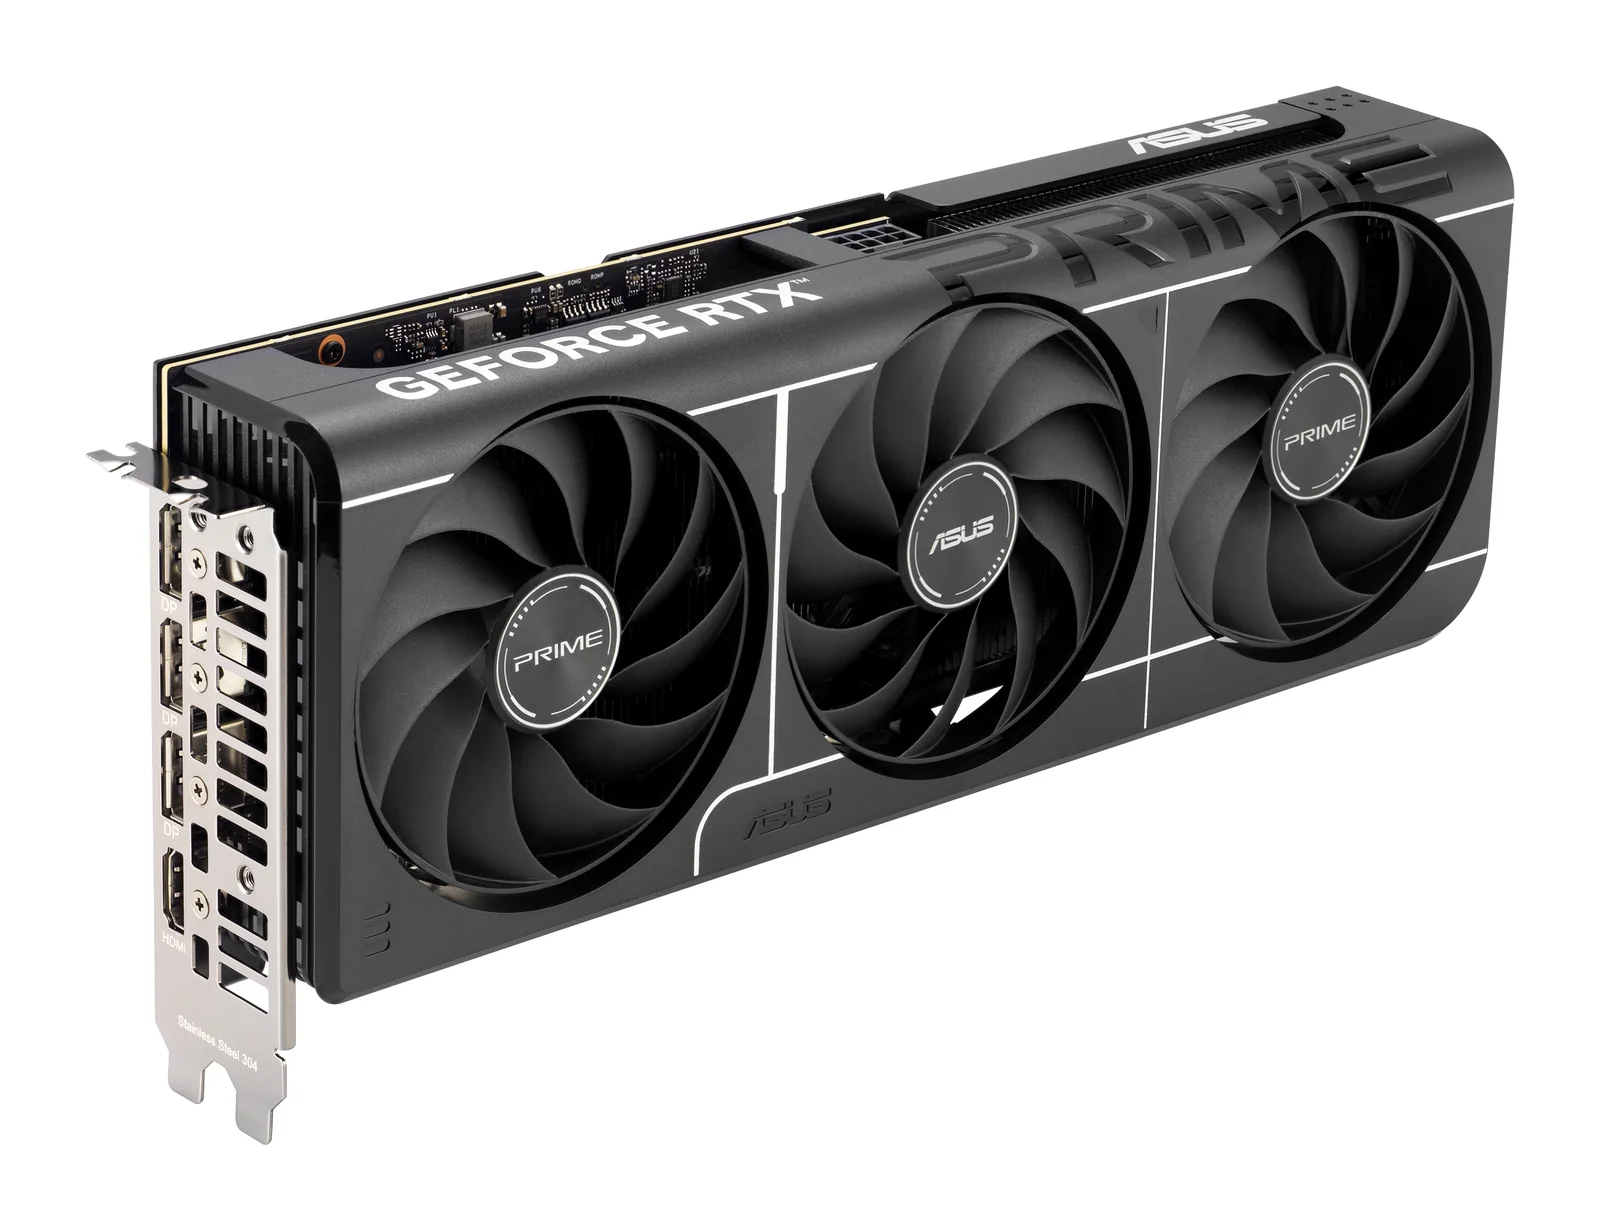
ASUS
ASUS Prime GeForce RTX 5060 Ti 16GB OC Edition
- 16 GB
- NVIDIA GeForce RTX 5060 Ti (Blackwell)
Schafft bis zu 13–14B bei 4 Bit
Für lokale KI kommt nur die 16-GB-Version infrage, und das ist diese. Ihr 128-Bit-Speicherinterface ist schmaler als bei den größeren Karten, daher erzeugen Modelle Text langsamer als auf einer RTX 5070 Ti.
369 €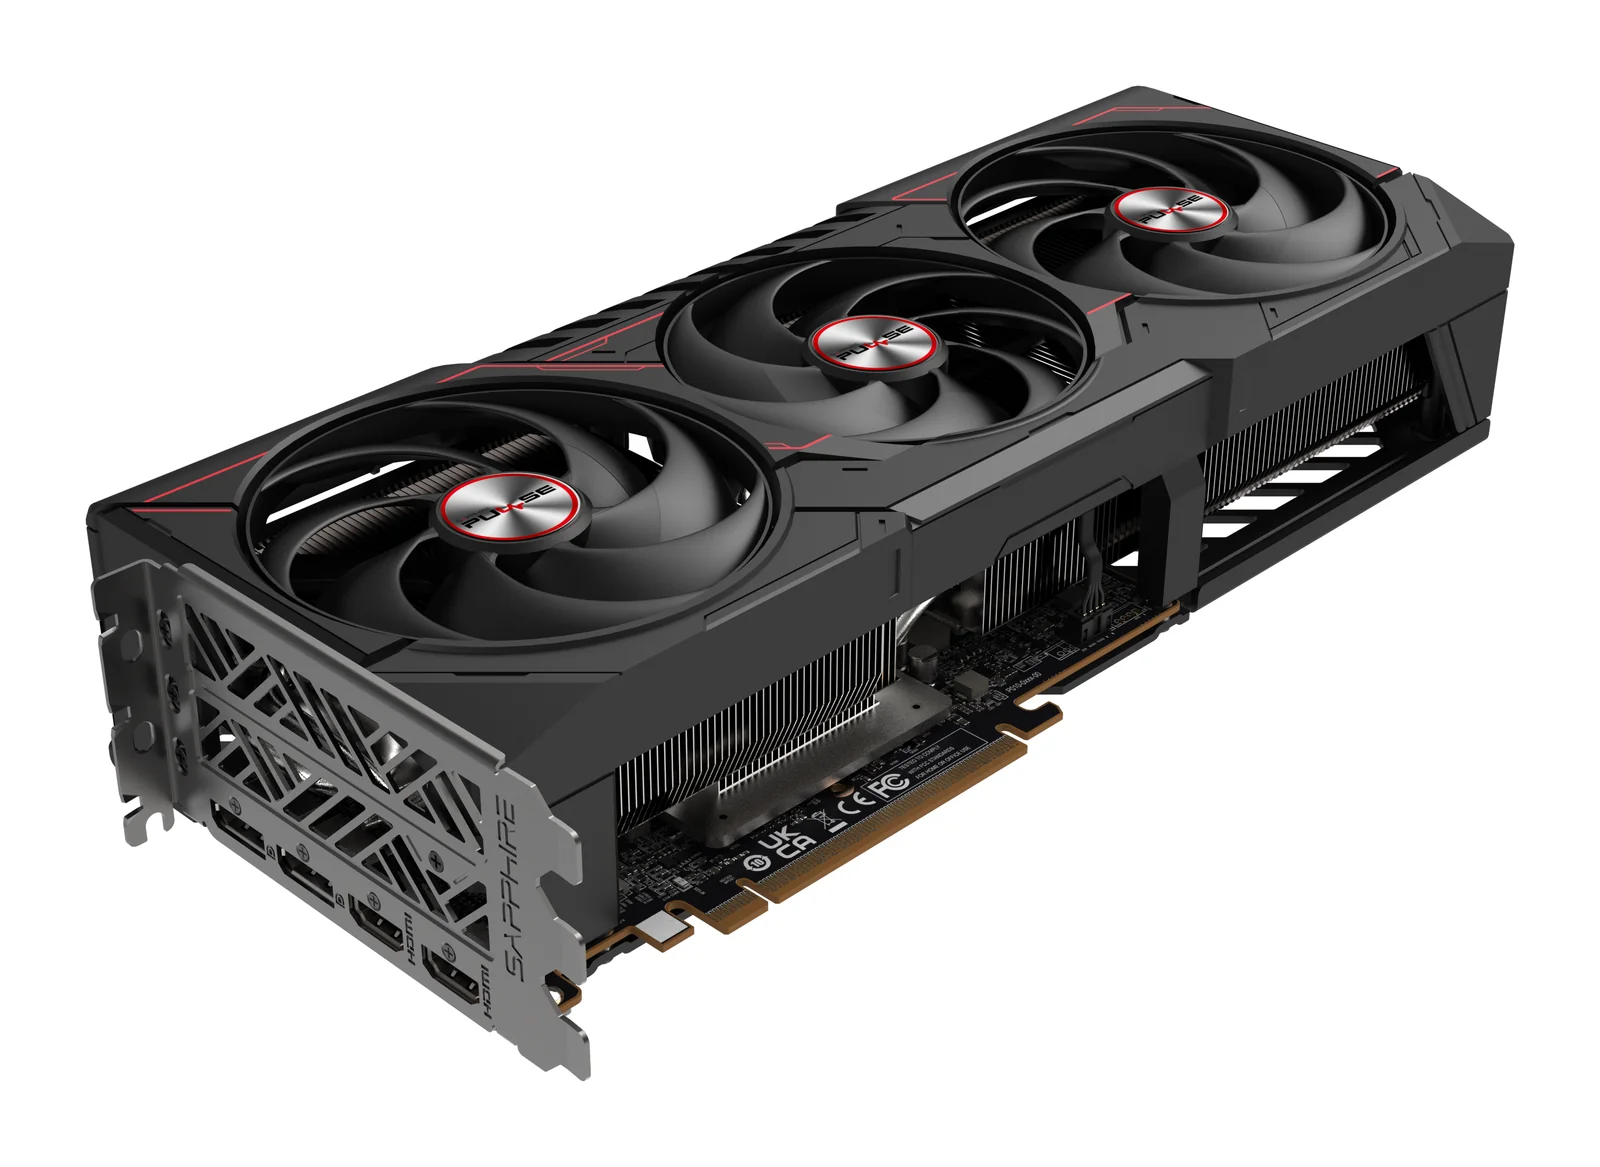
SAPPHIRE
SAPPHIRE PULSE AMD Radeon RX 9070 XT 16GB
- 16 GB
- AMD Radeon RX 9070 XT (RDNA 4)
Schafft bis zu 13–14B bei 4 Bit
Die Karte ist 320 mm lang, belegt drei Slots und benötigt zwei 8-Pin-Stromkabel. SAPPHIRE empfiehlt mindestens ein 750-W-Netzteil. Messen Sie deshalb vorher Ihr Gehäuse aus.
519 €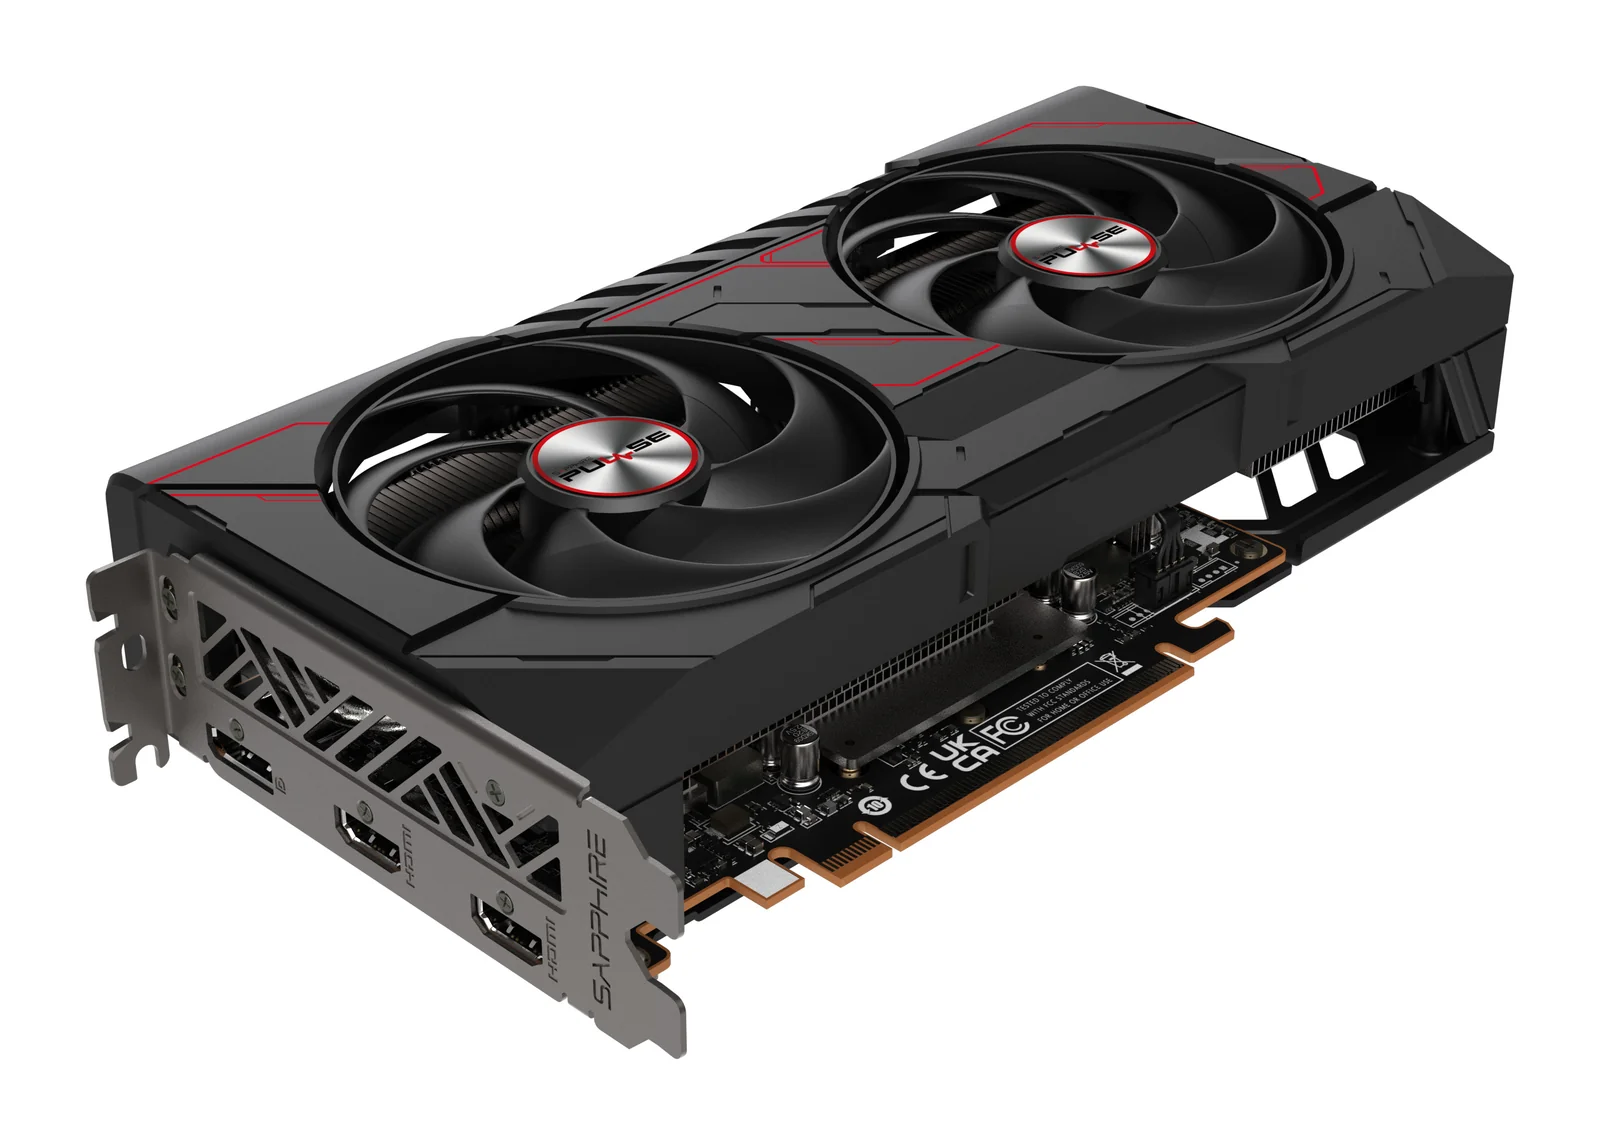
SAPPHIRE
SAPPHIRE PULSE AMD Radeon RX 9060 XT 16GB
- 16 GB
- AMD Radeon RX 9060 XT (RDNA 4)
Schafft bis zu 13–14B bei 4 Bit
Dies ist die Version mit 16 GB. Die 8-GB-Version ist eine andere Karte, und ihr wird der Speicher in neuen Spielen bereits knapp. Ein 8-Pin-Kabel und ein 450-W-Netzteil reichen aus.
299 €So wählen Sie Hardware für lokale KI
- Nutzbaren Speicher zählen, nicht die Nenngröße
- Unser Modell-Ratgeber rechnet 90 % des Grafikspeichers einer Grafikkarte als nutzbar und 75 % des gemeinsamen Arbeitsspeichers, weil das Betriebssystem einen Teil des gemeinsamen Speichers selbst belegt. Ein Mac mit 64 GB stellt Modellen rund 48 GB bereit, eine Karte mit 48 GB rund 43 GB.
- Speicher passend zur Modellgröße
- Bis 14B mit 4 Bit: eine Karte mit 16 GB oder ein Mac mini mit 24 GB. 30B-Klasse mit 4 Bit: eine Karte mit 24 GB oder 32 GB. 70B mit 4 Bit: eine Karte mit 48 GB, zwei Karten mit 24 GB oder ab 64 GB gemeinsamer Arbeitsspeicher. 70B mit 8 Bit und 120B-Klasse mit 4 Bit: eine Karte mit 96 GB oder ein Rechner mit 128 GB gemeinsamem Arbeitsspeicher.
- Die Plattform wählen, die Ihre Tools brauchen
- NVIDIA, wenn Ihre Tools CUDA brauchen oder Sie auch spielen. Ein Mac Studio für große Modelle in einem nahezu lautlosen Gehäuse. Ein Mini-PC mit Ryzen AI Max+ für 128 GB unter Windows oder Linux. Die DGX Spark, wenn Sie mit CUDA entwickeln und auf größeren NVIDIA-Systemen bereitstellen.
- Passt das Modell, entscheidet die Bandbreite über das Tempo
- Für jedes neue Token werden die Gewichte gelesen, daher schreibt ein Modell auf einem Rechner mit höherer Speicherbandbreite schneller: 1.792 GB/s bei der RTX 5090, 819 GB/s beim Mac Studio, 273 GB/s beim Mac mini M4 Pro und bei der DGX Spark.
- Wann ein günstigerer Rechner genügt
- Chat, Zusammenfassungen, Code-Vervollständigung und die Suche in eigenen Dokumenten funktionieren mit Modellen von 7B bis 14B, die in 16 GB passen. Dafür reicht die Arc Pro B50 oder ein Mac mini mit 24 GB. Planen Sie Reserven ein, wenn Sie mit langen Dokumenten arbeiten.
Häufige Fragen
Läuft ein 70B-Modell auf einer einzigen Grafikkarte?
Nur auf einer Karte mit 48 GB oder mehr. Die Radeon PRO W7900 (48 GB) fasst es in 4 Bit gerade so, die RTX PRO 6000 (96 GB) auch in 8 Bit. Eine 32-GB-Karte wie die RTX 5090 reicht dafür nicht.
Was bedeuten 4 Bit und 8 Bit für die benötigte Hardware?
Mit 4 Bit belegt das Modell etwa halb so viel Speicher wie mit 8 Bit, bei leichtem Qualitätsverlust; so betreiben die meisten Nutzer Modelle zu Hause. 8 Bit erhält mehr Qualität und braucht etwa doppelt so viel Speicher, was sich beim Programmieren oder bei exakter Datenextraktion lohnt.
Wie viel zusätzlichen Speicher brauchen lange Chats und Dokumente?
Der Kontextspeicher wächst mit jedem Token, das das Modell im Blick behält, planen Sie also mehr ein, als das Modell allein belegt. Wählen Sie die nächsthöhere Speichergröße statt einer, in die das Modell gerade so passt.
Eignet sich Hardware für lokale KI auch für Fine-Tuning?
Fine-Tuning braucht mehr Speicher als der reine Betrieb eines Modells. Parametereffiziente Verfahren wie LoRA senken diesen Bedarf deutlich; für CUDA-basierte Arbeit bietet die DGX Spark mit 128 GB Platz für Größen, die eine 32-GB-Karte nicht erreicht.
Können Sie einen Rechner für die Modelle zusammenstellen, die ich nutzen möchte?
Ja. Senden Sie eine Anfrage für eine Wunschkonfiguration mit den gewünschten Modellen, Ihrem Budget und Ihrem Land. Wir antworten mit einer Konfiguration und einem Angebot.
Verwandte Seiten: Grafikkarten · Mini-PCs · Apple · KI-Beschleuniger
Ratgeber
Lokale KI · 5 Min. Lesezeit
Wie viel Arbeitsspeicher braucht ein lokales LLM?
So ermitteln Sie, wie viel Arbeitsspeicher ein lokales LLM braucht: 7B- bis 120B+-Modelle mit 4 und 8 Bit, Unified Memory vs. VRAM und passende Rechner.
Ratgeber lesen →Lokale KI · 5 Min. Lesezeit
Mac, NVIDIA oder Ryzen AI Max+ für lokale KI
Mac, NVIDIA oder Ryzen AI Max+: CUDA bei NVIDIA, gemeinsamer Arbeitsspeicher beim Mac oder 128 GB im Mini-PC. Speicher, Software und Kompromisse.
Ratgeber lesen →Grafikkarten · 5 Min. Lesezeit
GPU für lokale KI wählen: RTX 5090, R9700, B60
GPU für lokale KI nach Speicher, Software und Bandbreite wählen: RTX 5090, Radeon AI PRO R9700, Arc Pro B60 sowie Workstation-Karten mit 48 und 96 GB.
Ratgeber lesen →