Kategorie
KI-Beschleunigerkarten und Desktops für die Modellentwicklung
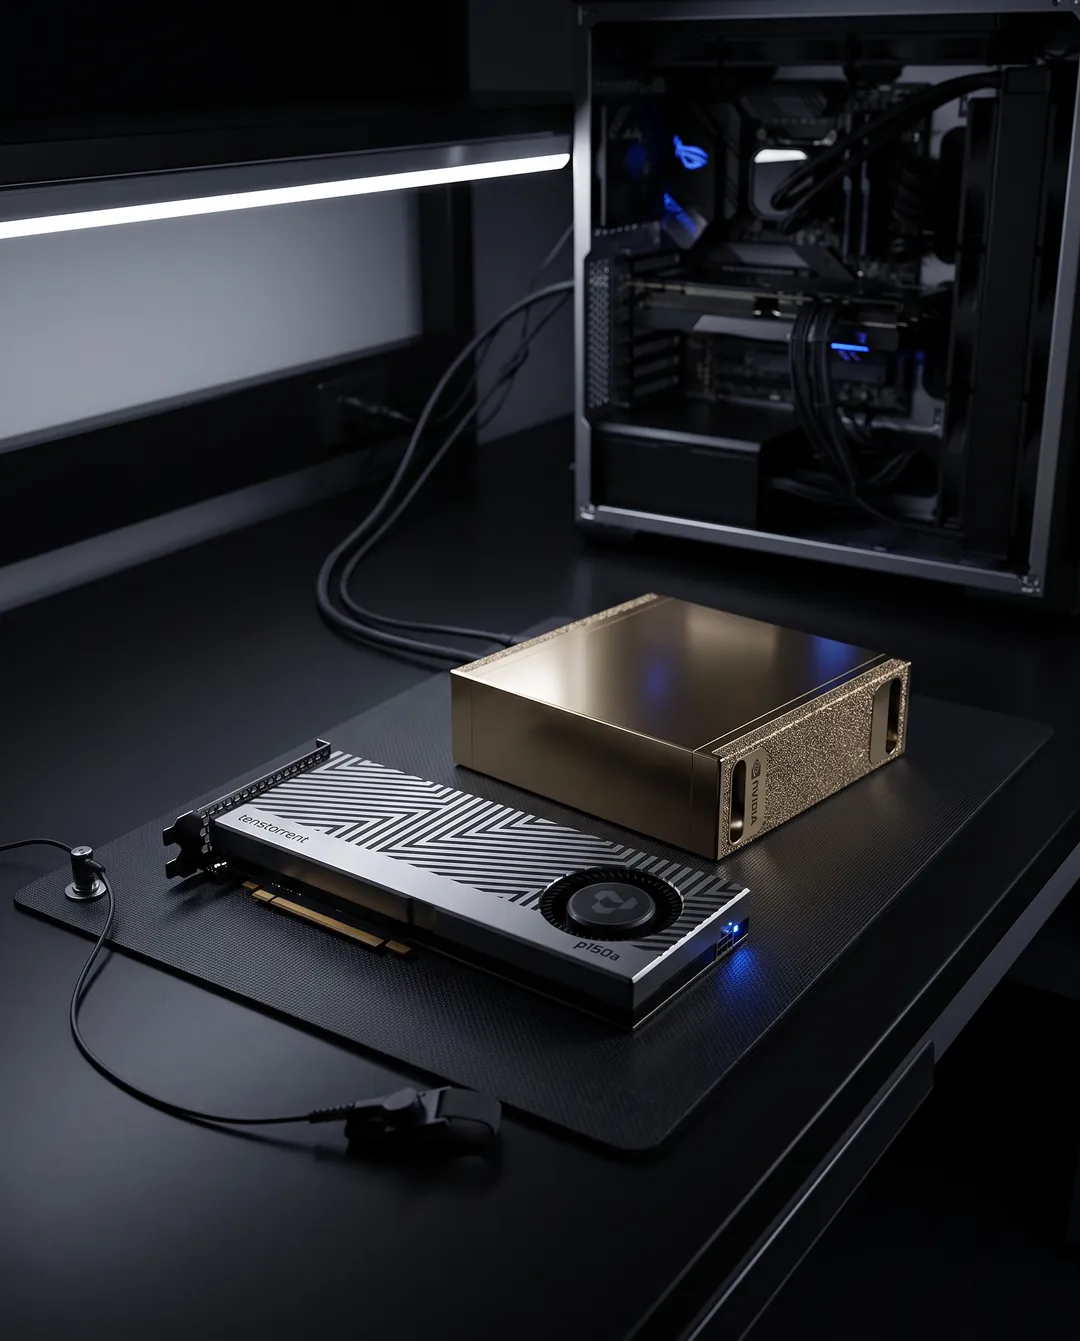
KI-Beschleunigerkarten und Desktops, die zuerst für KI gebaut sind: Tenstorrent-Karten mit quelloffenem Software-Stack und der Desktop NVIDIA DGX Spark.
Entscheiden Sie bei einem KI-Beschleuniger zuerst nach der Software. Der NVIDIA DGX Spark ist ein CUDA-Entwicklungsrechner mit 128 GB, dessen Code sich auf größere DGX-Systeme und in die Cloud übertragen lässt. Die Tenstorrent-Karten nutzen einen vollständig quelloffenen Stack, den Sie bis hinunter zu den Kernels programmieren können. Wenn Sie große Modelle vor allem schnell ausführen statt entwickeln wollen, passt ein Mac Studio oder eine Grafikkarte oft besser.
Unsere Auswahl
CUDA-Entwicklung mit 128 GB
DGX Spark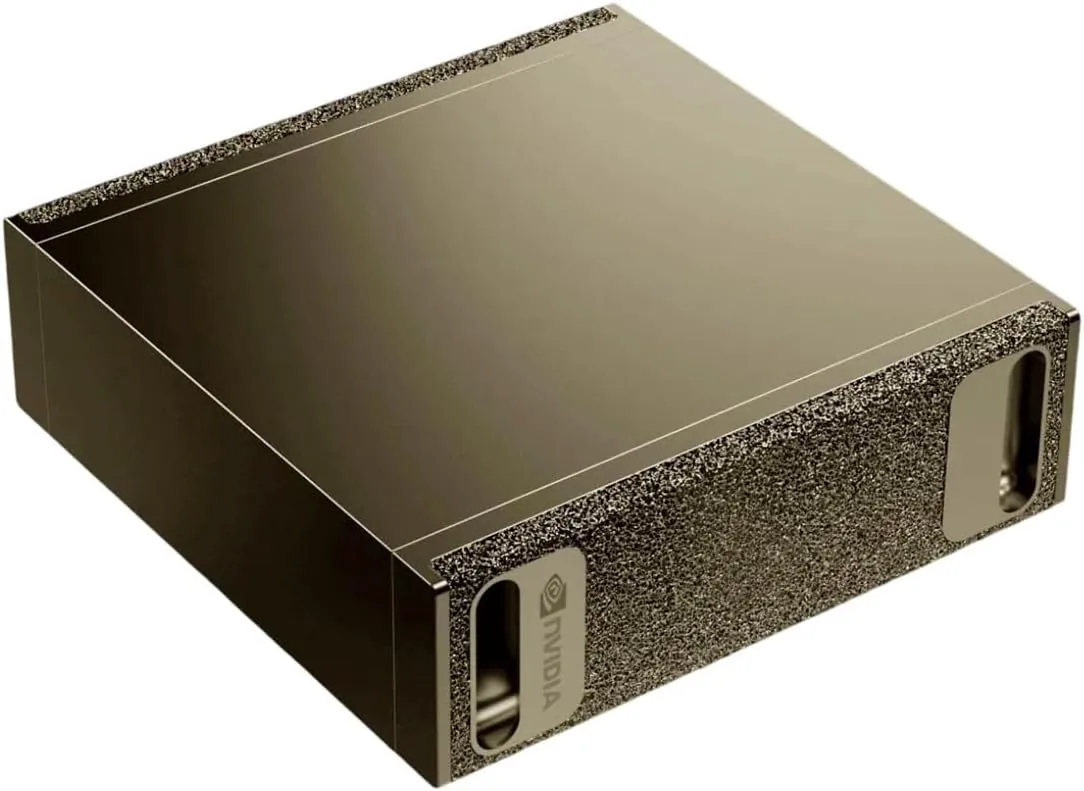
NVIDIA
NVIDIA DGX Spark
- 128 GB Unified
- NVIDIA GB10 Grace Blackwell
Schafft bis zu 120B+ bei 4 Bit
Seine Speicherbandbreite (273 GB/s) ist geringer als die einer High-End-Grafikkarte, daher erzeugen große dichte Modelle Text langsamer als auf einer RTX 5090. Seine Stärken sind die Kapazität und der CUDA-Software-Stack.
4.699 €Ein quadratischer Desktop-Rechner mit 150 mm Kantenlänge und NVIDIAs Software-Stack, für Prototyping und Fine-Tuning vor dem Wechsel auf größere NVIDIA-Hardware.
Der meiste Speicher auf einer Karte mit offenem Stack
Tenstorrent Blackhole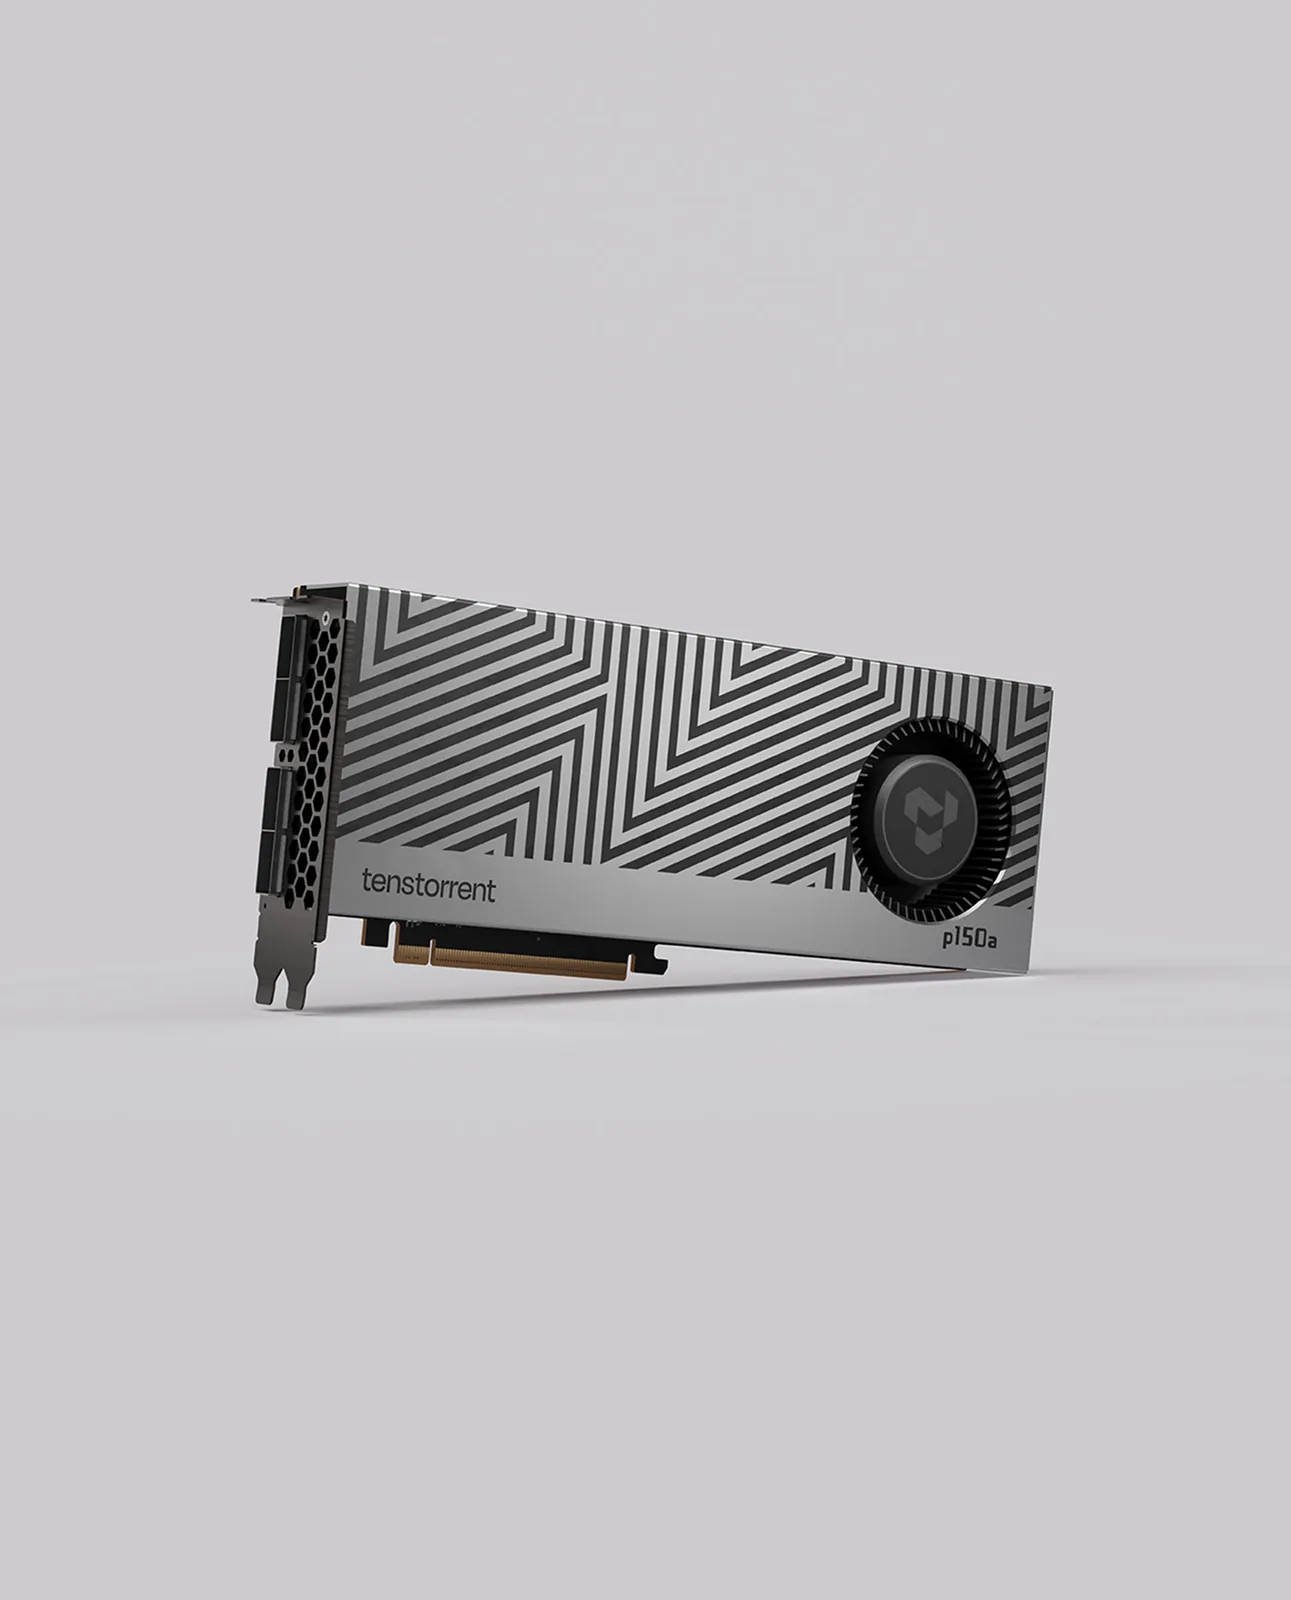
Tenstorrent
Tenstorrent Blackhole p150a
- 32 GB
- Tenstorrent Blackhole
Schafft bis zu 30–34B bei 4 Bit
Dies ist keine CUDA-Karte. Prüfen Sie vor dem Kauf, ob die benötigten Modelle in der Open-Source-Modellbibliothek von Tenstorrent unterstützt werden.
1.399 €32 GB GDDR6, 120 Tensix-Kerne und vier 800G-Ports zum Verbinden von Karten, mit Software, die Sie einsehen und ändern können.
Einstieg in Tenstorrent
Tenstorrent Wormhole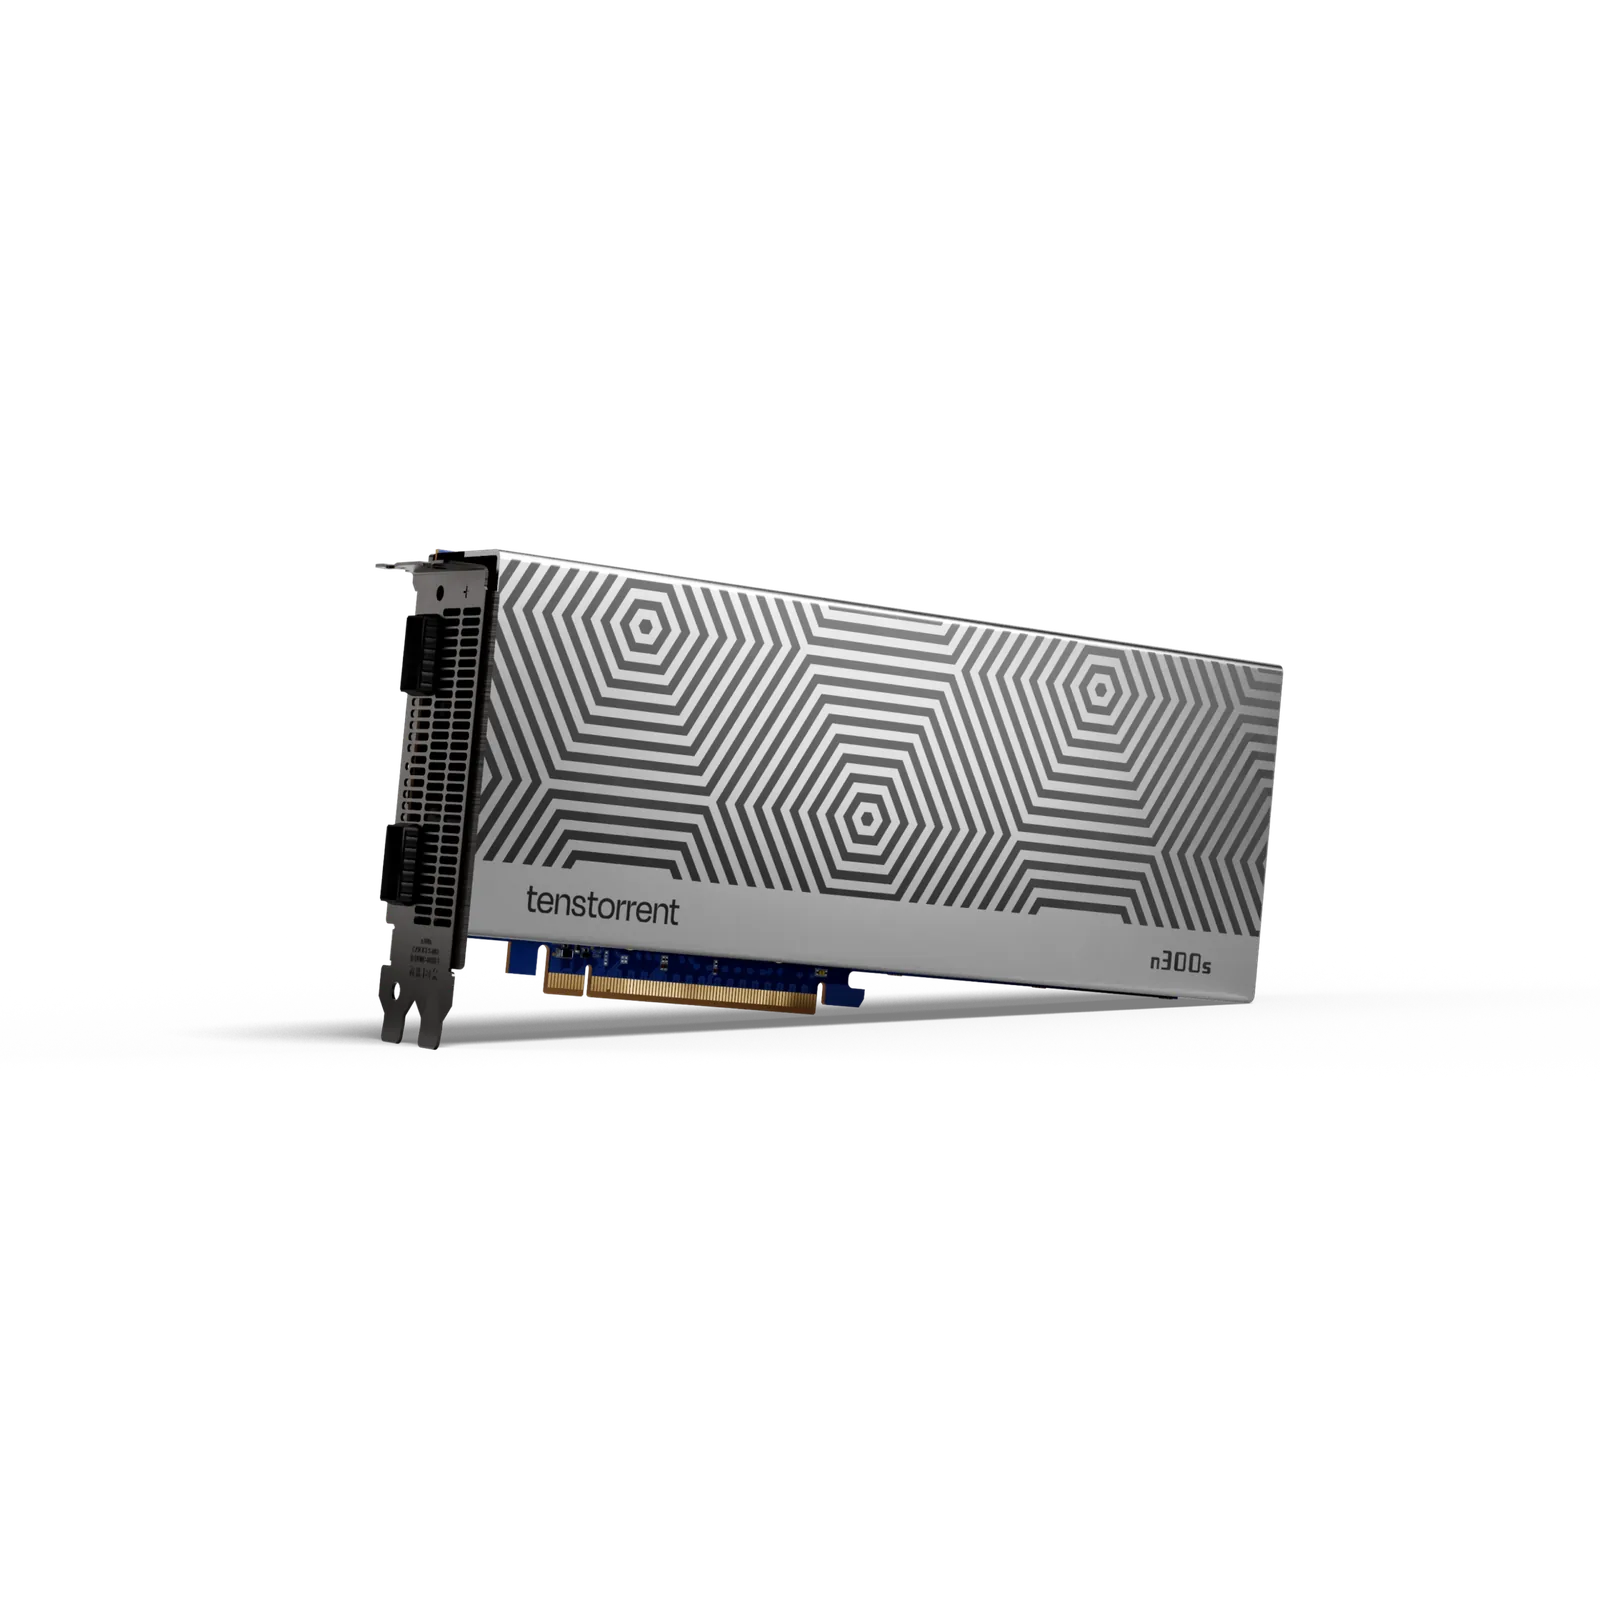
Tenstorrent
Tenstorrent Wormhole n300s
- 24 GB
Schafft bis zu 30–34B bei 4 Bit
Die 24 GB verteilen sich auf zwei Chips (je 12 GB), größere Modelle müssen also auf beide aufgeteilt werden. Prüfen Sie, ob es für Ihr gewünschtes Modell eine funktionierende Multi-Chip-Version gibt.
1.399 €Zwei Wormhole-Chips und 24 GB auf einer Karte, mit derselben Open-Source-Software wie Blackhole, zum Lernen und Entwickeln auf dem Stack.
NVIDIA
NVIDIA DGX Spark
- 128 GB Unified
- NVIDIA GB10 Grace Blackwell
Schafft bis zu 120B+ bei 4 Bit
Seine Speicherbandbreite (273 GB/s) ist geringer als die einer High-End-Grafikkarte, daher erzeugen große dichte Modelle Text langsamer als auf einer RTX 5090. Seine Stärken sind die Kapazität und der CUDA-Software-Stack.
4.699 €Tenstorrent
Tenstorrent Blackhole p150a
- 32 GB
- Tenstorrent Blackhole
Schafft bis zu 30–34B bei 4 Bit
Dies ist keine CUDA-Karte. Prüfen Sie vor dem Kauf, ob die benötigten Modelle in der Open-Source-Modellbibliothek von Tenstorrent unterstützt werden.
1.399 €Tenstorrent
Tenstorrent Wormhole n300s
- 24 GB
Schafft bis zu 30–34B bei 4 Bit
Die 24 GB verteilen sich auf zwei Chips (je 12 GB), größere Modelle müssen also auf beide aufgeteilt werden. Prüfen Sie, ob es für Ihr gewünschtes Modell eine funktionierende Multi-Chip-Version gibt.
1.399 €So wählen Sie einen KI-Beschleuniger
- CUDA oder Open Source
- Der DGX Spark wird mit dem KI-Software-Stack von NVIDIA ausgeliefert. Darauf geschriebener Code lässt sich mit wenigen Änderungen auf größere DGX-Systeme übertragen. Tenstorrent-Karten nutzen TT-Metalium und TT-Forge, quelloffen von den Low-Level-Kernels bis zum Modell-Compiler. Es sind keine CUDA-Karten.
- Zuerst die Modellunterstützung prüfen
- Prüfen Sie vor dem Kauf einer Tenstorrent-Karte, ob die benötigten Modelle in der quelloffenen Modellbibliothek von Tenstorrent enthalten sind. Bei der Wormhole n300 sind die 24 GB auf 12 GB pro Chip aufgeteilt, größere Modelle brauchen daher eine funktionierende Multi-Chip-Version.
- Der Speicher setzt die Grenze
- Nach der Regel unseres Modell-Ratgebers fasst der gemeinsame Arbeitsspeicher des Spark mit 128 GB ein 70B-Modell in 8 Bit oder ein Modell der 120B-Klasse in 4 Bit. Die Blackhole p150a hat 32 GB GDDR6 mit 512 GB/s, genug Speicher für ein Modell der 30B-Klasse in 4 Bit, sofern die Bibliothek es unterstützt.
- Kapazität ist nicht Geschwindigkeit
- Die Speicherbandbreite des Spark liegt bei 273 GB/s, die einer RTX 5090 bei 1.792 GB/s. Große dichte Modelle erzeugen Text darauf langsamer. Mixture-of-Experts-Modelle lesen pro Token nur einen Teil ihrer Gewichte und spüren den Unterschied weniger.
- Skalierung einplanen
- Zwei DGX Spark lassen sich über das integrierte ConnectX-7-Netzwerk mit 200 Gb/s verbinden. Die p150a hat vier QSFP-DD-800G-Ports, die n300 zwei QSFP-DD-Ports, um Karten zu verketten. Jede Tenstorrent-Karte nimmt 300 W auf und braucht einen PCIe-x16-Steckplatz. Planen Sie Netzteil und Kühlung des Host-Rechners entsprechend.
Häufige Fragen
Soll ich einen KI-Beschleuniger oder eine Grafikkarte kaufen?
Einen Beschleuniger kaufen Sie wegen seiner Software: den DGX Spark für CUDA-Entwicklung mit 128 GB, eine Tenstorrent-Karte für einen offenen Stack. Für die höchste Geschwindigkeit bei Modellen bis etwa 30B oder wenn Sie auch spielen, ist eine Grafikkarte wie die RTX 5090 die bessere Wahl.
Läuft mein CUDA-Code auf einer Tenstorrent-Karte?
Nein. Tenstorrent-Karten nutzen einen eigenen Open-Source-Stack, TT-Metalium und TT-Forge. Prüfen Sie vor dem Kauf, ob Ihre Modelle in Tenstorrents Modellbibliothek unterstützt werden.
Läuft auf dem DGX Spark Windows, und kann ich darauf spielen?
Nein. Er arbeitet mit einer Arm-CPU und NVIDIA DGX OS, einem Linux-System auf Basis von Ubuntu. Software, die nur für x86-Windows entwickelt wurde, läuft nicht, und zum Spielen ist er nicht gedacht.
Kann ich auf dem DGX Spark Modelle feintunen?
Ja. Fine-Tuning braucht mehr Speicher als das Ausführen eines Modells, parametereffiziente Verfahren wie LoRA senken diesen Bedarf deutlich. Die 128 GB des Spark bieten Platz für diese Arbeit bei Modellgrößen, die eine 32-GB-Karte nicht erreicht.
Verwandte Seiten: Hardware für lokale KI · Apple
Ratgeber
Lokale KI · 4 Min. Lesezeit
DGX Spark vs Mac Studio: Für wen ist der Spark gedacht?
Lohnt sich der DGX Spark? Was er gut kann, wo er langsamer ist und wie er bei lokaler KI abschneidet: DGX Spark vs Mac Studio, RTX 5090 und RTX PRO 6000.
Ratgeber lesen →Lokale KI · 5 Min. Lesezeit
Mac, NVIDIA oder Ryzen AI Max+ für lokale KI
Mac, NVIDIA oder Ryzen AI Max+: CUDA bei NVIDIA, gemeinsamer Arbeitsspeicher beim Mac oder 128 GB im Mini-PC. Speicher, Software und Kompromisse.
Ratgeber lesen →Lokale KI · 5 Min. Lesezeit
Wie viel Arbeitsspeicher braucht ein lokales LLM?
So ermitteln Sie, wie viel Arbeitsspeicher ein lokales LLM braucht: 7B- bis 120B+-Modelle mit 4 und 8 Bit, Unified Memory vs. VRAM und passende Rechner.
Ratgeber lesen →