Mac, NVIDIA oder Ryzen AI Max+ für lokale KI
Aktualisiert am 17. November 2026 · 5 Min. Lesezeit
Wählen Sie NVIDIA, wenn Ihre Tools CUDA voraussetzen oder Sie das höchste Tempo bei Modellen wollen, die in 24–32 GB passen. Wählen Sie einen Mac, wenn Sie große Modelle in einem nahezu lautlosen Gerät mit wenig Einrichtungsaufwand betreiben möchten. Wählen Sie einen Ryzen-AI-Max+-Mini-PC, wenn Sie 128 GB Speicher auf einem Rechner mit Windows oder Linux wollen. Die DGX Spark liegt dazwischen: 128 GB und CUDA, für Entwickler gedacht.
Die drei Plattformen im Überblick#
| NVIDIA-Grafikkarte | Apple Mac | Ryzen-AI-Max+-Mini-PC | |
|---|---|---|---|
| Speicher für Modelle | 32 GB (RTX 5090), 96 GB (RTX PRO 6000) | 24 GB (Mac mini in der Grundausstattung) bis 96 GB und mehr (Mac Studio) | 128 GB gemeinsam; bis zu 96 GB für die GPU unter Windows, mehr unter Linux |
| Software | CUDA, breiteste Unterstützung | Metal und MLX | ROCm und Vulkan |
| Betriebssystem | Windows oder Linux | macOS | Windows oder Linux |
| Größe und Lautstärke | Ein Desktop-Tower; allein die RTX 5090 zieht bis zu 575 W | Kompakt und nahezu lautlos | Ein kleines Desktop-Gehäuse |
| Am besten für | CUDA-Workloads, Höchsttempo bei passenden Modellen, Gaming | Große Modelle ohne viel Aufwand, kreative Arbeit | Modelle der 70B- und 120B-Klasse auf einem PC |
NVIDIA: der Standard, wenn die Software entscheidet#
Die meisten KI-Forschungsprojekte, Trainingsskripte und Serving-Tools sind zuerst auf CUDA ausgelegt. Wenn Sie Modelle feintunen, neue Paper nachvollziehen oder Tools nutzen, die CUDA voraussetzen, spart Ihnen eine NVIDIA-Karte Zeit.
Die Grenze ist der Speicher pro Karte. Die RTX 5090 hat 32 GB. Damit laufen Modelle der 30B-Klasse in 4 Bit problemlos, ein 70B-Modell auf einer Karte aber nicht. Darüber brauchen Sie zwei Karten oder die RTX PRO 6000 mit 96 GB, die ein 70B-Modell in 8 Bit allein aufnimmt.
Der Lohn ist Geschwindigkeit: Beide Karten bieten 1.792 GB/s Speicherbandbreite, Modelle, die in den Speicher passen, erzeugen Text daher schnell. Der Preis dafür sind Strombedarf und Platz. NVIDIA empfiehlt für die RTX 5090 ein 1.000-W-Netzteil; alles Weitere steht in unserem Einbau-Ratgeber.
Mac: viel Speicher, wenig Lärm#
Apple Silicon nutzt gemeinsamen Arbeitsspeicher (Unified Memory), auf den die GPU direkt zugreift. Der Mac Studio mit M3 Ultra hat serienmäßig 96 GB (256 GB optional bestellbar) und 819 GB/s Bandbreite. Damit laufen große Sprachmodelle schnell, und der Rechner bleibt nahezu lautlos.
llama.cpp, Ollama und LM Studio laufen über Metal nativ auf dem Mac, und Apples Framework MLX ist für diese Hardware gebaut. CUDA gibt es dort nicht; Tools, die es voraussetzen, laufen daher nicht. Feintuning funktioniert in MLX, der meiste Trainingscode wird aber zuerst für CUDA geschrieben.
Der Arbeitsspeicher lässt sich später nicht aufrüsten. Der Mac mini mit M4 Pro beginnt bei 24 GB; damit sind etwa 14B die sinnvolle Obergrenze. Wenn lokale KI das Ziel ist, wählen Sie beim Kauf 48 GB oder 64 GB.
Ryzen AI Max+: 128 GB im PC#
Der Ryzen AI Max+ 395 kombiniert eine 16-Kern-CPU mit der integrierten GPU Radeon 8060S und 128 GB gemeinsamem LPDDR5X-Arbeitsspeicher. Das reicht für ein 70B-Modell in 8 Bit oder ein Modell der 120B-Klasse in 4 Bit – in einem kleinen Gehäuse, auf dem Ihre gewohnte Windows- oder Linux-Software läuft.
Unter Windows lassen sich der GPU bis zu 96 GB der 128 GB zuweisen, unter Linux mehr. Planen Sie also Linux ein, wenn Sie die größten Modelle nutzen wollen. llama.cpp läuft auf diesem Chip über Vulkan oder ROCm, wobei die ROCm-Unterstützung von der installierten Version abhängt. Prüfen Sie vor dem Kauf, ob Ihre übrigen Tools den Chip unterstützen.
Die beiden Rechner in unserem Sortiment vergleichen wir in Ryzen AI Max+ 395 Mini-PCs im Vergleich.
Wo die DGX Spark hineinpasst#
Die DGX Spark hat dieselben 128 GB wie ein Ryzen-AI-Max+-Rechner, dazu CUDA und den Software-Stack von NVIDIA. Ihre Speicherbandbreite liegt bei 273 GB/s. Sie ist also in erster Linie ein Entwicklungsrechner und erst in zweiter ein schneller Chat-Rechner. Mehr dazu in unserem DGX-Spark-Ratgeber.
Welche Plattform passt#
- Ihre Tools brauchen CUDA, oder Sie spielen auch: eine NVIDIA-Grafikkarte.
- Sie wollen das größte Modell im leisesten Gehäuse und arbeiten gern mit macOS: ein Mac Studio.
- Sie wollen 128 GB unter Windows oder Linux in einem kleinen Gehäuse: ein Mini-PC mit Ryzen AI Max+.
- Sie entwickeln mit CUDA und setzen Ihre Projekte auf größeren NVIDIA-Systemen ein: die DGX Spark.
- Ihre Modelle haben 14B oder weniger: Dann ist jede dieser Optionen mehr als nötig. Ein Mac mini mit 24 GB oder eine Karte mit 16 GB reicht.

NVIDIA
NVIDIA GeForce RTX 5090
- 32 GB
- NVIDIA Blackwell (GB202)
Schafft bis zu 30–34B bei 4 Bit
Mit 32 GB laufen Modelle der 30B-Klasse in 4 Bit problemlos, ein 70B-Modell passt aber nicht auf eine Karte. Für 70B sollten Sie zwei Karten oder ein System mit großem gemeinsamem Arbeitsspeicher einplanen.
1.999 €
Apple
Apple Mac Studio (M3 Ultra)
- 96 GB Unified
- 60 Kerne; optional 80 Kerne
Schafft bis zu 70B bei 4 Bit
macOS reserviert einen Teil des gemeinsamen Arbeitsspeichers für das System, die GPU kann also den Großteil nutzen, aber nicht alles. Wählen Sie die Konfiguration mit etwas Reserve über der Modellgröße.
3.999 €
Beelink
Beelink GTR9 Pro
- 128 GB Unified
- AMD Ryzen AI Max+ 395
Schafft bis zu 120B+ bei 4 Bit
Unter Windows lassen sich der GPU bis zu 96 GB der 128 GB zuweisen. Prüfen Sie vor dem Kauf, ob das Modell, das Sie nutzen möchten, in diesen Speicher passt.
4.349 €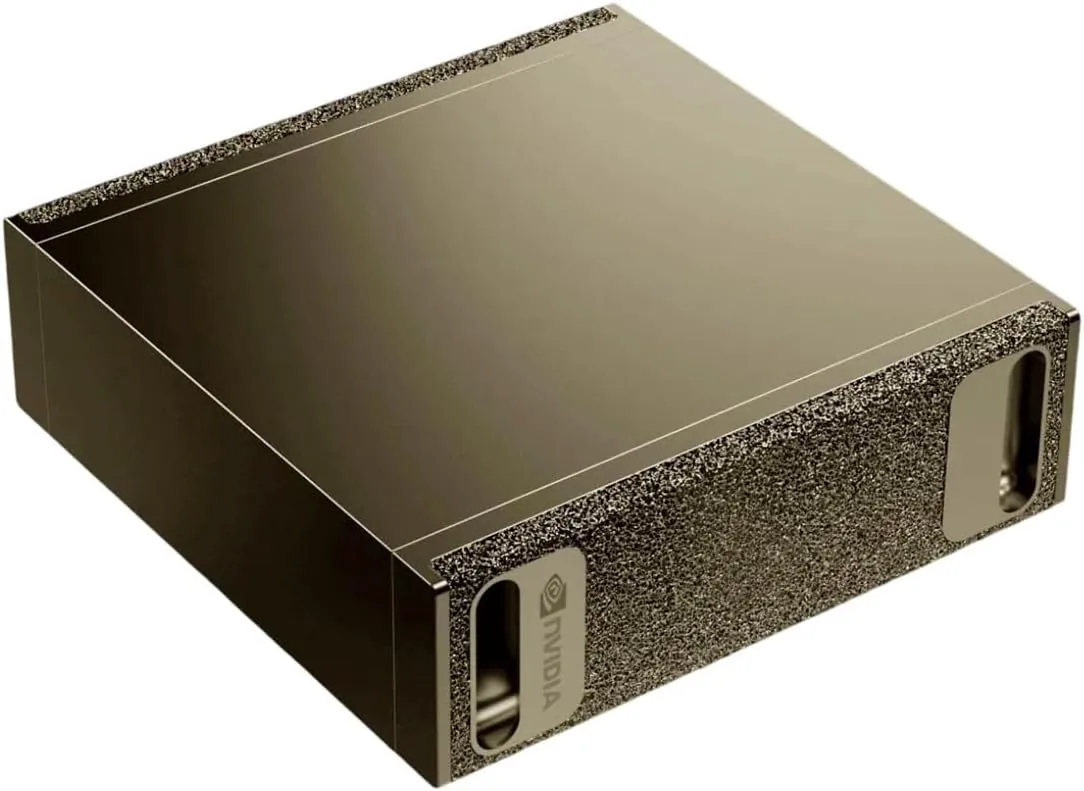
NVIDIA
NVIDIA DGX Spark
- 128 GB Unified
- NVIDIA GB10 Grace Blackwell
Schafft bis zu 120B+ bei 4 Bit
Seine Speicherbandbreite (273 GB/s) ist geringer als die einer High-End-Grafikkarte, daher erzeugen große dichte Modelle Text langsamer als auf einer RTX 5090. Seine Stärken sind die Kapazität und der CUDA-Software-Stack.
4.699 €Häufige Fragen
Kann ein Mac CUDA-Software ausführen?
Nein. CUDA läuft nur auf NVIDIA-Hardware. Die meisten verbreiteten Tools für lokale KI, darunter llama.cpp, Ollama und LM Studio, laufen nativ auf dem Mac; Tools, die CUDA voraussetzen, dagegen nicht.
Ist AMD für lokale KI schwieriger einzurichten?
Es erfordert mehr Prüfaufwand. PyTorch und llama.cpp unterstützen ROCm, llama.cpp läuft zudem über Vulkan, doch manche Nischen-Tools setzen weiterhin CUDA voraus. Prüfen Sie vor dem Kauf Ihre Tools und Ihr Betriebssystem.
Welche Plattform ist am leisesten?
Macs arbeiten nahezu lautlos und brauchen wenig Strom. Ryzen-AI-Max+-Rechner sind kleine Desktop-Gehäuse. Ein Tower mit High-End-Grafikkarte ist von den dreien der lauteste und stromhungrigste.
Welcher Rechner fasst das größte Modell?
Unter den Einzelgeräten in unserem Sortiment fassen die Ryzen-AI-Max+-Mini-PCs mit 128 GB, die DGX Spark und die RTX PRO 6000 mit 96 GB jeweils Modelle der 120B-Klasse in 4 Bit. Gleiches gilt für Mac-Studio-Konfigurationen mit mehr als 96 GB.
Passende Produkte: Apple · Mini-PCs · Hardware für lokale KI
Passende Ratgeber
Lokale KI · 5 Min. Lesezeit
Wie viel Arbeitsspeicher braucht ein lokales LLM?
So ermitteln Sie, wie viel Arbeitsspeicher ein lokales LLM braucht: 7B- bis 120B+-Modelle mit 4 und 8 Bit, Unified Memory vs. VRAM und passende Rechner.
Ratgeber lesen →Mini-PCs · 4 Min. Lesezeit
Ryzen AI Max+ 395 Mini-PCs im Vergleich
Ryzen AI Max+ 395 Mini-PCs im Vergleich: Beelink GTR9 Pro oder Minisforum MS-S1 Max, 128 GB Unified Memory, Anschlüsse, Erweiterung und passende Modelle.
Ratgeber lesen →Lokale KI · 4 Min. Lesezeit
DGX Spark vs Mac Studio: Für wen ist der Spark gedacht?
Lohnt sich der DGX Spark? Was er gut kann, wo er langsamer ist und wie er bei lokaler KI abschneidet: DGX Spark vs Mac Studio, RTX 5090 und RTX PRO 6000.
Ratgeber lesen →