Mac, NVIDIA ou Ryzen AI Max+ pour l'IA locale
Mis à jour le 17 novembre 2026 · 5 min de lecture
Choisissez NVIDIA si vos outils exigent CUDA ou si vous voulez la vitesse maximale sur des modèles qui tiennent dans 24–32 GB. Choisissez un Mac pour faire tourner de grands modèles dans une machine quasi silencieuse, avec peu de configuration. Choisissez un mini PC Ryzen AI Max+ pour disposer de 128 GB de mémoire sur une machine sous Windows ou Linux. La DGX Spark se situe entre les deux : 128 GB et CUDA, conçue pour les développeurs.
Les trois plateformes en un coup d'œil#
| Carte graphique NVIDIA | Mac Apple | Mini PC Ryzen AI Max+ | |
|---|---|---|---|
| Mémoire pour les modèles | 32 GB (RTX 5090), 96 GB (RTX PRO 6000) | De 24 GB (Mac mini de base) à 96 GB et plus (Mac Studio) | 128 GB partagés ; jusqu'à 96 GB pour le GPU sous Windows, davantage sous Linux |
| Logiciels | CUDA, la compatibilité la plus large | Metal et MLX | ROCm et Vulkan |
| Système d'exploitation | Windows ou Linux | macOS | Windows ou Linux |
| Encombrement et bruit | Une tour de bureau ; la RTX 5090 consomme à elle seule jusqu'à 575 W | Compact et quasi silencieux | Un petit boîtier de bureau |
| Idéal pour | Travail sous CUDA, vitesse maximale sur les modèles qui tiennent en mémoire, jeu | Grands modèles sans complication, travaux créatifs | Modèles 70B et de classe 120B sur un PC |
NVIDIA : le choix par défaut quand le logiciel décide#
CUDA est la première cible de la plupart des codes de recherche en IA, des scripts d'entraînement et des outils d'inférence. Si vous faites du fine-tuning, suivez les nouvelles publications ou utilisez des outils qui exigent CUDA, une carte NVIDIA vous fera gagner du temps.
La limite, c'est la mémoire par carte. La RTX 5090 dispose de 32 GB : elle fait tourner sans difficulté des modèles de la classe 30B en 4 bits, mais pas un modèle 70B sur une seule carte. Au-delà, il faut deux cartes ou la RTX PRO 6000 et ses 96 GB, qui suffit à elle seule pour un modèle 70B en 8 bits.
L'avantage, c'est la vitesse : les deux cartes offrent 1 792 GB/s de bande passante mémoire, si bien que les modèles qui tiennent en mémoire génèrent du texte rapidement. Le prix à payer, c'est la consommation et l'encombrement. NVIDIA recommande une alimentation de 1 000 W pour la RTX 5090 ; notre guide de montage détaille le reste.
Mac : beaucoup de mémoire, peu de bruit#
Les puces Apple utilisent une mémoire unifiée à laquelle le GPU accède directement. Le Mac Studio avec M3 Ultra est livré avec 96 GB de série, 256 GB en option sur commande, et offre 819 GB/s de bande passante. Cette combinaison fait tourner rapidement les grands modèles de langage tout en restant quasi silencieuse.
llama.cpp, Ollama et LM Studio fonctionnent nativement sur Mac via Metal, et le framework MLX d'Apple est conçu pour ce matériel. CUDA n'est pas disponible : les outils qui l'exigent ne fonctionneront pas. Le fine-tuning est possible avec MLX, mais la plupart du code d'entraînement est d'abord écrit pour CUDA.
La mémoire ne peut pas être augmentée par la suite. Le Mac mini avec M4 Pro démarre à 24 GB, ce qui place la limite confortable vers 14B. Si l'IA locale est votre objectif, choisissez 48 GB ou 64 GB dès l'achat.
Ryzen AI Max+ : 128 GB sur un PC#
Le Ryzen AI Max+ 395 associe un processeur 16 cœurs, le GPU intégré Radeon 8060S et 128 GB de mémoire unifiée LPDDR5X. De quoi faire tourner un modèle 70B en 8 bits ou un modèle de la classe 120B en 4 bits, dans un petit boîtier qui exécute vos logiciels Windows ou Linux habituels.
Sous Windows, le GPU peut se voir attribuer jusqu'à 96 GB sur les 128 GB ; Linux permet d'en allouer davantage, prévoyez donc Linux si vous visez les plus grands modèles. llama.cpp fonctionne sur cette puce via Vulkan ou ROCm, et la prise en charge par ROCm dépend de la version installée. Vérifiez que vos autres outils prennent en charge cette puce avant de vous engager.
Nous comparons les deux machines de notre catalogue dans Comparatif des mini PC Ryzen AI Max+ 395.
La place du DGX Spark#
Le DGX Spark dispose des mêmes 128 GB qu'une machine Ryzen AI Max+, avec CUDA et l'environnement logiciel de NVIDIA. Sa bande passante mémoire est de 273 GB/s : c'est d'abord une machine de développement, et seulement ensuite une machine de chat rapide. Consultez notre guide du DGX Spark.
Que choisir#
- Vos outils exigent CUDA, ou vous jouez aussi : une carte graphique NVIDIA.
- Vous voulez le plus grand modèle dans la machine la plus silencieuse et macOS vous convient : un Mac Studio.
- Vous voulez 128 GB sous Windows ou Linux dans un petit boîtier : un mini PC Ryzen AI Max+.
- Vous développez avec CUDA et déployez sur des systèmes NVIDIA plus puissants : le DGX Spark.
- Vos modèles font 14B ou moins : n'importe laquelle de ces machines dépasse vos besoins. Un Mac mini avec 24 GB ou une carte de 16 GB fait l'affaire.

NVIDIA
NVIDIA GeForce RTX 5090
- 32 GB
- NVIDIA Blackwell (GB202)
Fait tourner jusqu'à 30–34B en 4 bits
Avec 32 GB, les modèles de classe 30B tournent confortablement en 4 bits, mais un modèle 70B ne tient pas sur une seule carte. Pour du 70B, prévoyez deux cartes ou un système à grande mémoire unifiée.
1 999 €
Apple
Apple Mac Studio (M3 Ultra)
- 96 GB unifiés
- 60 cœurs ; option 80 cœurs
Fait tourner jusqu'à 70B en 4 bits
macOS réserve une partie de la mémoire unifiée au système : le GPU peut en utiliser la majeure partie, pas la totalité. Choisissez une configuration avec de la marge au-delà de la taille du modèle.
3 999 €
Beelink
Beelink GTR9 Pro
- 128 GB unifiés
- AMD Ryzen AI Max+ 395
Fait tourner jusqu'à 120B+ en 4 bits
Sous Windows, le GPU peut se voir attribuer jusqu'à 96 GB sur les 128 GB. Vérifiez avant l'achat que le modèle que vous comptez utiliser tient dans cette enveloppe.
4 349 €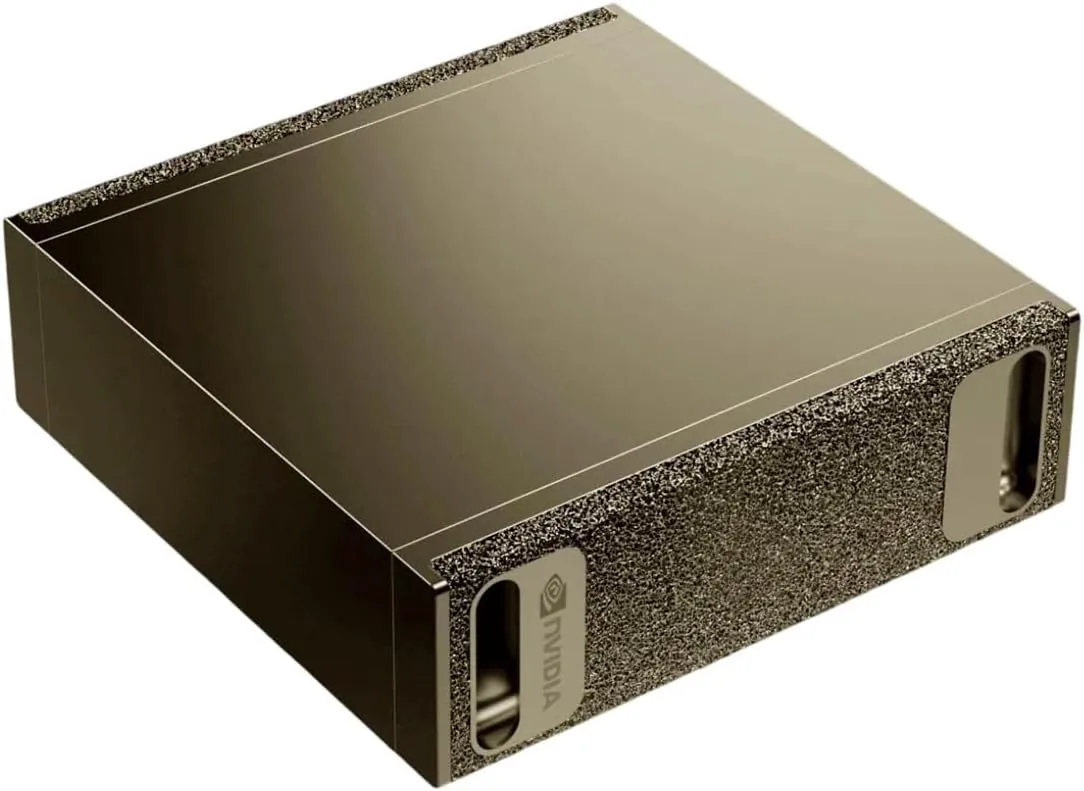
NVIDIA
NVIDIA DGX Spark
- 128 GB unifiés
- NVIDIA GB10 Grace Blackwell
Fait tourner jusqu'à 120B+ en 4 bits
Sa bande passante mémoire (273 GB/s) est inférieure à celle d'une carte graphique haut de gamme : les gros modèles denses génèrent donc du texte plus lentement que sur une RTX 5090. Ses points forts sont la capacité et la pile logicielle CUDA.
4 699 €Questions fréquentes
Un Mac peut-il exécuter des logiciels CUDA ?
Non. CUDA ne fonctionne que sur du matériel NVIDIA. La plupart des outils d'IA locale courants, dont llama.cpp, Ollama et LM Studio, fonctionnent nativement sur Mac, mais pas ceux qui exigent CUDA.
AMD est-il plus difficile à configurer pour l'IA locale ?
Cela demande plus de vérifications. PyTorch et llama.cpp prennent en charge ROCm, et llama.cpp fonctionne aussi via Vulkan, mais certains outils de niche partent encore du principe que CUDA est présent. Vérifiez vos outils et votre système d'exploitation avant d'acheter.
Quelle plateforme est la plus silencieuse ?
Les Mac sont quasi silencieux et consomment peu. Les machines Ryzen AI Max+ sont de petits boîtiers de bureau. Une tour équipée d'une carte graphique haut de gamme est la plus bruyante et la plus gourmande des trois.
Laquelle accueille le plus grand modèle ?
Parmi les machines que nous vendons, sans en combiner plusieurs, les mini PC Ryzen AI Max+ à 128 GB, le DGX Spark et la carte RTX PRO 6000 à 96 GB accueillent tous des modèles de la classe 120B en 4 bits. C'est aussi le cas des configurations de Mac Studio au-delà de 96 GB.
Voir les produits: Apple · Mini PC · Matériel pour l'IA locale
Guides associés
IA locale · 5 min de lecture
Combien de mémoire faut-il pour faire tourner un LLM en local ?
LLM en local : combien de mémoire pour les modèles de 7B à 120B+ en 4 bits et en 8 bits, mémoire unifiée ou VRAM, et quelles machines pour chaque taille.
Lire le guide →Mini PC · 4 min de lecture
Comparatif des mini PC Ryzen AI Max+ 395
Mini PC Ryzen AI Max+ 395 comparés : Beelink GTR9 Pro ou Minisforum MS-S1 Max, 128 GB de mémoire unifiée, connectique, extensibilité et modèles exécutés.
Lire le guide →IA locale · 4 min de lecture
DGX Spark vs Mac Studio : à qui s'adresse le Spark
DGX Spark vs Mac Studio : ce que le Spark fait bien, où il est plus lent, et comment il se situe face à une RTX 5090 et une RTX PRO 6000 pour l'IA locale.
Lire le guide →