Acheter par usage
Station de travail IA : quelle machine pour quel modèle
Une station de travail IA pour exécuter des modèles de langage et d'image sur votre propre matériel : en toute confidentialité, hors ligne et sans abonnement mensuel.
Conseil d'achat : C'est la mémoire qui détermine les modèles utilisables. La vitesse vient ensuite. Vérifiez d'abord la taille du modèle, puis choisissez la machine.
La mémoire détermine les modèles que vous pouvez exécuter ; la vitesse vient ensuite. Il faut environ 6 GB pour un modèle 7–8B en 4 bits, environ 42 GB pour un modèle 70B et environ 80 GB pour un modèle de classe 120B. Partez donc du plus grand modèle visé et choisissez une machine dotée d'assez de mémoire utilisable. Choisissez ensuite la plateforme logicielle : CUDA chez NVIDIA, Metal et MLX sur Mac, ou ROCm et Vulkan chez AMD.
Notre sélection
Des modèles 70B et de classe 120B dans un petit boîtier
Ryzen AI Max+ 395
Beelink
Beelink GTR9 Pro
- 128 GB unifiés
- AMD Ryzen AI Max+ 395
Fait tourner jusqu'à 120B+ en 4 bits
Sous Windows, le GPU peut se voir attribuer jusqu'à 96 GB sur les 128 GB. Vérifiez avant l'achat que le modèle que vous comptez utiliser tient dans cette enveloppe.
4 349 €128 GB de mémoire unifiée, dont environ 96 GB pour les modèles, sous Windows ou Linux ; privilégiez Linux pour allouer le maximum de mémoire au GPU.
Vitesse maximale sur les modèles jusqu'à 30B
GeForce RTX 5090
NVIDIA
NVIDIA GeForce RTX 5090
- 32 GB
- NVIDIA Blackwell (GB202)
Fait tourner jusqu'à 30–34B en 4 bits
Avec 32 GB, les modèles de classe 30B tournent confortablement en 4 bits, mais un modèle 70B ne tient pas sur une seule carte. Pour du 70B, prévoyez deux cartes ou un système à grande mémoire unifiée.
1 999 €32 GB de GDDR7 à 1 792 GB/s, avec CUDA. Une seule carte ne peut pas accueillir un modèle 70B.
Grands modèles, quasi silencieux
Mac Studio M3 Ultra
Apple
Apple Mac Studio (M3 Ultra)
- 96 GB unifiés
- 60 cœurs ; option 80 cœurs
Fait tourner jusqu'à 70B en 4 bits
macOS réserve une partie de la mémoire unifiée au système : le GPU peut en utiliser la majeure partie, pas la totalité. Choisissez une configuration avec de la marge au-delà de la taille du modèle.
3 999 €96 GB de série et 819 GB/s : un modèle 70B en 4 bits tourne rapidement, et la machine reste quasiment silencieuse.
NVIDIA
NVIDIA GeForce RTX 5090
- 32 GB
- NVIDIA Blackwell (GB202)
Fait tourner jusqu'à 30–34B en 4 bits
Avec 32 GB, les modèles de classe 30B tournent confortablement en 4 bits, mais un modèle 70B ne tient pas sur une seule carte. Pour du 70B, prévoyez deux cartes ou un système à grande mémoire unifiée.
1 999 €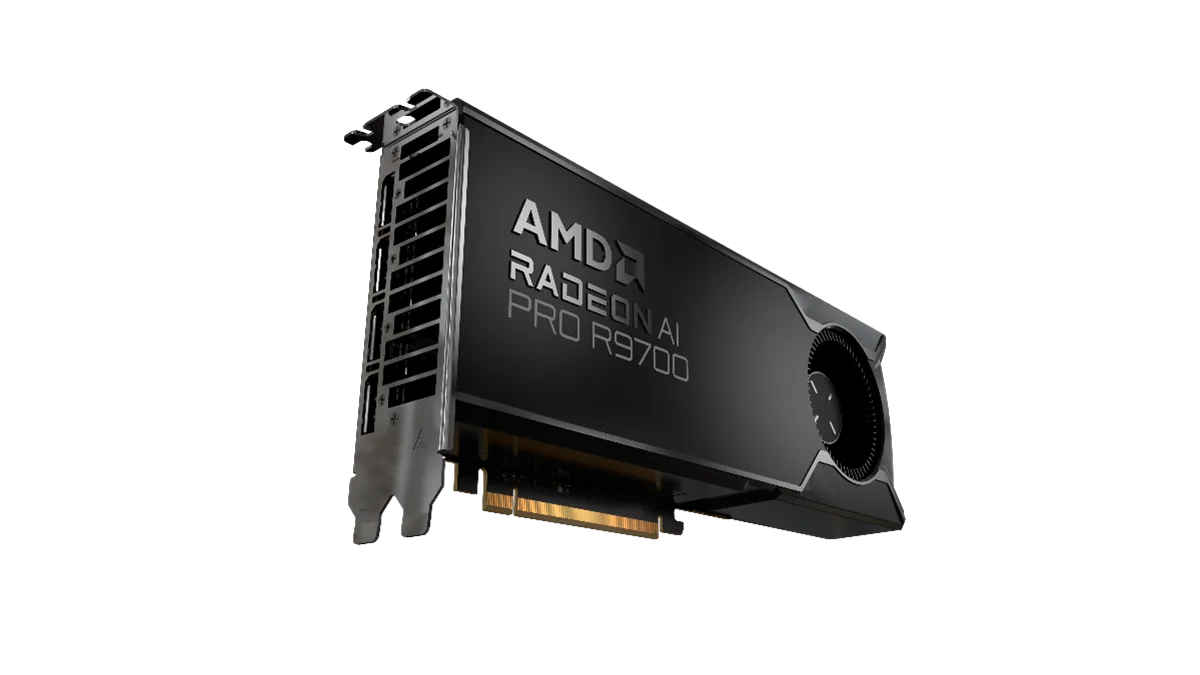
PowerColor
PowerColor AMD Radeon AI PRO R9700 32GB
- 32 GB
- AMD RDNA 4 (Navi 48)
Fait tourner jusqu'à 30–34B en 4 bits
Avant l'achat, vérifiez que vos outils prennent en charge ROCm sur votre système d'exploitation. C'est le cas de PyTorch et llama.cpp ; certains outils plus confidentiels exigent encore CUDA.
1 299 €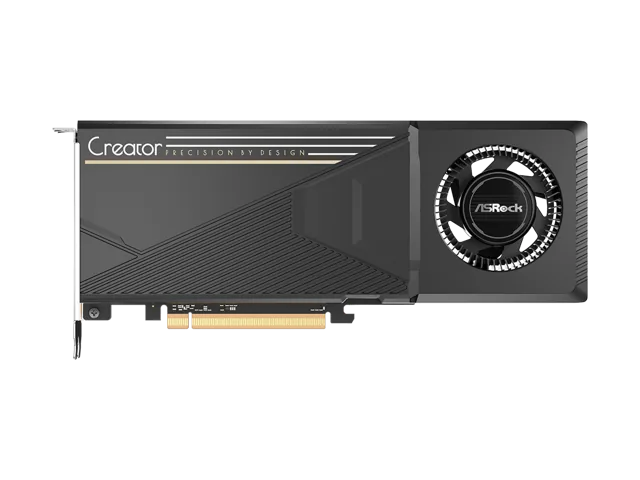
ASRock
ASRock Intel Arc Pro B60 Creator 24GB
- 24 GB
- Intel Xe2 (Battlemage)
Fait tourner jusqu'à 30–34B en 4 bits
Il s'agit d'une carte mono-GPU avec 24 GB. Elle utilise un slot PCIe 5.0 câblé en x8 et fonctionne aussi dans les slots PCIe 4.0. Vérifiez la longueur exacte et le connecteur d'alimentation dans la fiche technique d'ASRock avant de commander.
599,99 €Beelink
Beelink GTR9 Pro
- 128 GB unifiés
- AMD Ryzen AI Max+ 395
Fait tourner jusqu'à 120B+ en 4 bits
Sous Windows, le GPU peut se voir attribuer jusqu'à 96 GB sur les 128 GB. Vérifiez avant l'achat que le modèle que vous comptez utiliser tient dans cette enveloppe.
4 349 €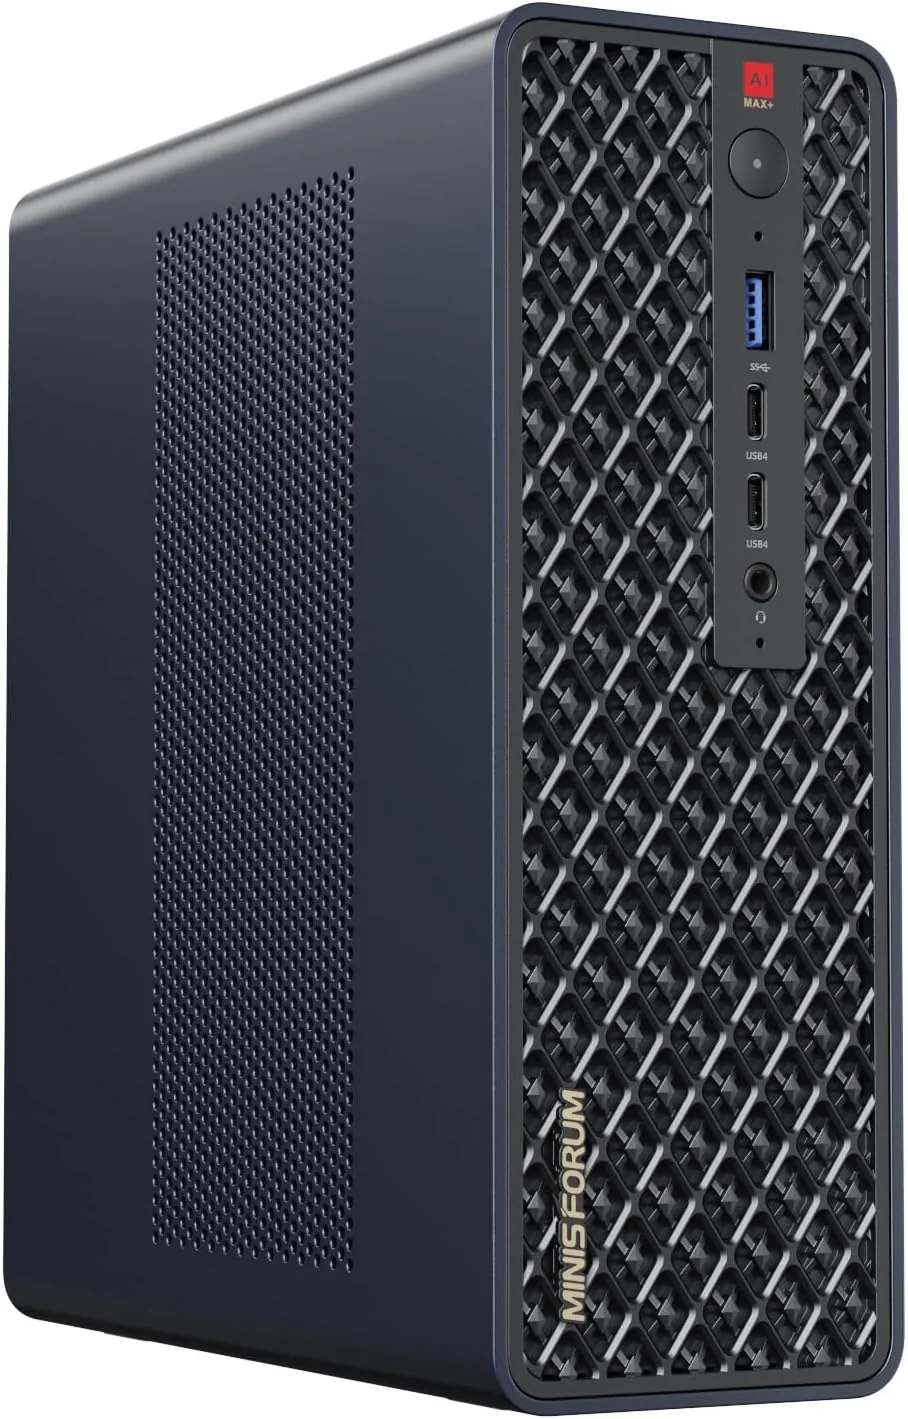
Minisforum
Minisforum MS-S1 Max
- 128 GB unifiés
- AMD Ryzen AI Max+ 395
Fait tourner jusqu'à 120B+ en 4 bits
Le slot PCIe accepte les cartes low profile et fonctionne en x4. Il est idéal pour une carte réseau plus rapide, pas pour ajouter une carte graphique pleine taille.
2 469 €
NVIDIA
NVIDIA DGX Spark
- 128 GB unifiés
- NVIDIA GB10 Grace Blackwell
Fait tourner jusqu'à 120B+ en 4 bits
Sa bande passante mémoire (273 GB/s) est inférieure à celle d'une carte graphique haut de gamme : les gros modèles denses génèrent donc du texte plus lentement que sur une RTX 5090. Ses points forts sont la capacité et la pile logicielle CUDA.
4 699 €Apple
Apple Mac Studio (M3 Ultra)
- 96 GB unifiés
- 60 cœurs ; option 80 cœurs
Fait tourner jusqu'à 70B en 4 bits
macOS réserve une partie de la mémoire unifiée au système : le GPU peut en utiliser la majeure partie, pas la totalité. Choisissez une configuration avec de la marge au-delà de la taille du modèle.
3 999 €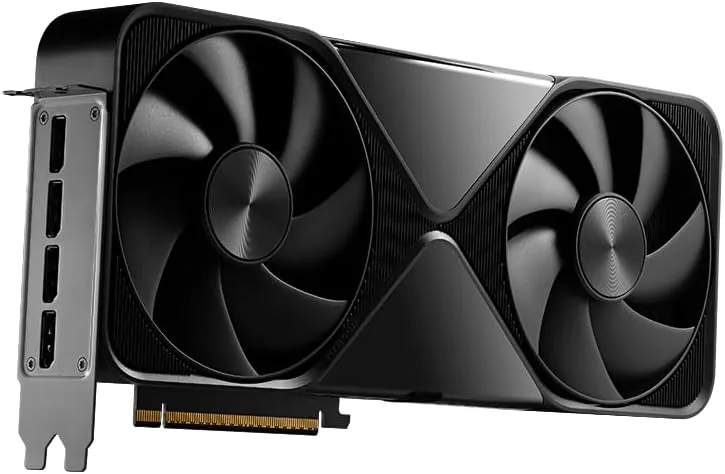
NVIDIA
NVIDIA RTX PRO 6000 Blackwell Workstation Edition (96 GB)
- 96 GB
- NVIDIA Blackwell (GB202)
Fait tourner jusqu'à 120B+ en 4 bits
Il s'agit de la Workstation Edition de 600 W, équipée d'un refroidissement double flow-through. Elle nécessite un câble d'alimentation 16 broches, un boîtier capable d'accueillir une carte de 12 pouces et une bonne circulation d'air.
13 250 €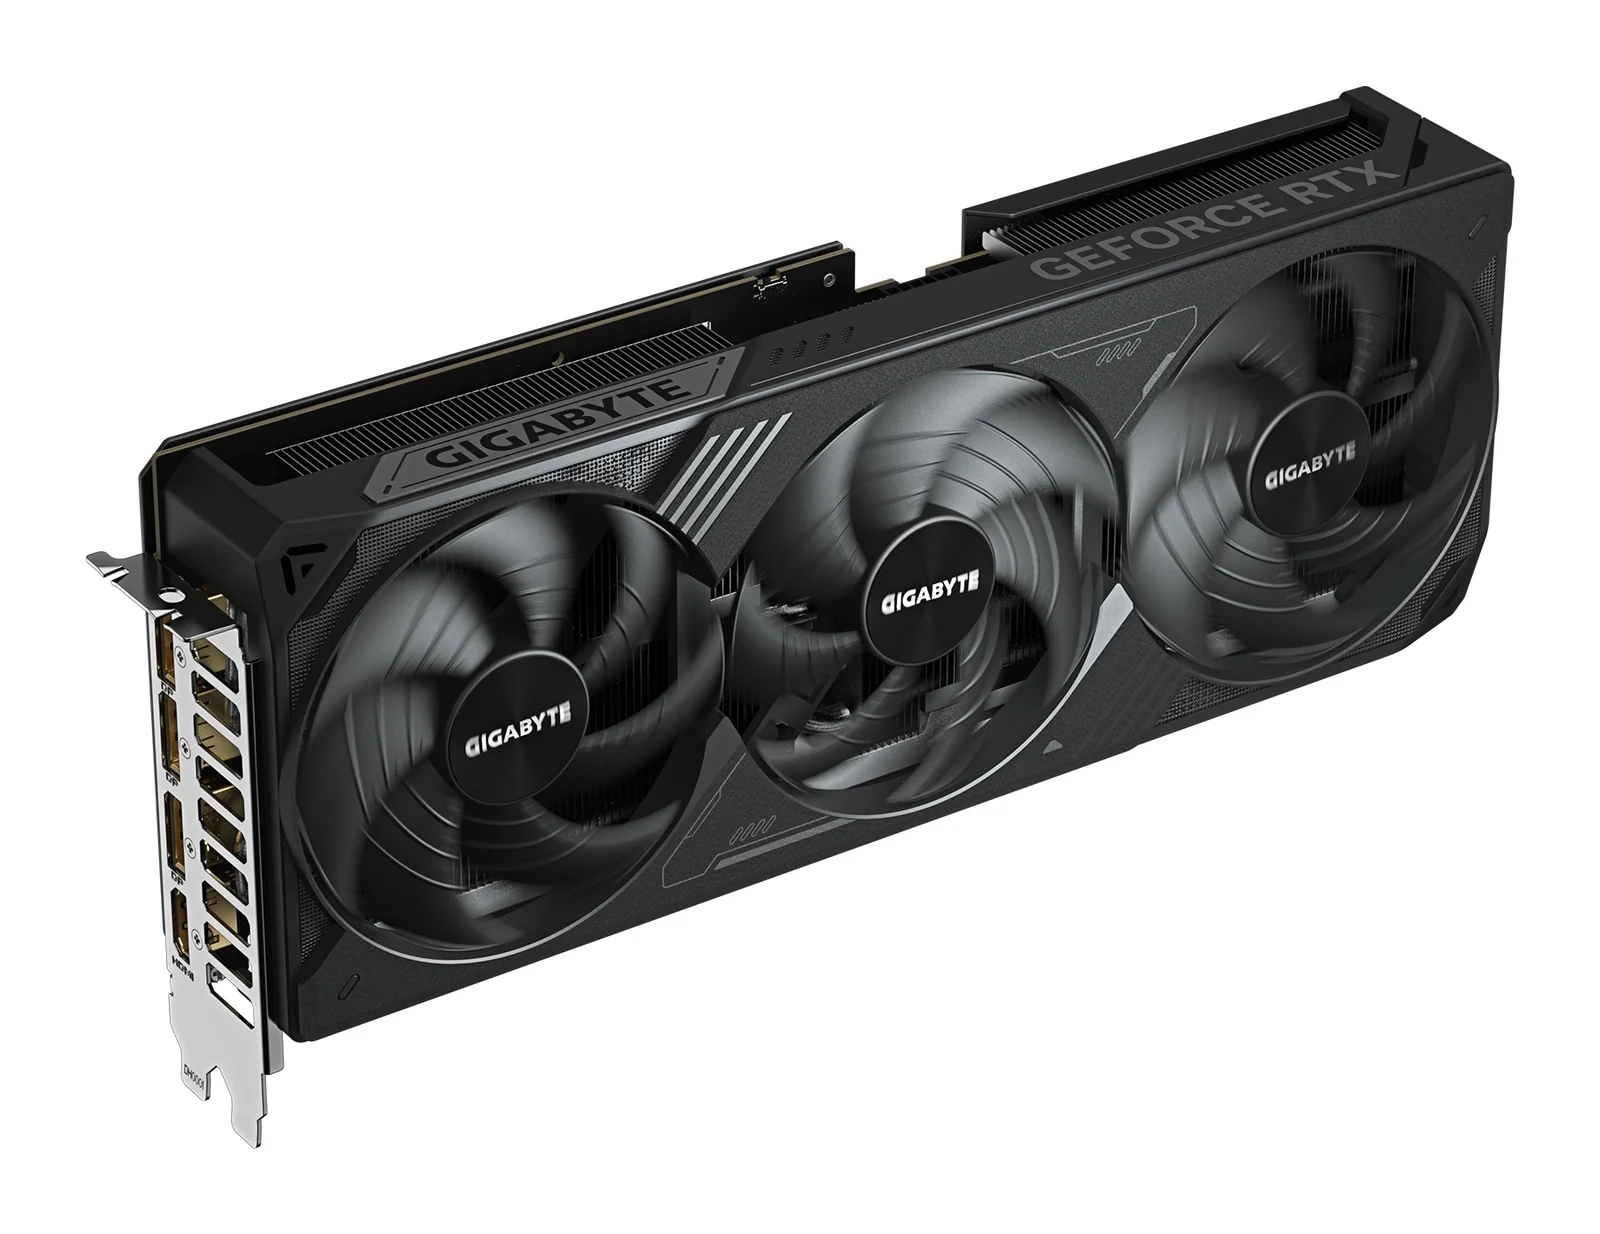
GIGABYTE
GIGABYTE GeForce RTX 5070 Ti WINDFORCE OC SFF 16G
- 16 GB
- NVIDIA GeForce RTX 5070 Ti (Blackwell)
Fait tourner jusqu'à 13–14B en 4 bits
Elle nécessite un câble d'alimentation 16 broches, ou l'adaptateur fourni, qui utilise deux câbles PCIe 8 broches. GIGABYTE recommande une alimentation de 750 W.
849 €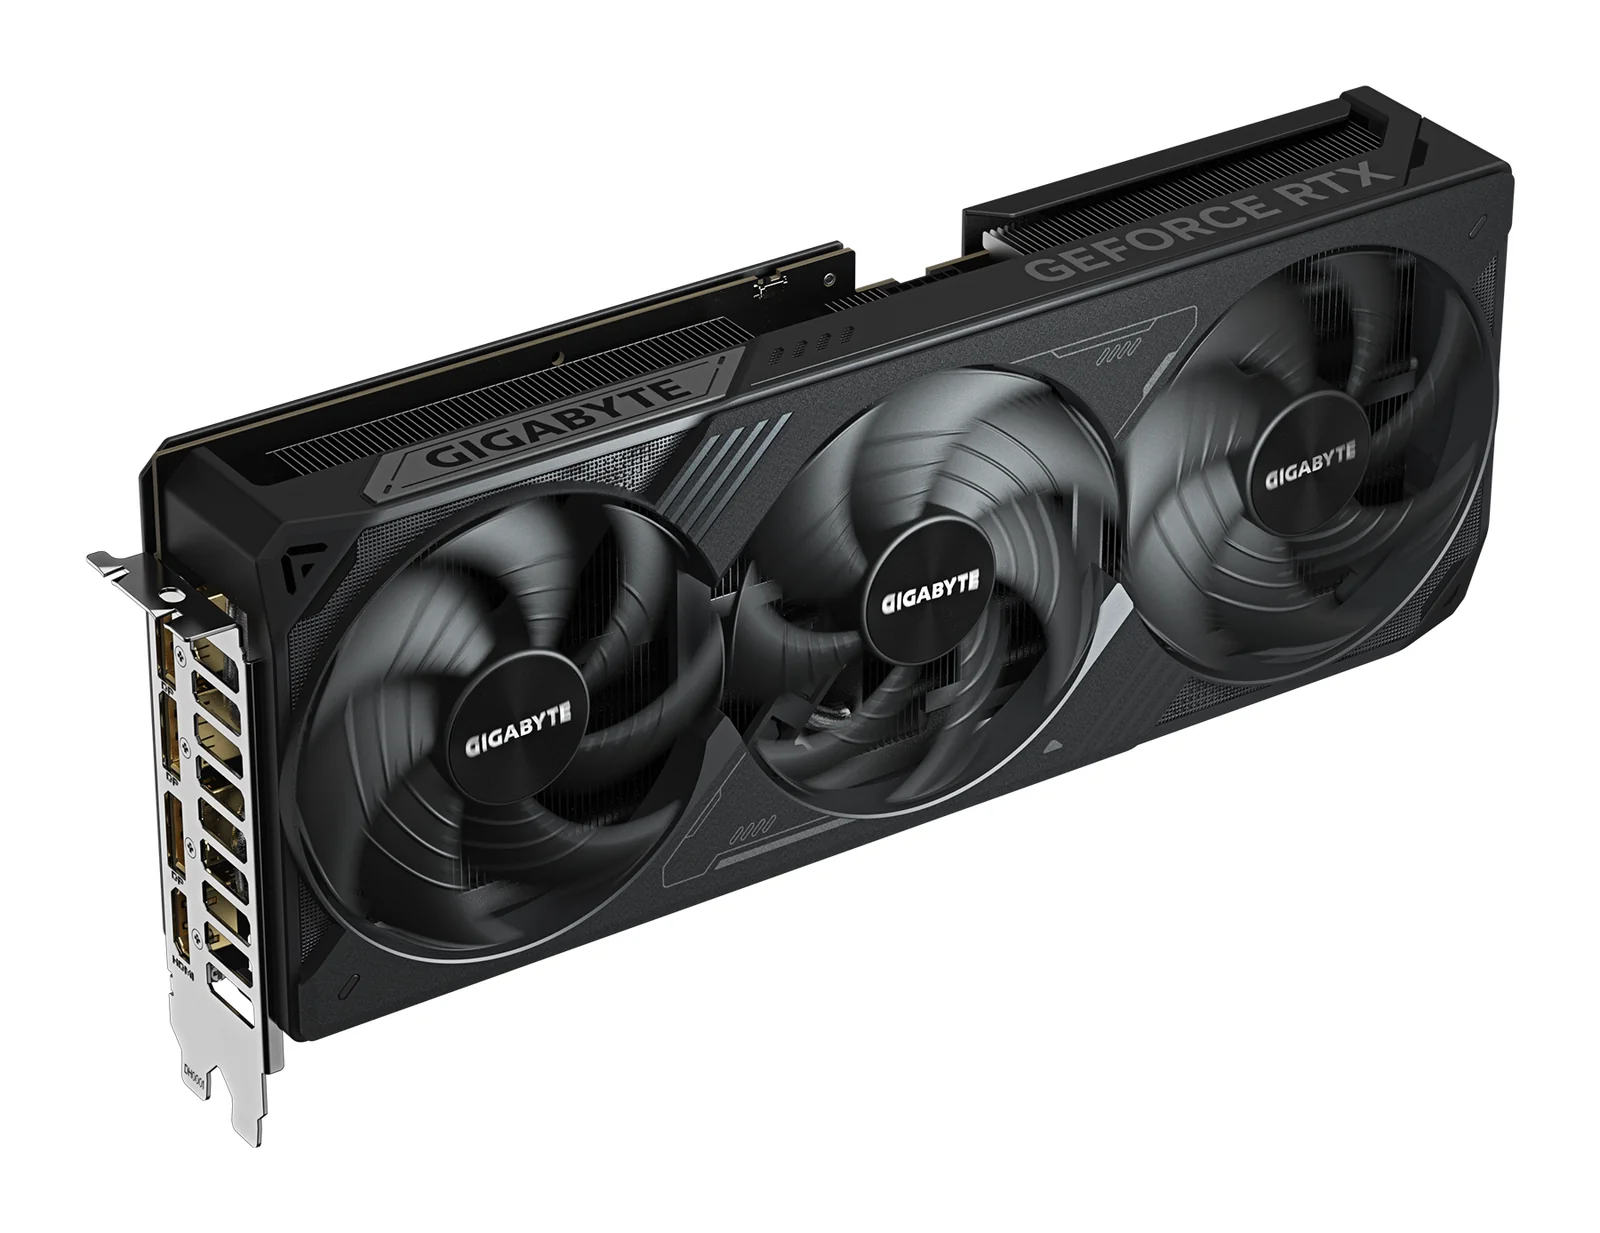
GIGABYTE
GIGABYTE GeForce RTX 5080 WINDFORCE OC SFF 16G
- 16 GB
- NVIDIA GeForce RTX 5080 (Blackwell)
Fait tourner jusqu'à 13–14B en 4 bits
Elle a les mêmes 16 GB que la RTX 5070 Ti : elle ne charge donc pas de plus gros modèles d'IA, elle les fait tourner plus vite. Pour davantage de mémoire sur une seule carte, regardez la RTX 5090 ou une carte de 24 à 32 GB.
1 079 €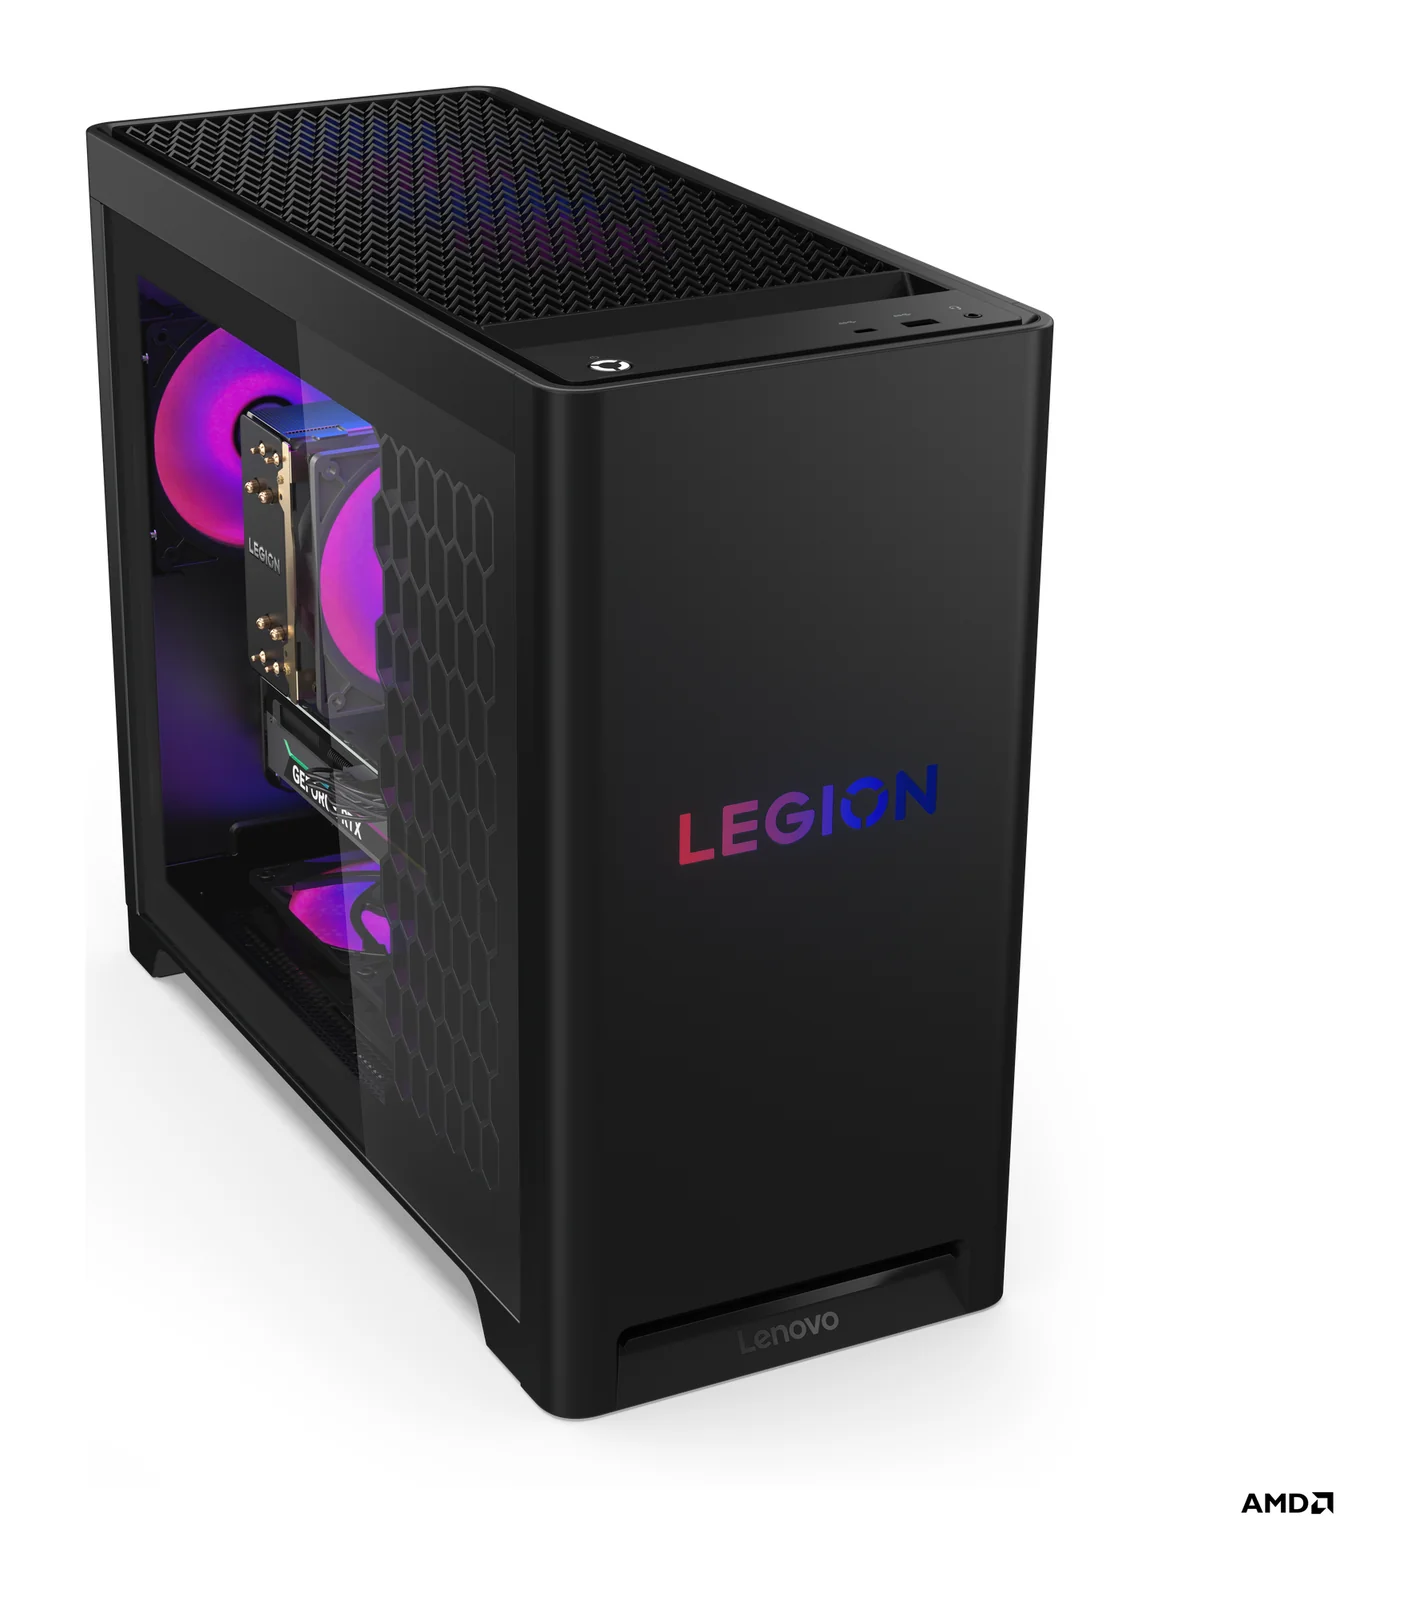
Lenovo
Lenovo Legion Tower 5 Gen 10 (RTX 5070 Ti)
- 32 GB
- AMD Ryzen 7 7800X3D (8 cœurs / 16 threads, 4,2 / 5,0 GHz, 96 MB de L3)
La mémoire système se compose de deux barrettes de 16 GB, et Lenovo indique 32 GB comme maximum pour cette tour : comptez donc sur 32 GB pendant toute sa durée de vie. Le stockage, lui, peut évoluer : trois emplacements M.2 et une baie 3,5 pouces.
2 159 €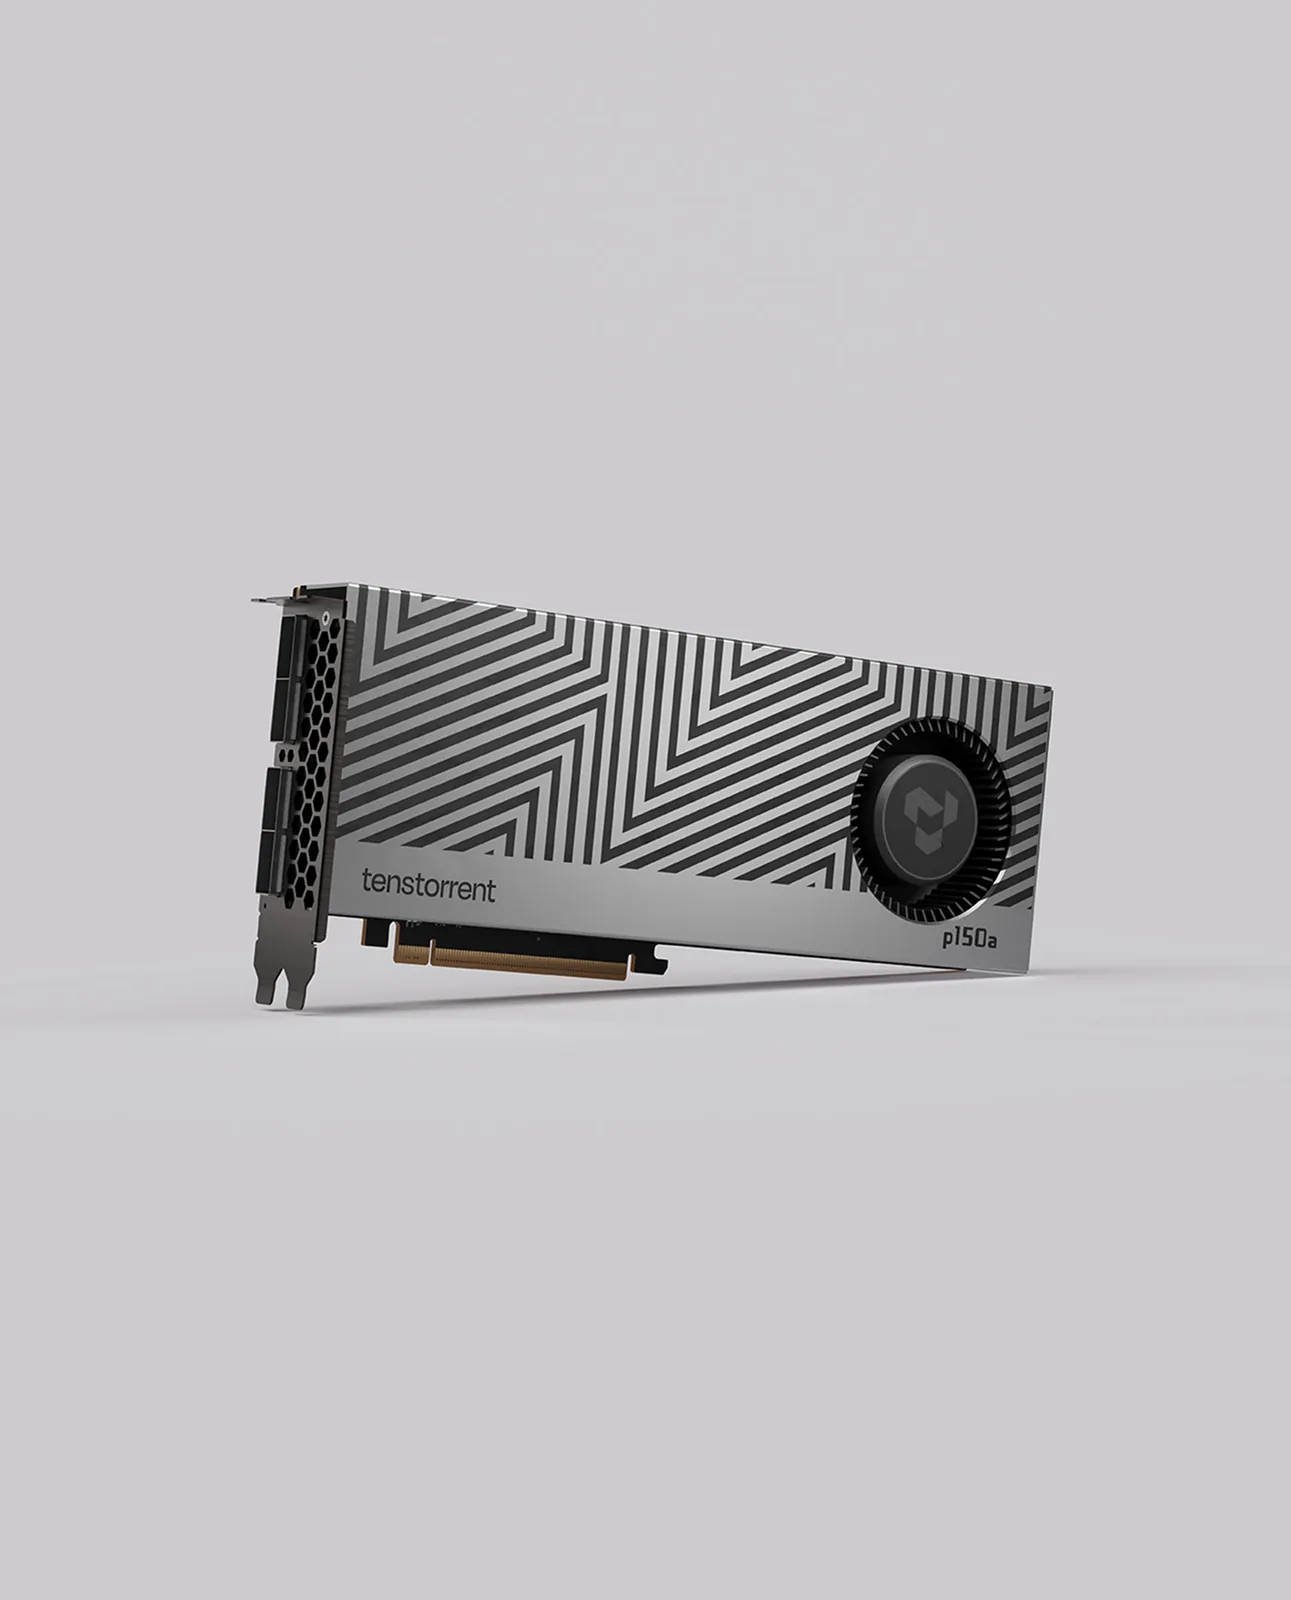
Tenstorrent
Tenstorrent Blackhole p150a
- 32 GB
- Tenstorrent Blackhole
Fait tourner jusqu'à 30–34B en 4 bits
Ce n'est pas une carte CUDA. Vérifiez avant l'achat que les modèles dont vous avez besoin sont pris en charge par la bibliothèque de modèles open source de Tenstorrent.
1 399 €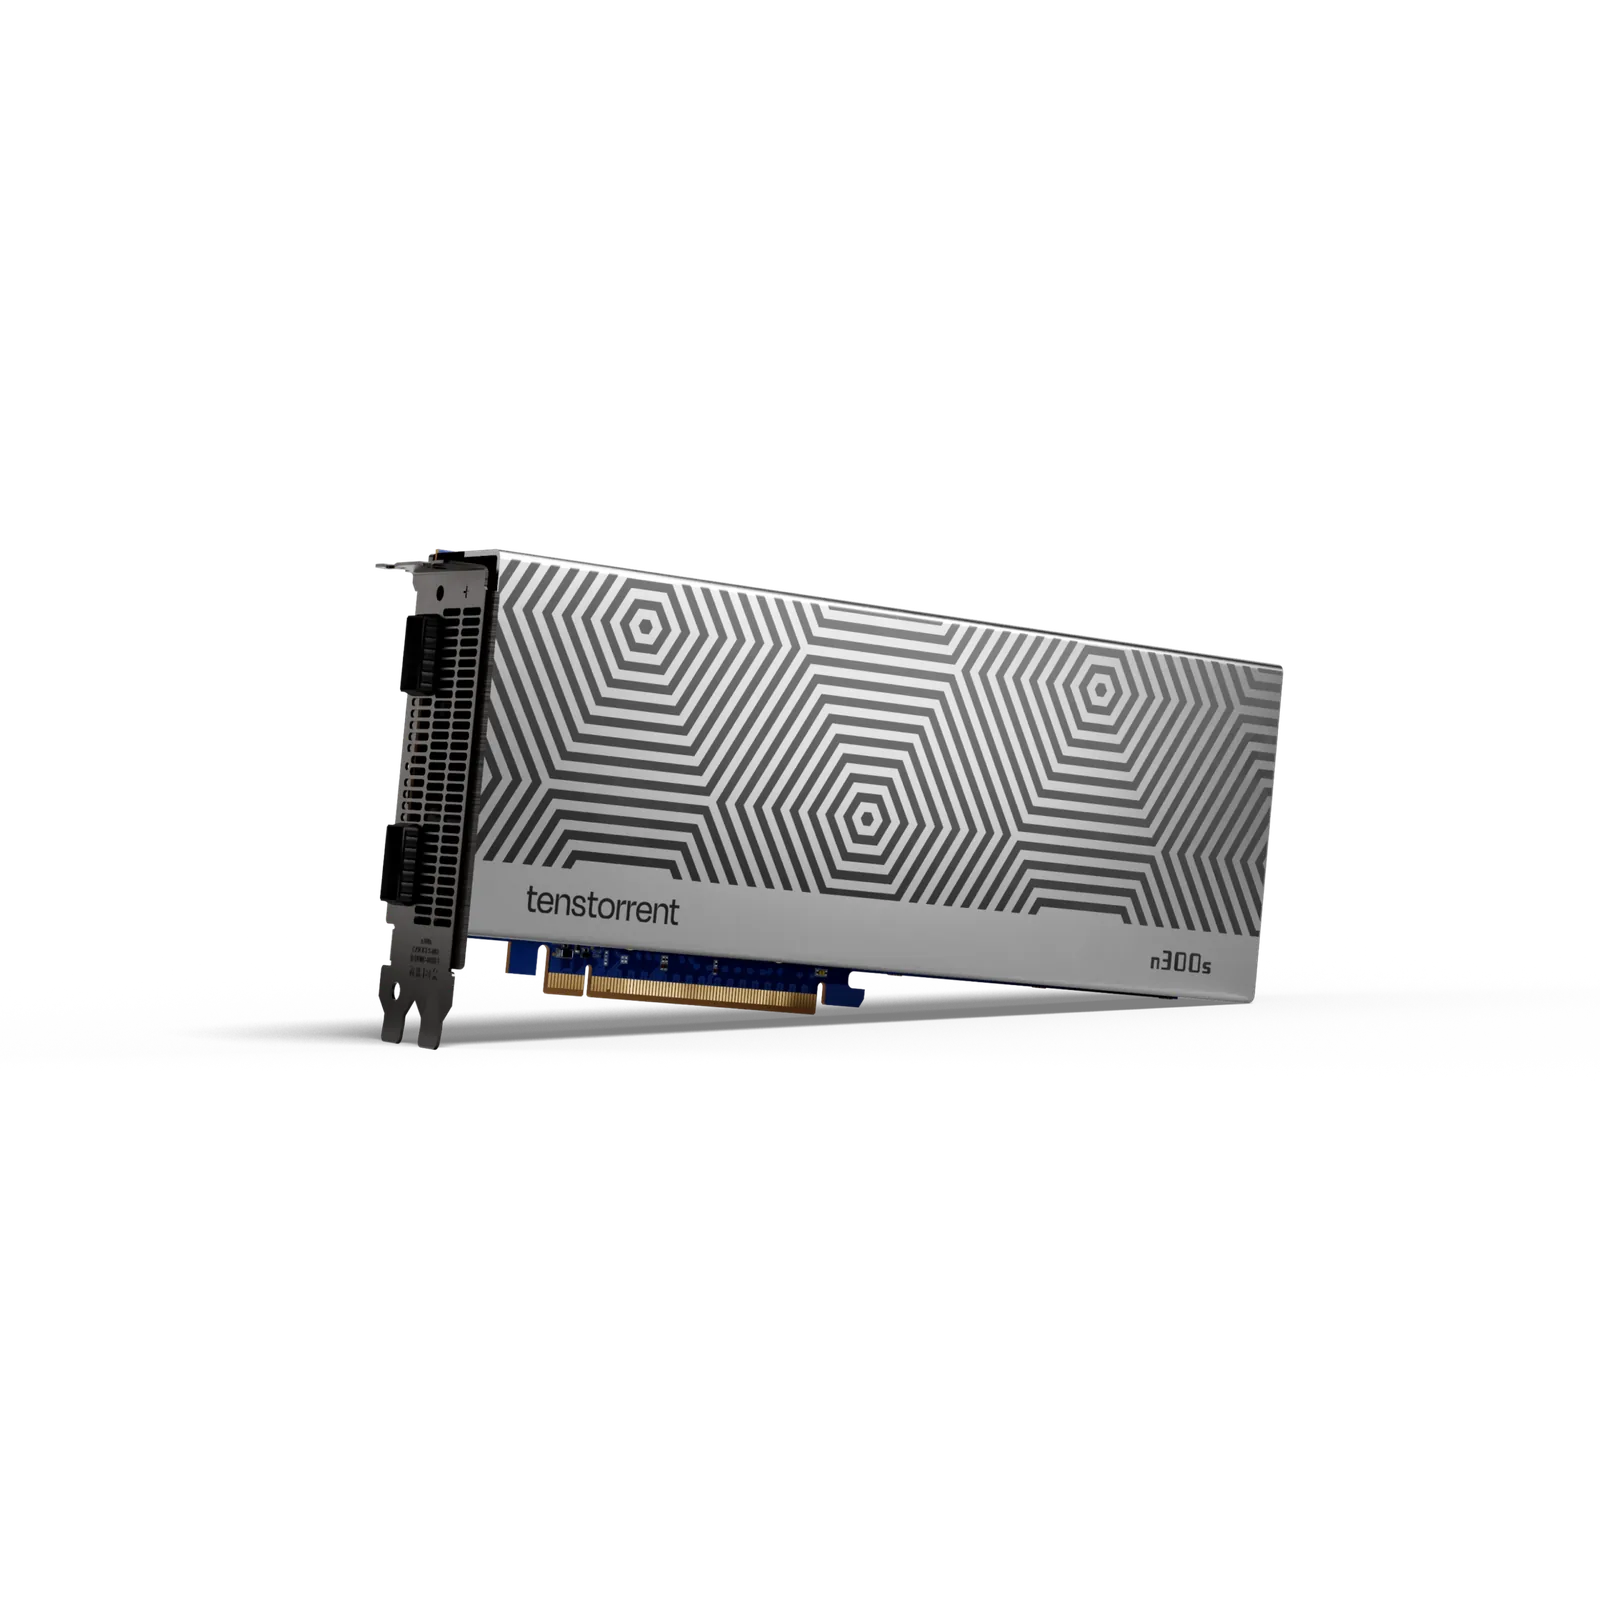
Tenstorrent
Tenstorrent Wormhole n300s
- 24 GB
Fait tourner jusqu'à 30–34B en 4 bits
Les 24 GB sont répartis sur deux puces (12 GB chacune) : les modèles les plus grands doivent donc être répartis sur les deux. Vérifiez que le modèle souhaité dispose d'une version multipuce fonctionnelle.
1 399 €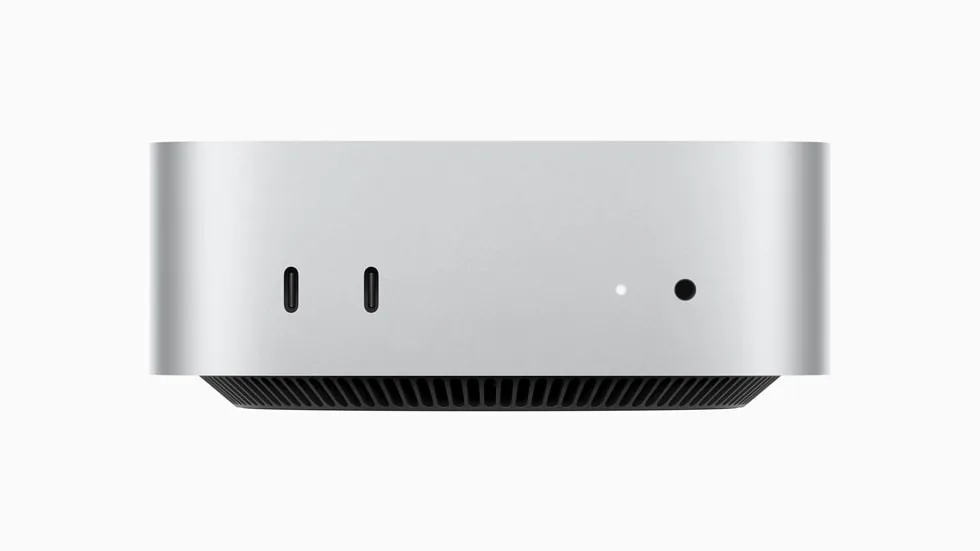
Apple
Apple Mac mini (M4 Pro)
- 24 GB unifiés
- 16 cœurs ; option 20 cœurs
Fait tourner jusqu'à 13–14B en 4 bits
La mémoire ne peut pas être augmentée après l'achat. Si l'IA locale est votre objectif, choisissez dès maintenant 48 GB ou 64 GB. Avec 24 GB, les modèles au-delà d'environ 14B paramètres sont à l'étroit.
1 399 €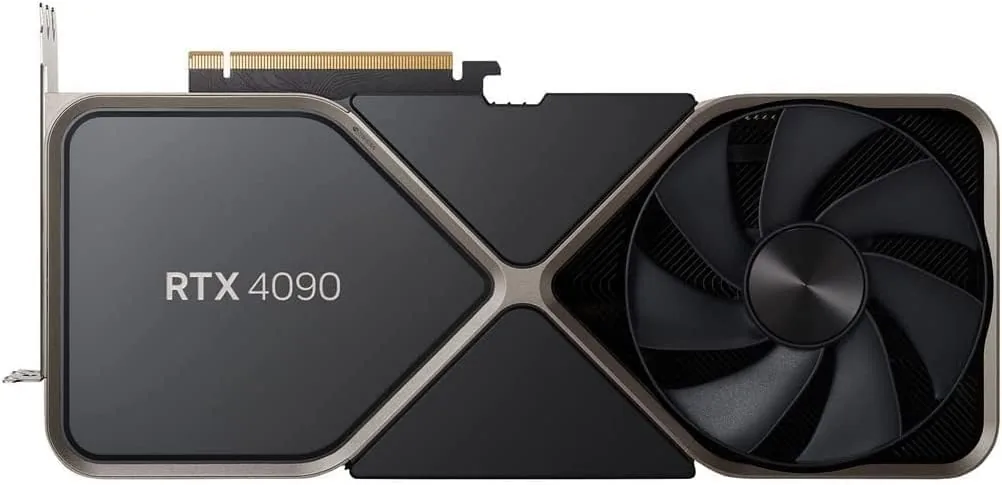
NVIDIA
NVIDIA GeForce RTX 4090
- 24 GB
- NVIDIA Ada Lovelace (AD102)
Fait tourner jusqu'à 30–34B en 4 bits
Enfoncez complètement le câble d'alimentation 16 broches dans la carte et évitez les pliures serrées près du connecteur. Un connecteur mal enfiché est la cause de problème la plus fréquente avec cette carte.
1 599 €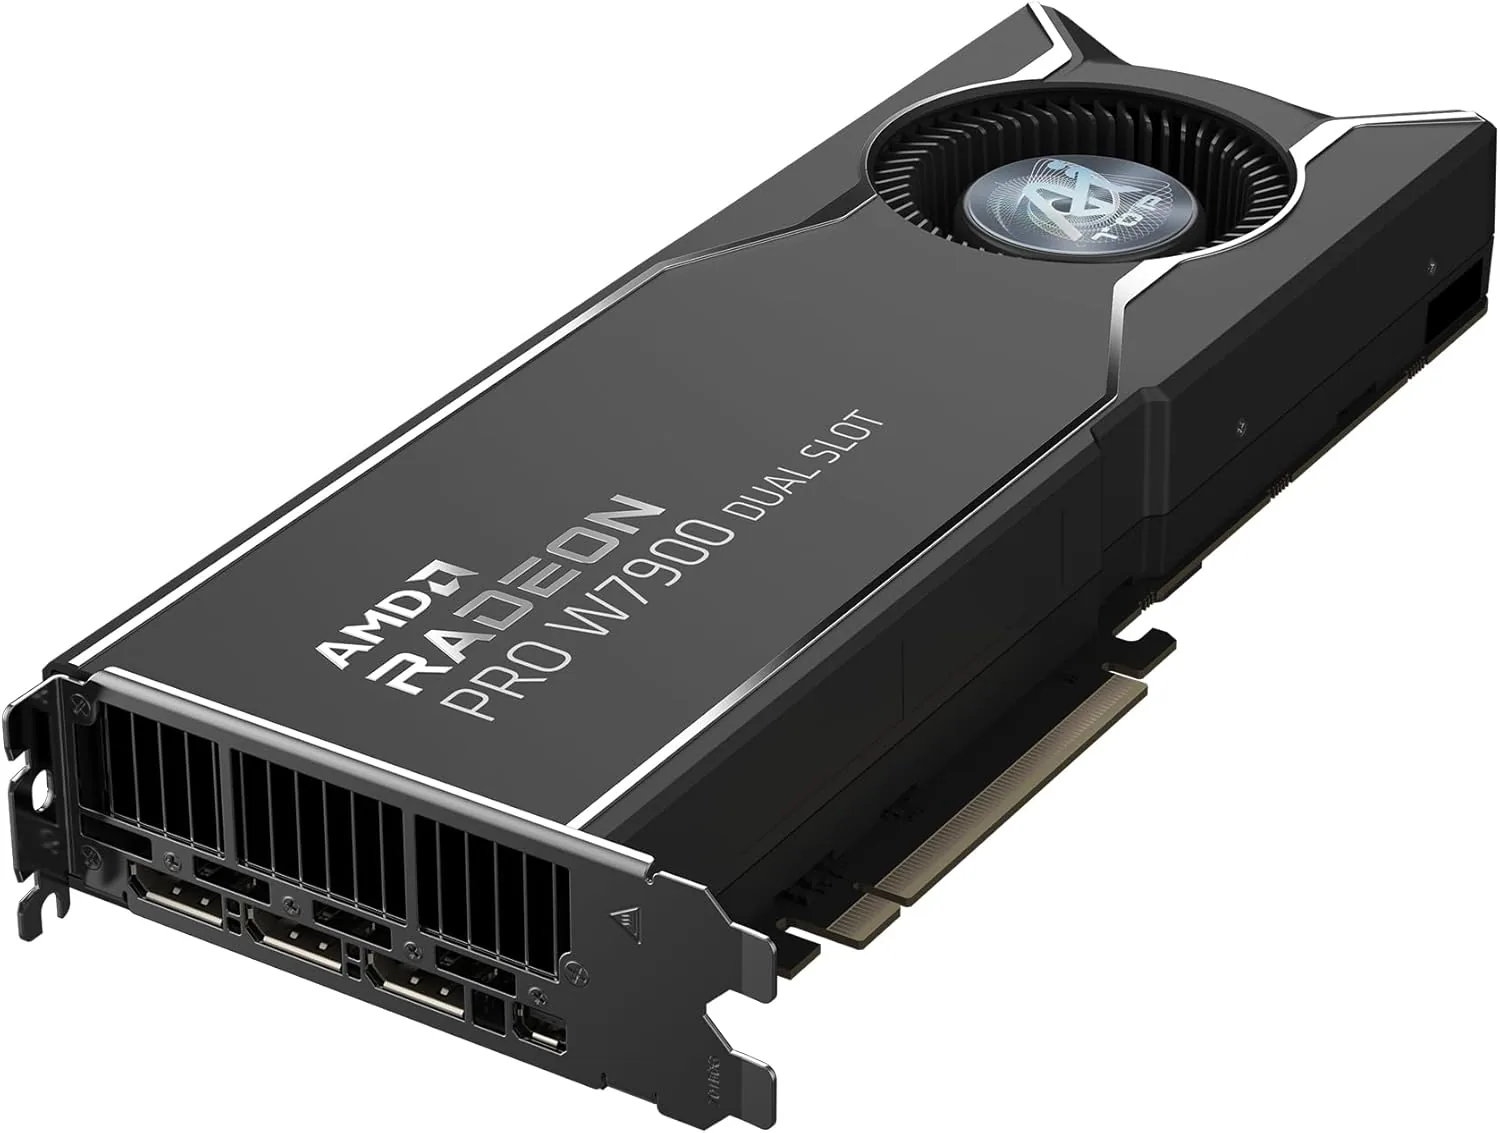
AMD
AMD Radeon PRO W7900 (48 GB)
- 48 GB
- AMD RDNA 3 (Navi 31)
Fait tourner jusqu'à 70B en 4 bits
Choisissez la W7900 si la taille des modèles ou des scènes prime. La R9700, plus récente, a moins de mémoire (32 GB) mais prend en charge le FP8 et offre un meilleur rendement par watt en IA.
3 592 €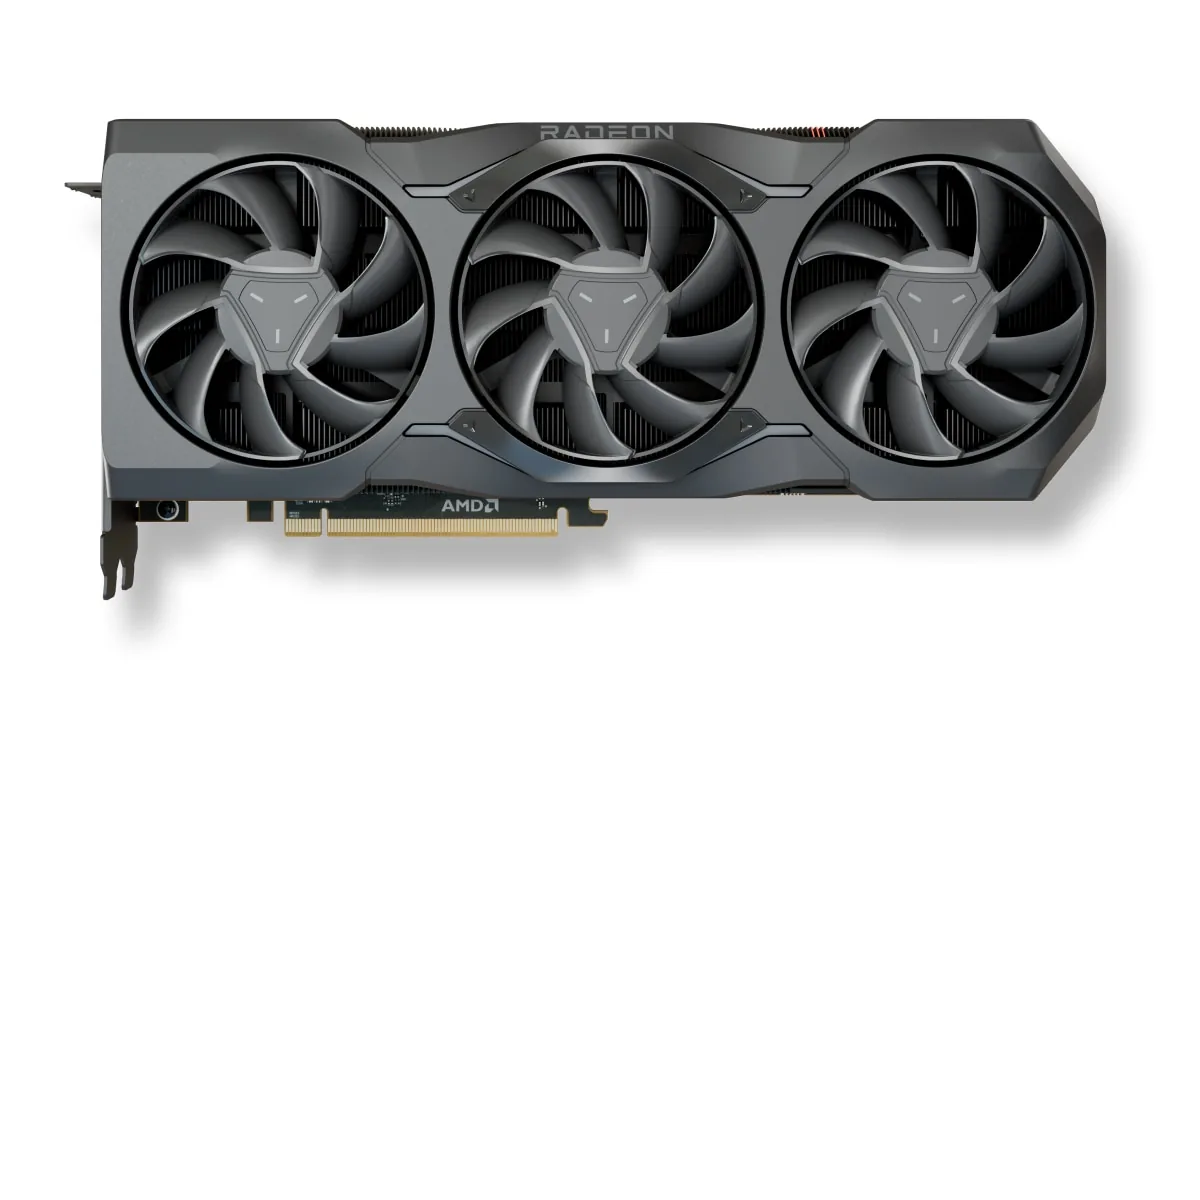
SAPPHIRE
SAPPHIRE PULSE AMD Radeon RX 7900 XTX 24GB
- 24 GB
- AMD RDNA 3 (Navi 31)
Fait tourner jusqu'à 30–34B en 4 bits
La PULSE mesure 313 mm de long et occupe 2,7 slots, avec trois connecteurs d'alimentation 8 broches. Mesurez votre boîtier et vérifiez votre alimentation (800 W minimum) avant de commander.
899 €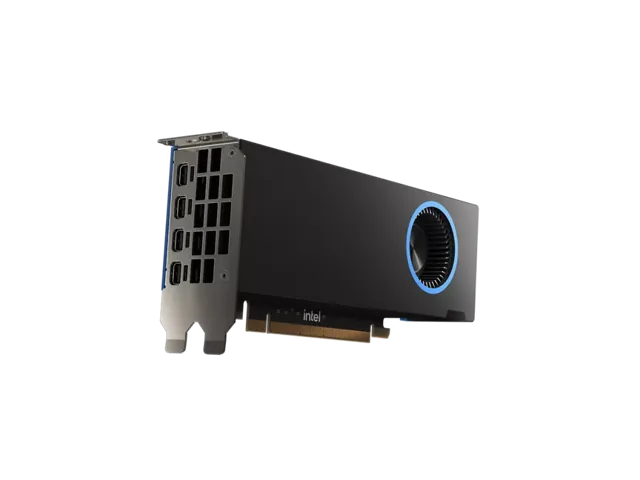
Intel
Intel Arc Pro B50
- 16 GB
- Intel Xe2 (Battlemage)
Fait tourner jusqu'à 13–14B en 4 bits
Aucun câble d'alimentation n'est nécessaire : elle convient aux machines au format compact. 16 GB permettent de faire tourner des modèles 7B à 14B en 4 bits ; au-delà, il faut une carte plus grosse.
299 €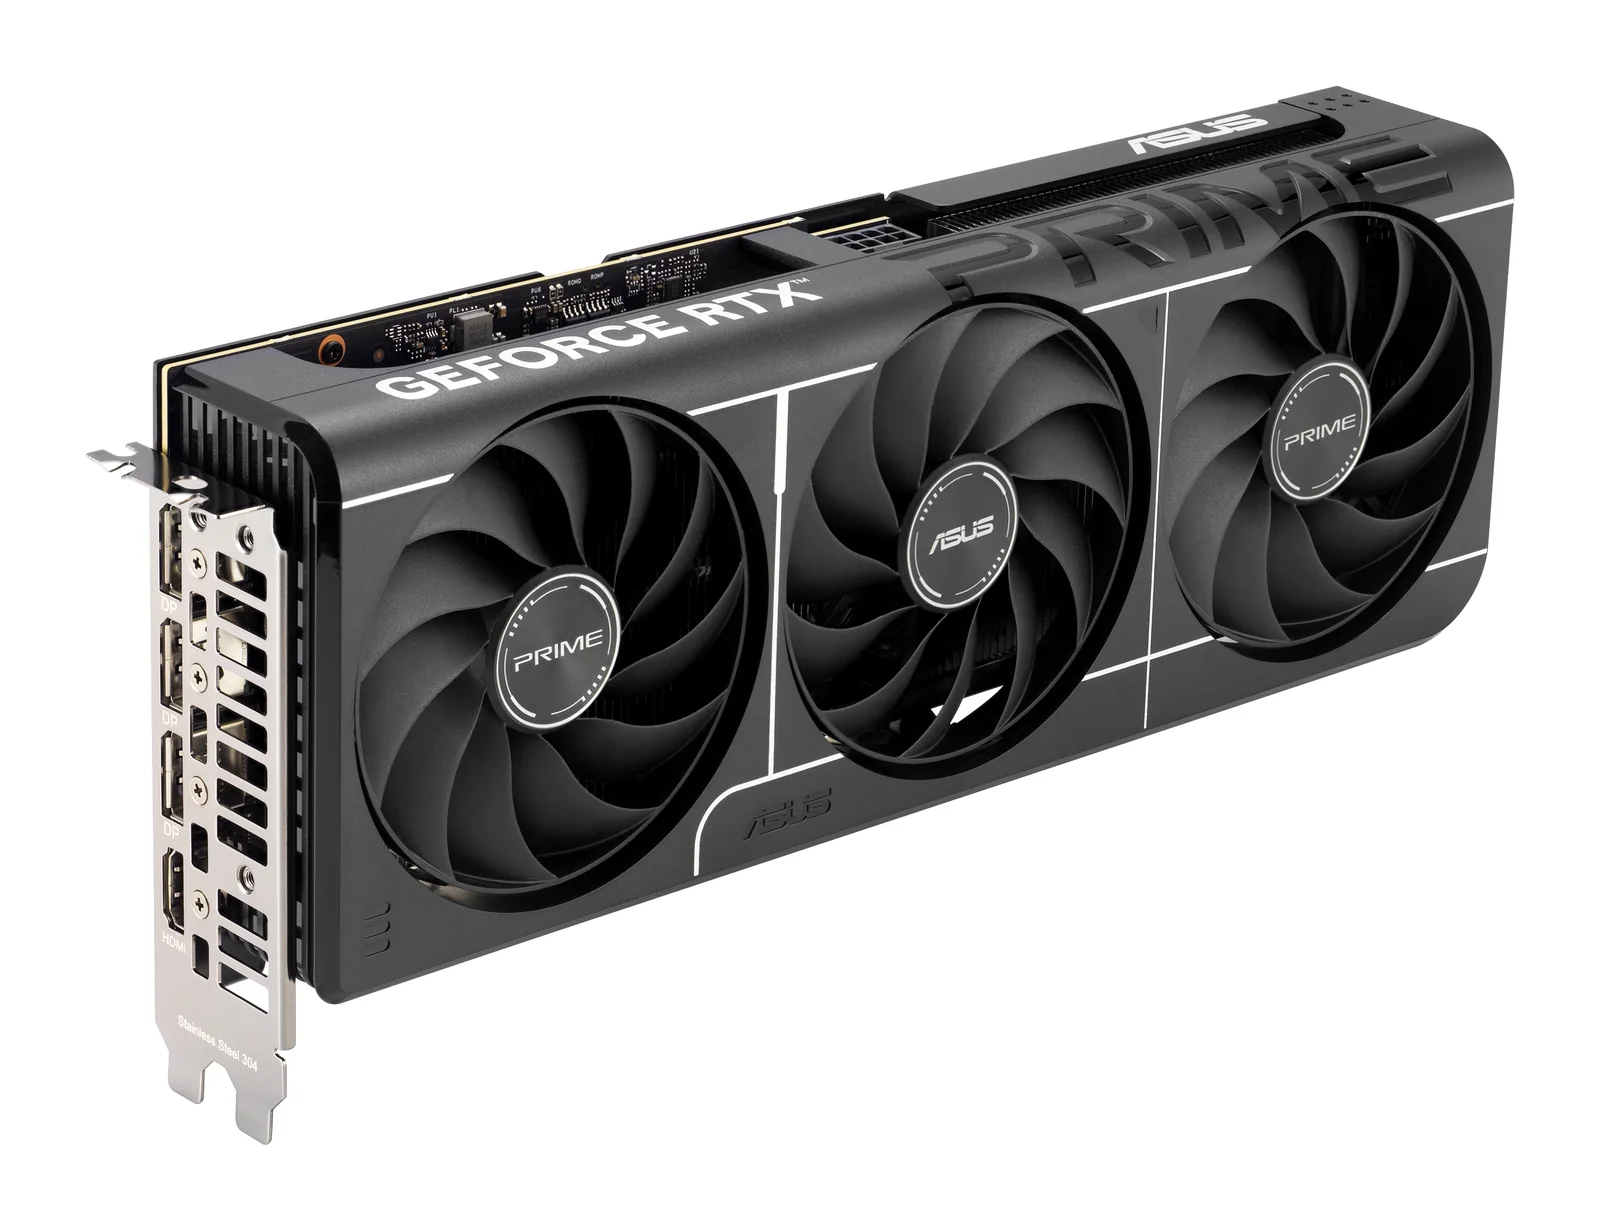
ASUS
ASUS Prime GeForce RTX 5060 Ti 16GB OC Edition
- 16 GB
- NVIDIA GeForce RTX 5060 Ti (Blackwell)
Fait tourner jusqu'à 13–14B en 4 bits
Pour l'IA locale, prenez uniquement la version 16 GB : c'est celle-ci. Son bus mémoire 128 bits est plus étroit que celui des cartes plus haut de gamme, la génération de texte est donc plus lente qu'avec une RTX 5070 Ti.
369 €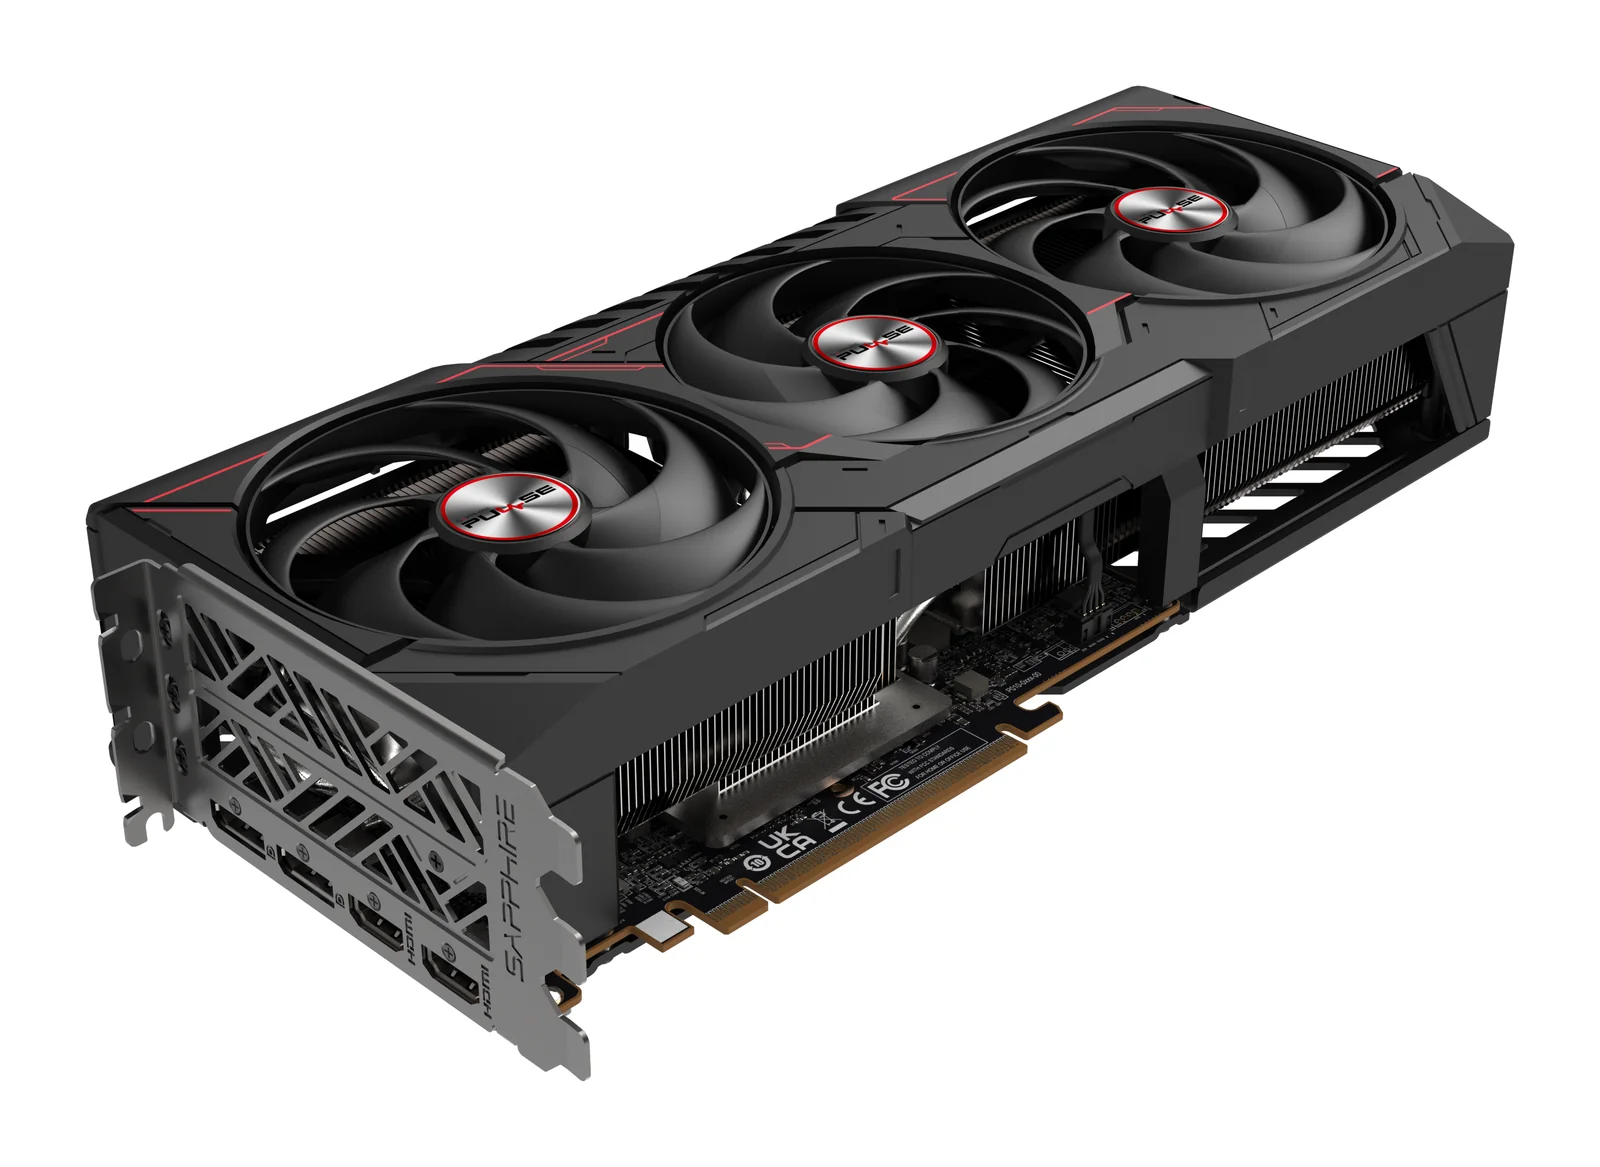
SAPPHIRE
SAPPHIRE PULSE AMD Radeon RX 9070 XT 16GB
- 16 GB
- AMD Radeon RX 9070 XT (RDNA 4)
Fait tourner jusqu'à 13–14B en 4 bits
La carte mesure 320 mm de long, occupe trois slots et se branche sur deux câbles d'alimentation 8 broches. SAPPHIRE préconise une alimentation d'au moins 750 W : mesurez d'abord votre boîtier.
519 €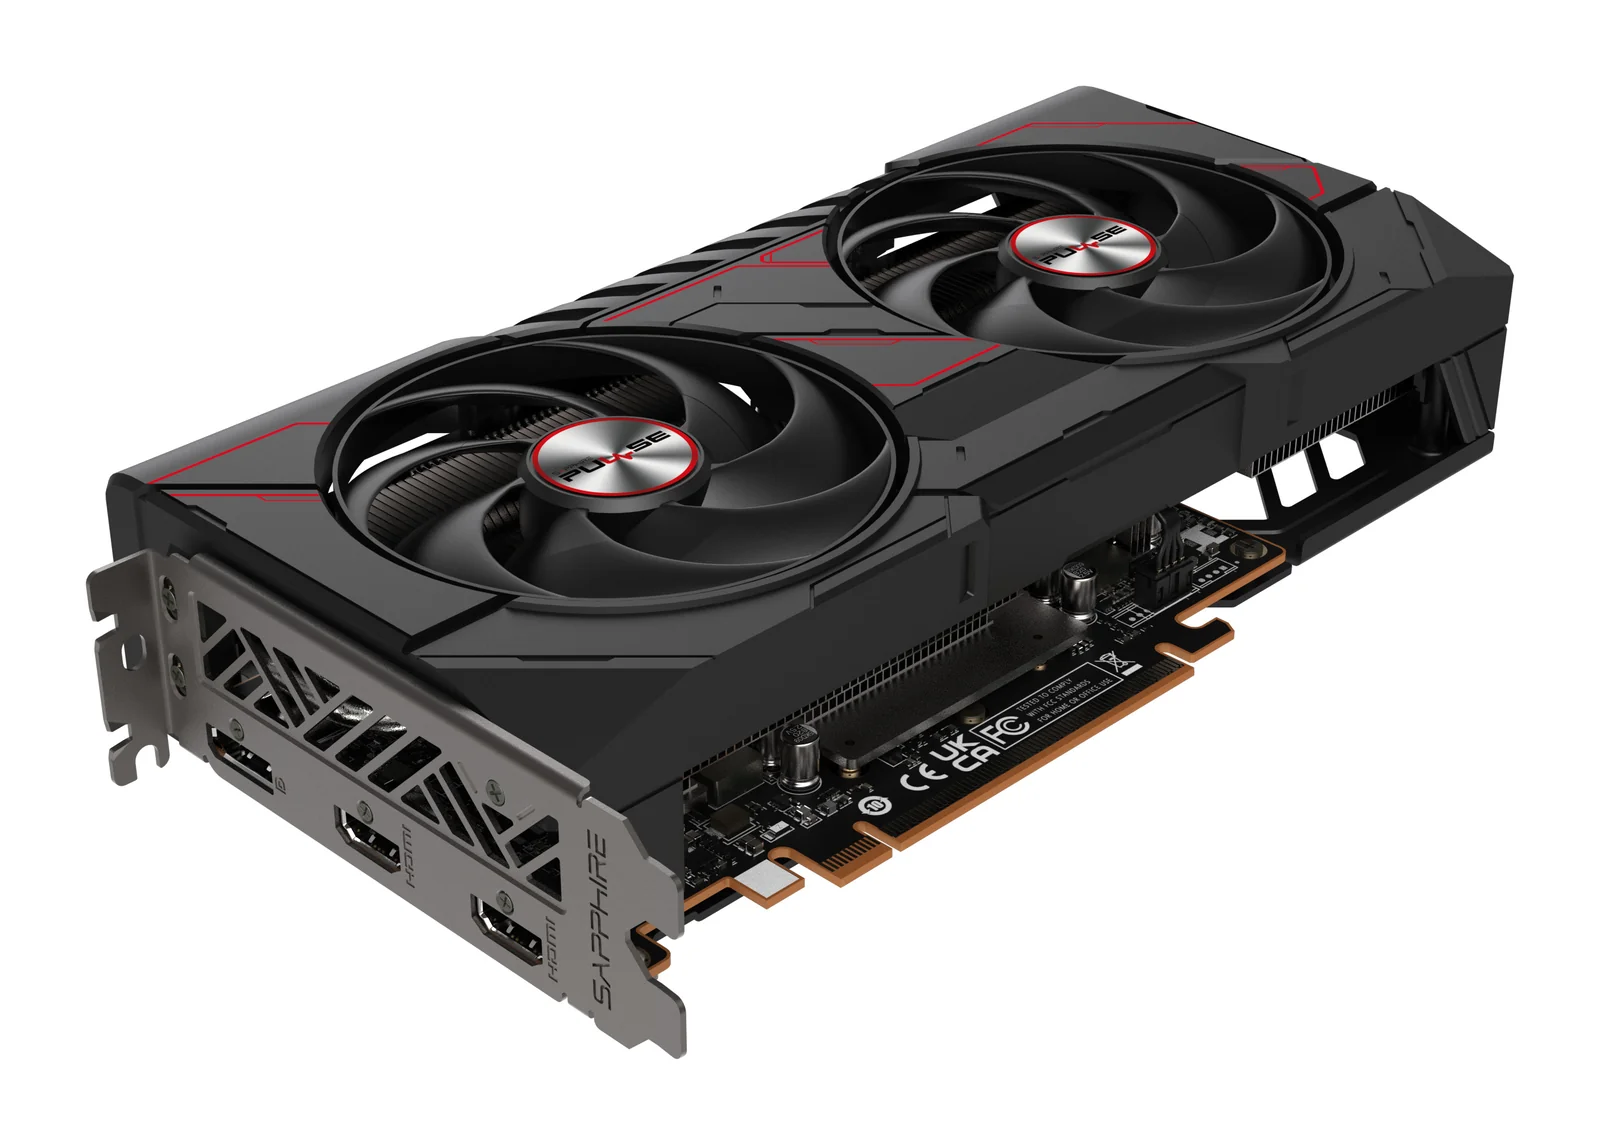
SAPPHIRE
SAPPHIRE PULSE AMD Radeon RX 9060 XT 16GB
- 16 GB
- AMD Radeon RX 9060 XT (RDNA 4)
Fait tourner jusqu'à 13–14B en 4 bits
Il s'agit de la version 16 GB ; la version 8 GB est une autre carte, qui manque déjà de mémoire dans les jeux récents. Un seul câble 8 broches et une alimentation de 450 W suffisent.
299 €Bien choisir son matériel d'IA locale
- Comptez la mémoire utilisable, pas la valeur affichée
- Notre guide des modèles considère comme utilisables 90 % de la mémoire d'une carte graphique et 75 % de la mémoire unifiée, car le système d'exploitation se réserve une partie de la mémoire partagée. Un Mac de 64 GB laisse environ 48 GB aux modèles ; une carte de 48 GB, environ 43 GB.
- Adapter la mémoire à la taille du modèle
- Jusqu'à 14B en 4 bits : une carte de 16 GB ou un Mac mini de 24 GB. Classe 30B en 4 bits : une carte de 24 GB ou de 32 GB. 70B en 4 bits : une carte de 48 GB, deux cartes de 24 GB ou au moins 64 GB de mémoire unifiée. 70B en 8 bits et classe 120B en 4 bits : une carte de 96 GB ou une machine à 128 GB de mémoire unifiée.
- Choisissez la plateforme adaptée à vos outils
- NVIDIA si vos outils exigent CUDA ou si vous jouez aussi. Un Mac Studio pour les grands modèles dans un boîtier quasi silencieux. Un mini PC Ryzen AI Max+ pour disposer de 128 GB sous Windows ou Linux. Le DGX Spark si vous développez sur CUDA avant de déployer sur des systèmes NVIDIA plus imposants.
- Une fois le modèle chargé, c'est la bande passante qui fait la vitesse
- Chaque nouveau token implique de relire les poids : un modèle écrit donc plus vite sur une machine dotée d'une bande passante mémoire plus élevée : 1 792 GB/s sur la RTX 5090, 819 GB/s sur le Mac Studio, 273 GB/s sur le Mac mini M4 Pro et le DGX Spark.
- Quand une machine moins chère suffit
- Conversation, résumés, complétion de code, recherche dans vos propres documents : tout cela fonctionne avec des modèles de 7B à 14B, qui tiennent dans 16 GB. L'Arc Pro B50 ou un Mac mini de 24 GB suffit pour cela. Prévoyez de la marge si vous travaillez sur de longs documents.
Questions fréquentes
Puis-je faire tourner un modèle 70B sur une seule carte graphique ?
Seulement sur une carte de 48 GB ou plus. La Radeon PRO W7900 (48 GB) l'accueille tout juste en 4 bits, et la RTX PRO 6000 (96 GB) l'accueille en 8 bits. Une carte de 32 GB comme la RTX 5090 n'y suffit pas.
Que signifient 4 bits et 8 bits pour le matériel dont j'ai besoin ?
En 4 bits, le modèle occupe environ moitié moins de mémoire qu'en 8 bits, avec une légère perte de qualité : c'est ainsi que la plupart des gens font tourner leurs modèles chez eux. Le 8 bits préserve davantage la qualité mais demande à peu près deux fois plus de mémoire, ce qui se justifie pour le code ou l'extraction de données exactes.
Combien de mémoire supplémentaire faut-il pour les longues conversations et les longs documents ?
La mémoire de contexte augmente avec chaque token que le modèle prend en compte : prévoyez plus que la taille du modèle lui-même. Choisissez la capacité de mémoire supérieure plutôt qu'une capacité qui accueille tout juste le modèle.
Le matériel d'IA locale convient-il au fine-tuning ?
Le fine-tuning demande plus de mémoire que l'exécution d'un modèle. Les méthodes économes en paramètres comme LoRA réduisent fortement ce besoin ; pour les travaux sous CUDA, le DGX Spark, avec ses 128 GB, offre de la marge à des tailles hors de portée d'une carte de 32 GB.
Pouvez-vous assembler une machine adaptée aux modèles que je veux utiliser ?
Oui. Envoyez une demande de configuration sur mesure en indiquant les modèles que vous voulez utiliser, votre budget et votre pays : nous vous répondrons avec une configuration et un devis.
Pages associées: Cartes graphiques · Mini PC · Apple · Accélérateurs IA
Guides
IA locale · 5 min de lecture
Combien de mémoire faut-il pour faire tourner un LLM en local ?
LLM en local : combien de mémoire pour les modèles de 7B à 120B+ en 4 bits et en 8 bits, mémoire unifiée ou VRAM, et quelles machines pour chaque taille.
Lire le guide →IA locale · 5 min de lecture
Mac, NVIDIA ou Ryzen AI Max+ pour l'IA locale
Mac, NVIDIA ou Ryzen AI Max+ : CUDA chez NVIDIA, mémoire unifiée sur Mac ou 128 GB sur un mini PC. Mémoire, logiciels et compromis pour chaque usage.
Lire le guide →Cartes graphiques · 5 min de lecture
Choisir un GPU pour l'IA locale : RTX 5090, R9700, B60
Choisir un GPU pour l'IA locale selon la mémoire, le logiciel et la bande passante : RTX 5090, Radeon AI PRO R9700, Arc Pro B60, cartes pro 48 et 96 GB.
Lire le guide →