Acquista per utilizzo
Hardware per LLM locali: quale macchina per quale modello
Hardware per LLM locali, per modelli linguistici e di immagini: in privato, offline e senza canoni mensili.
Consiglio d'acquisto: È la memoria a stabilire quali modelli si possono caricare. La velocità viene dopo. Prima si verifica la dimensione del modello, poi si sceglie la macchina.
È la memoria a decidere quali modelli si possono eseguire; la velocità viene dopo. Servono circa 6 GB per un modello 7–8B a 4 bit, circa 42 GB per un 70B e circa 80 GB per un modello di classe 120B: conviene quindi partire dal modello più grande che si vuole usare e scegliere una macchina con abbastanza memoria utilizzabile. Poi si sceglie la piattaforma software: CUDA su NVIDIA, Metal e MLX su Mac, oppure ROCm e Vulkan su AMD.
La nostra selezione
Modelli 70B e di classe 120B in un computer compatto
Ryzen AI Max+ 395
Beelink
Beelink GTR9 Pro
- 128 GB unificati
- AMD Ryzen AI Max+ 395
Esegue modelli fino a 120B+ a 4 bit
Su Windows è possibile assegnare alla GPU fino a 96 GB dei 128 GB disponibili. Prima dell'acquisto si consiglia di verificare che il modello che si intende eseguire rientri in questo limite.
4349 €128 GB di memoria unificata, circa 96 GB per i modelli, su Windows o Linux; per assegnare alla GPU più memoria possibile conviene puntare su Linux.
La massima velocità con modelli fino a 30B
GeForce RTX 5090
NVIDIA
NVIDIA GeForce RTX 5090
- 32 GB
- NVIDIA Blackwell (GB202)
Esegue modelli fino a 30–34B a 4 bit
Con 32 GB i modelli di classe 30B girano senza problemi a 4 bit, ma un modello 70B non entra in una sola scheda. Per un 70B occorrono due schede o un sistema con molta memoria unificata.
1999 €32 GB di GDDR7 a 1.792 GB/s con CUDA. Una sola scheda non basta per un modello 70B.
Modelli grandi, quasi in silenzio
Mac Studio M3 Ultra
Apple
Apple Mac Studio (M3 Ultra)
- 96 GB unificati
- 60 core; opzione a 80 core
Esegue modelli fino a 70B a 4 bit
macOS riserva al sistema una parte della memoria unificata, quindi si consideri che la GPU ne userà la maggior parte, non tutta. Si consiglia una configurazione con un certo margine oltre la dimensione del modello.
3999 €96 GB di serie e 819 GB/s: un modello 70B a 4 bit gira velocemente, mentre la macchina resta quasi silenziosa.
NVIDIA
NVIDIA GeForce RTX 5090
- 32 GB
- NVIDIA Blackwell (GB202)
Esegue modelli fino a 30–34B a 4 bit
Con 32 GB i modelli di classe 30B girano senza problemi a 4 bit, ma un modello 70B non entra in una sola scheda. Per un 70B occorrono due schede o un sistema con molta memoria unificata.
1999 €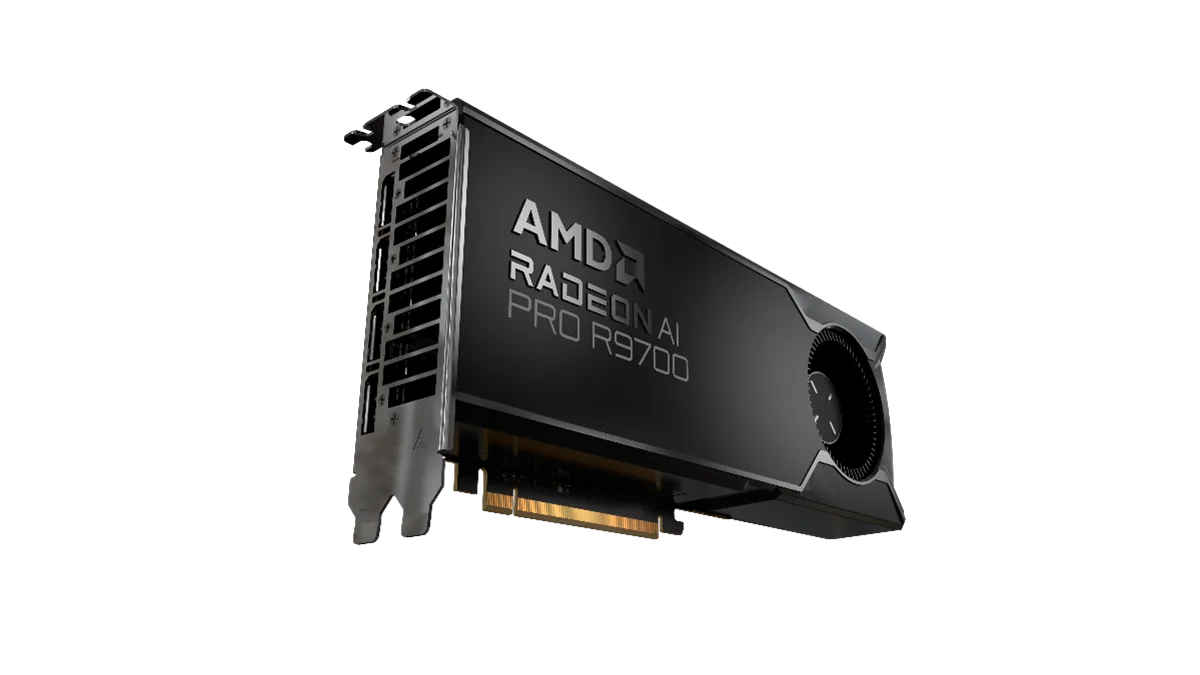
PowerColor
PowerColor AMD Radeon AI PRO R9700 32GB
- 32 GB
- AMD RDNA 4 (Navi 48)
Esegue modelli fino a 30–34B a 4 bit
Prima dell'acquisto, verifichi che i suoi strumenti siano compatibili con ROCm sul suo sistema operativo. PyTorch e llama.cpp lo sono; alcuni strumenti di nicchia richiedono ancora CUDA.
1299 €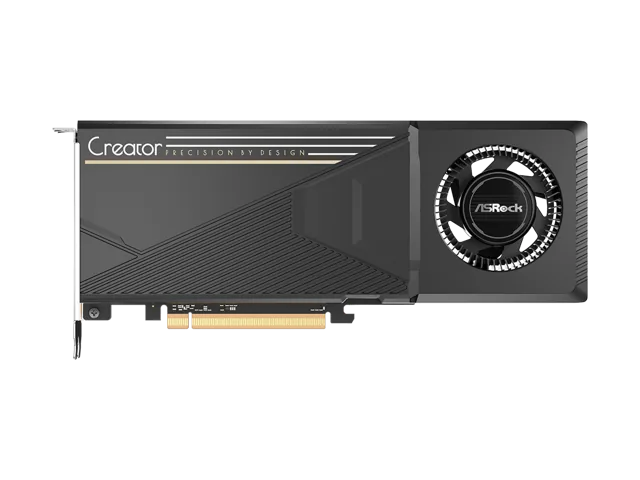
ASRock
ASRock Intel Arc Pro B60 Creator 24GB
- 24 GB
- Intel Xe2 (Battlemage)
Esegue modelli fino a 30–34B a 4 bit
Si tratta di una scheda a GPU singola con 24 GB. Utilizza uno slot PCIe 5.0 cablato a x8 e funziona anche negli slot PCIe 4.0; prima di ordinare, si consiglia di verificare nella scheda tecnica di ASRock la lunghezza esatta e il connettore di alimentazione.
599,99 €Beelink
Beelink GTR9 Pro
- 128 GB unificati
- AMD Ryzen AI Max+ 395
Esegue modelli fino a 120B+ a 4 bit
Su Windows è possibile assegnare alla GPU fino a 96 GB dei 128 GB disponibili. Prima dell'acquisto si consiglia di verificare che il modello che si intende eseguire rientri in questo limite.
4349 €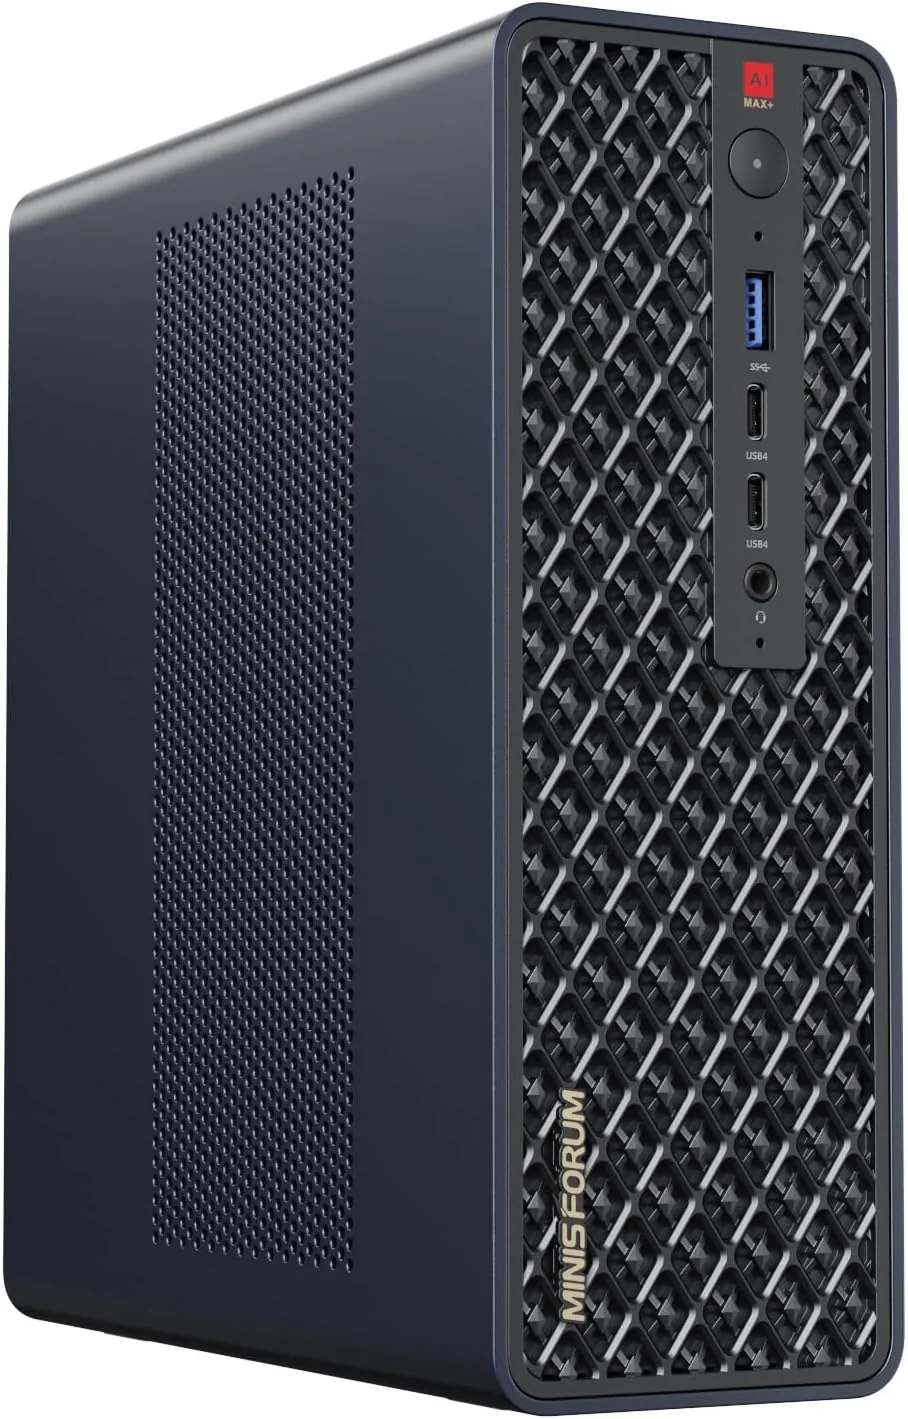
Minisforum
Minisforum MS-S1 Max
- 128 GB unificati
- AMD Ryzen AI Max+ 395
Esegue modelli fino a 120B+ a 4 bit
Lo slot PCIe accetta schede low profile e funziona a x4 linee. È ideale per una scheda di rete più veloce, non per aggiungere una scheda video a grandezza piena.
2469 €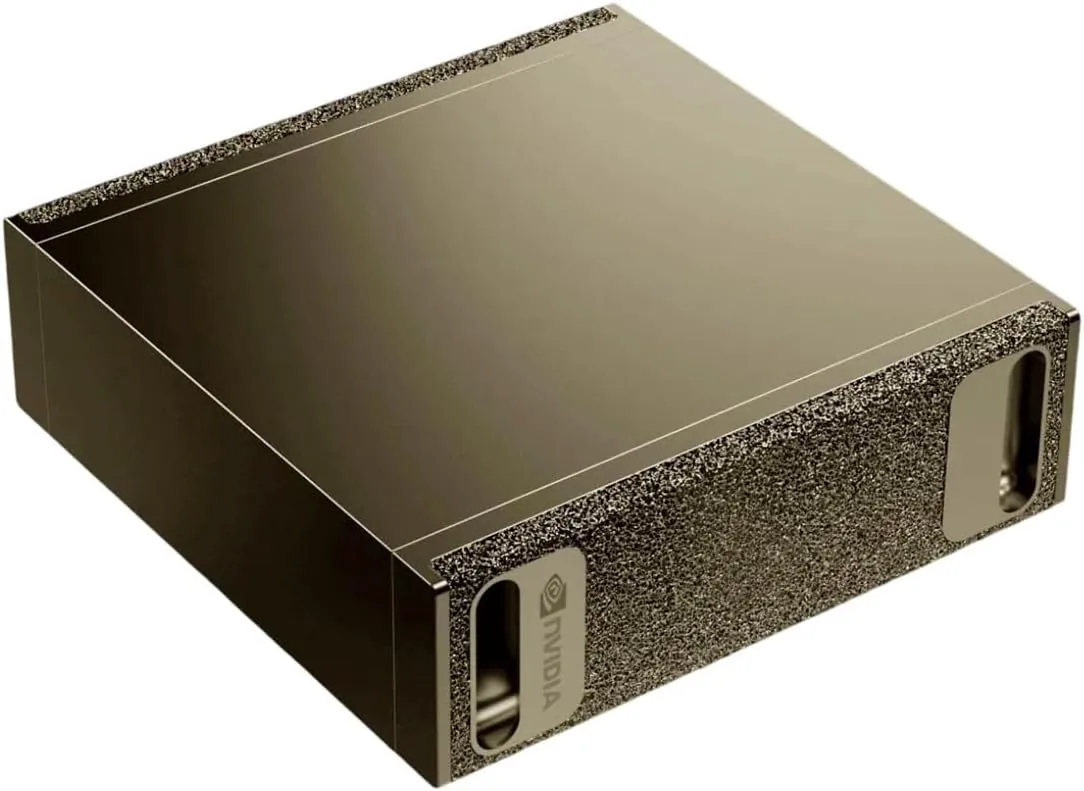
NVIDIA
NVIDIA DGX Spark
- 128 GB unificati
- NVIDIA GB10 Grace Blackwell
Esegue modelli fino a 120B+ a 4 bit
La banda di memoria (273 GB/s) è inferiore a quella di una scheda video di fascia alta, quindi i grandi modelli densi generano testo più lentamente che su una RTX 5090. I suoi punti di forza sono la capacità e lo stack software CUDA.
4699 €Apple
Apple Mac Studio (M3 Ultra)
- 96 GB unificati
- 60 core; opzione a 80 core
Esegue modelli fino a 70B a 4 bit
macOS riserva al sistema una parte della memoria unificata, quindi si consideri che la GPU ne userà la maggior parte, non tutta. Si consiglia una configurazione con un certo margine oltre la dimensione del modello.
3999 €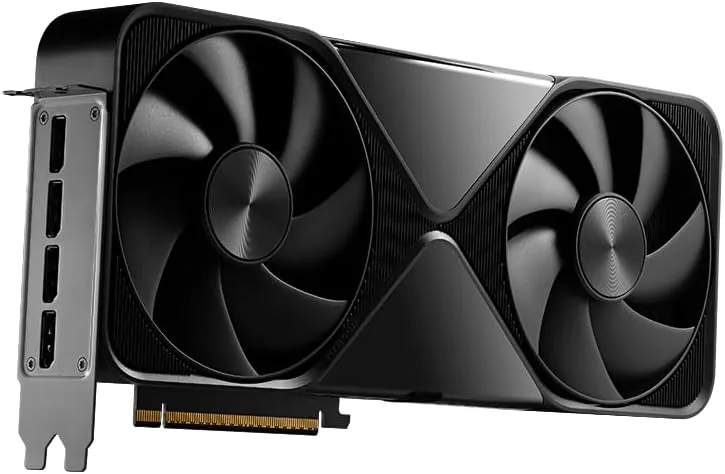
NVIDIA
NVIDIA RTX PRO 6000 Blackwell Workstation Edition (96 GB)
- 96 GB
- NVIDIA Blackwell (GB202)
Esegue modelli fino a 120B+ a 4 bit
Questa è la Workstation Edition da 600 W con dissipatore a doppio flusso passante. Richiede un cavo di alimentazione a 16 pin, un case in grado di ospitare una scheda da 12 pollici e una buona ventilazione.
13.250 €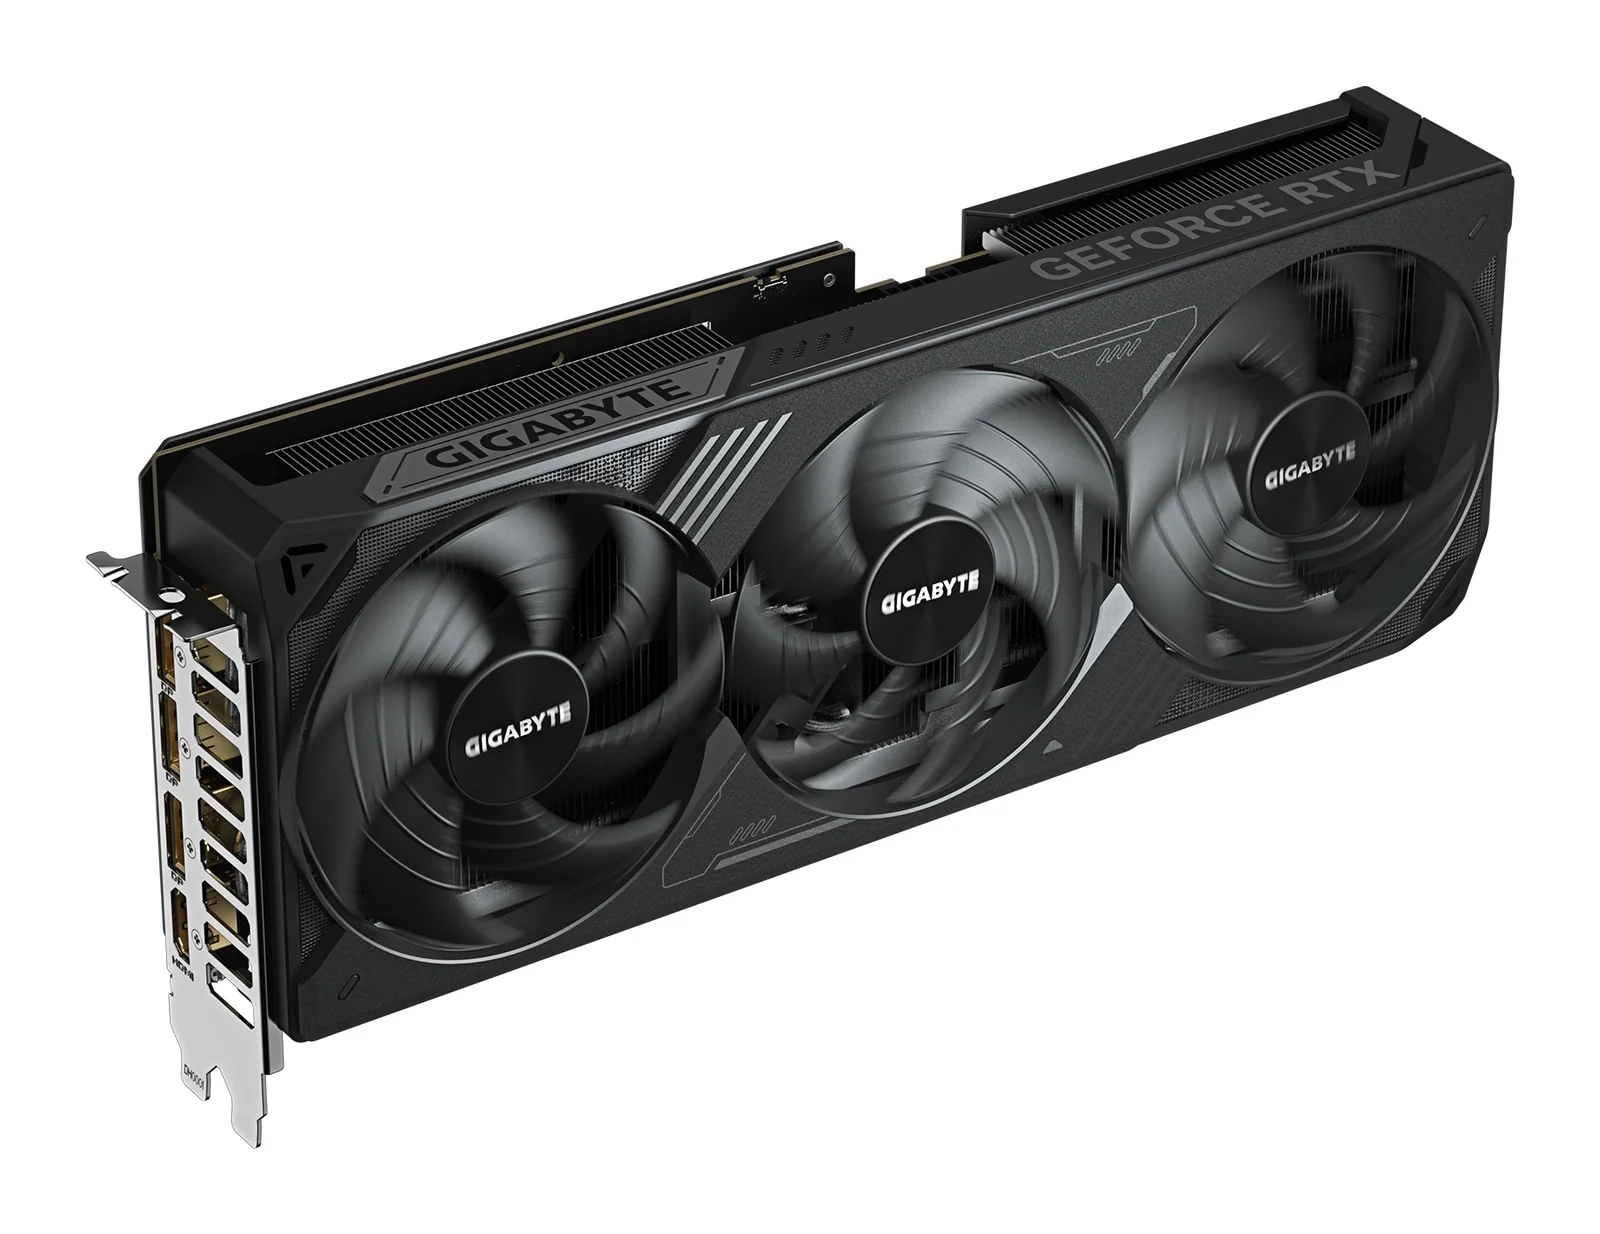
GIGABYTE
GIGABYTE GeForce RTX 5070 Ti WINDFORCE OC SFF 16G
- 16 GB
- NVIDIA GeForce RTX 5070 Ti (Blackwell)
Esegue modelli fino a 13–14B a 4 bit
Richiede un cavo di alimentazione a 16 pin oppure l'adattatore incluso, che utilizza due cavi PCIe a 8 pin. GIGABYTE consiglia un alimentatore da 750 W.
849 €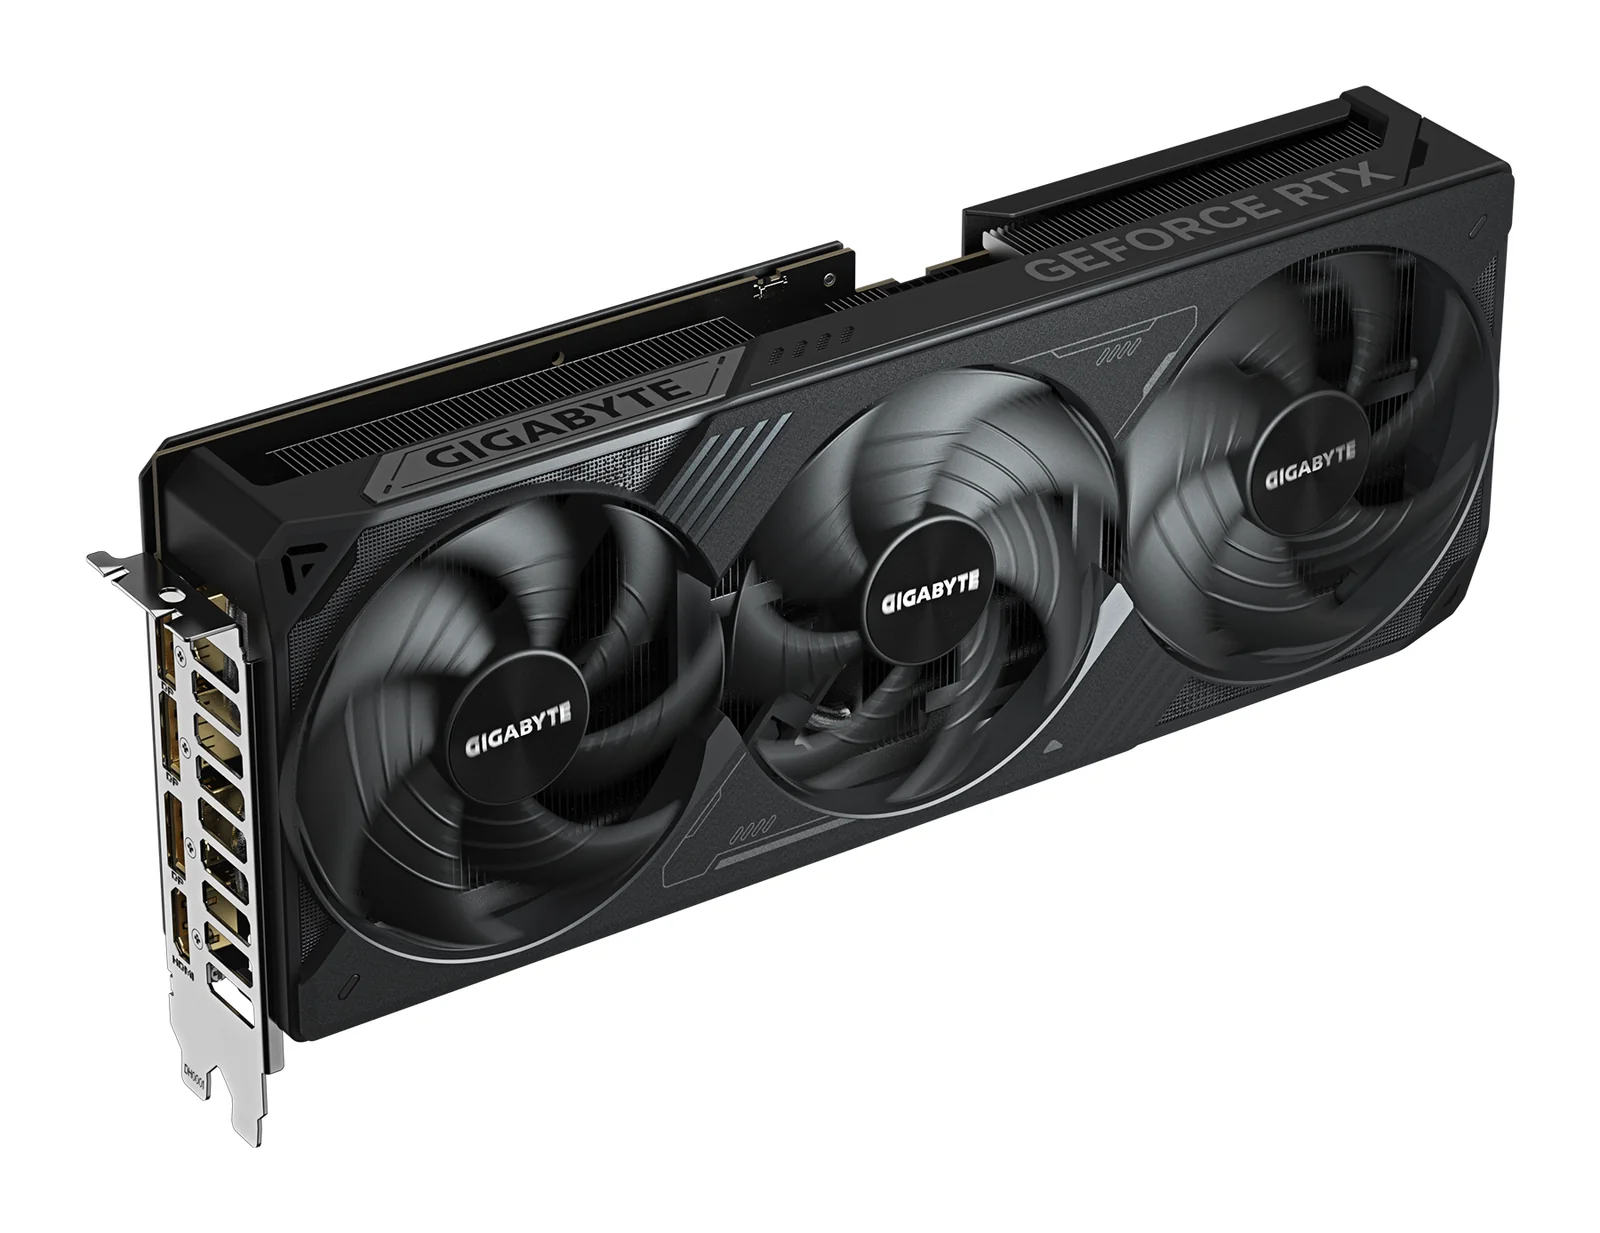
GIGABYTE
GIGABYTE GeForce RTX 5080 WINDFORCE OC SFF 16G
- 16 GB
- NVIDIA GeForce RTX 5080 (Blackwell)
Esegue modelli fino a 13–14B a 4 bit
Ha gli stessi 16 GB della RTX 5070 Ti, quindi non accoglie modelli di IA più grandi: li esegue più velocemente. Per avere più memoria su una sola scheda, si valuti la RTX 5090 o una scheda da 24–32 GB.
1079 €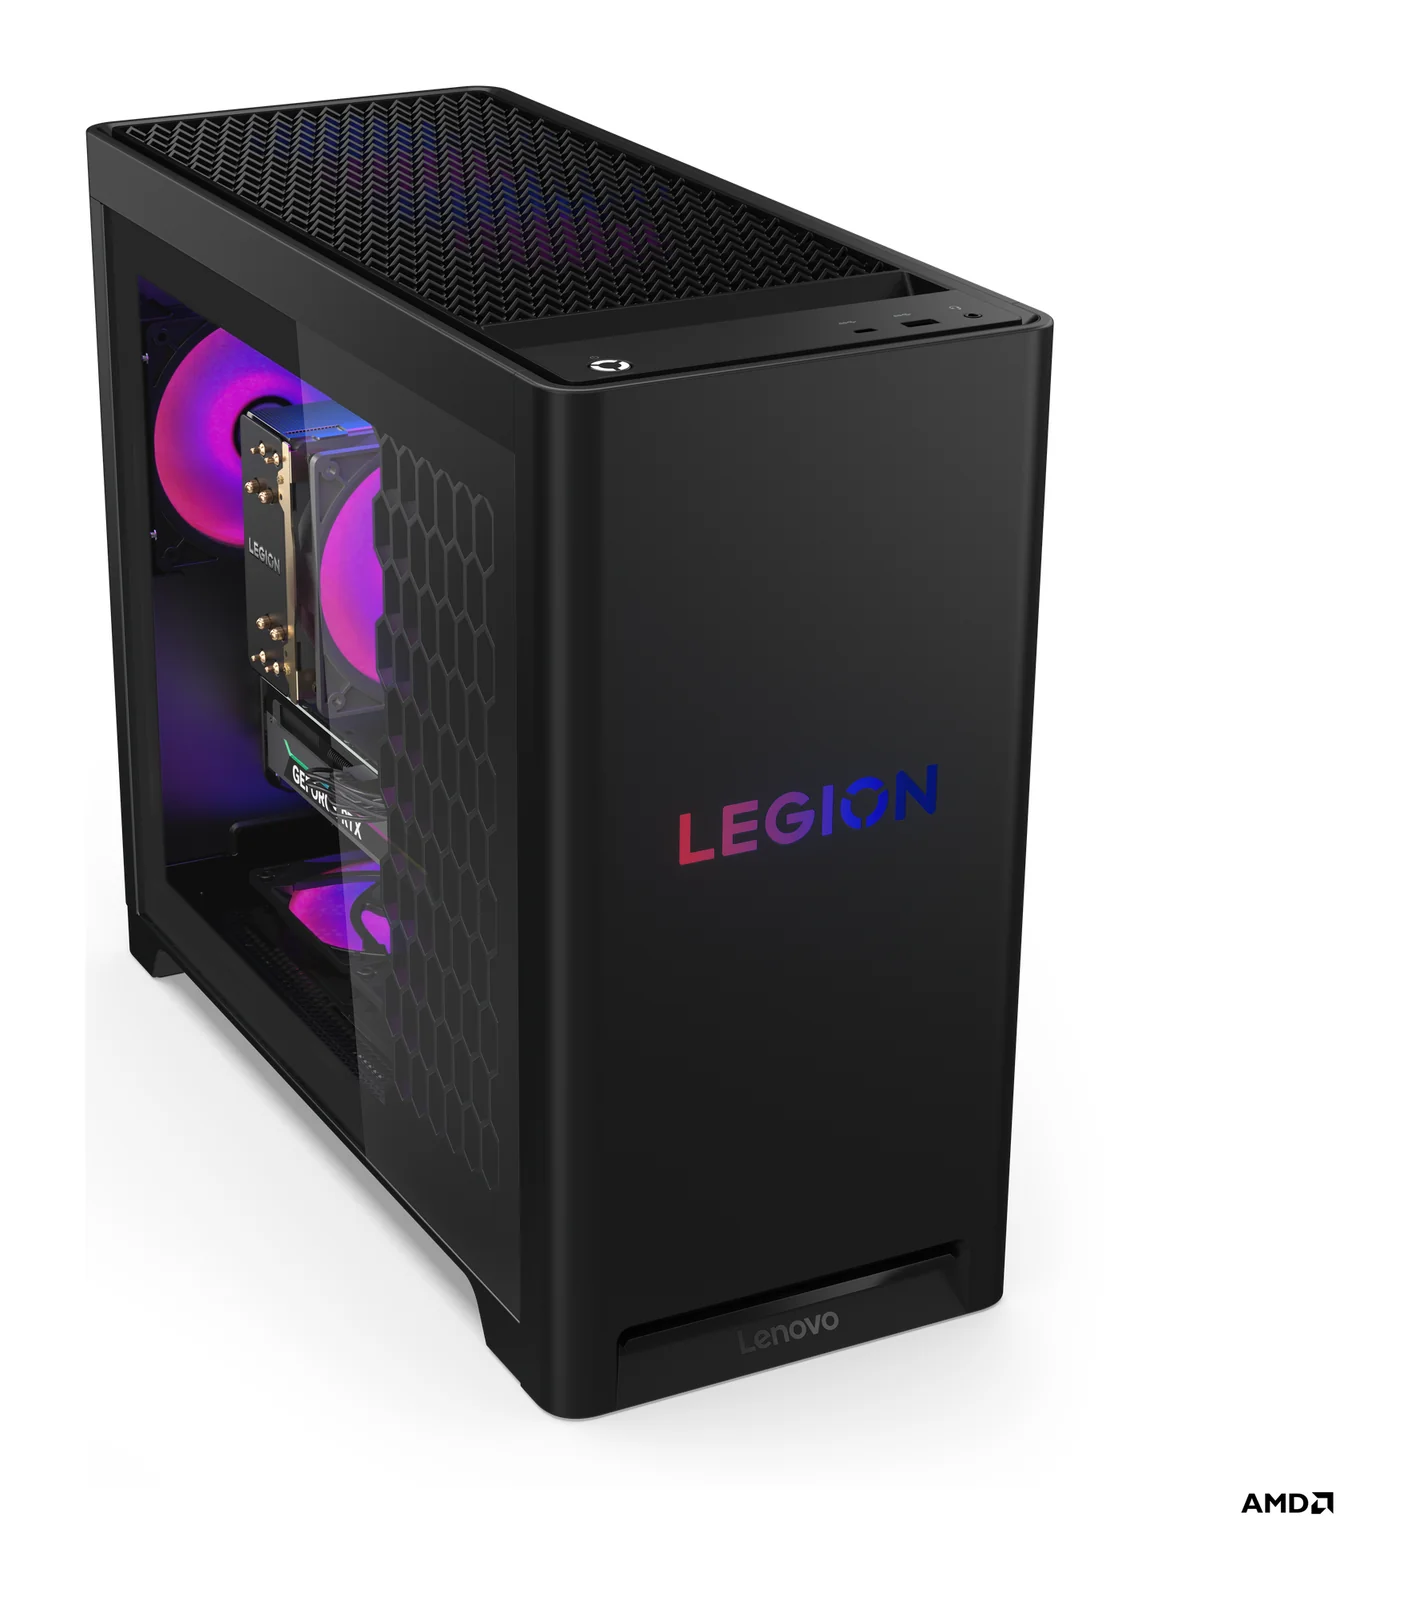
Lenovo
Lenovo Legion Tower 5 Gen 10 (RTX 5070 Ti)
- 32 GB
- AMD Ryzen 7 7800X3D (8 core / 16 thread, 4,2 / 5,0 GHz, 96 MB L3)
La memoria di sistema è composta da due moduli da 16 GB e Lenovo indica 32 GB come massimo per questa tower: conviene quindi considerare 32 GB per tutta la sua vita utile. Lo storage invece è espandibile: ci sono tre slot M.2 e un alloggiamento da 3,5 pollici.
2159 €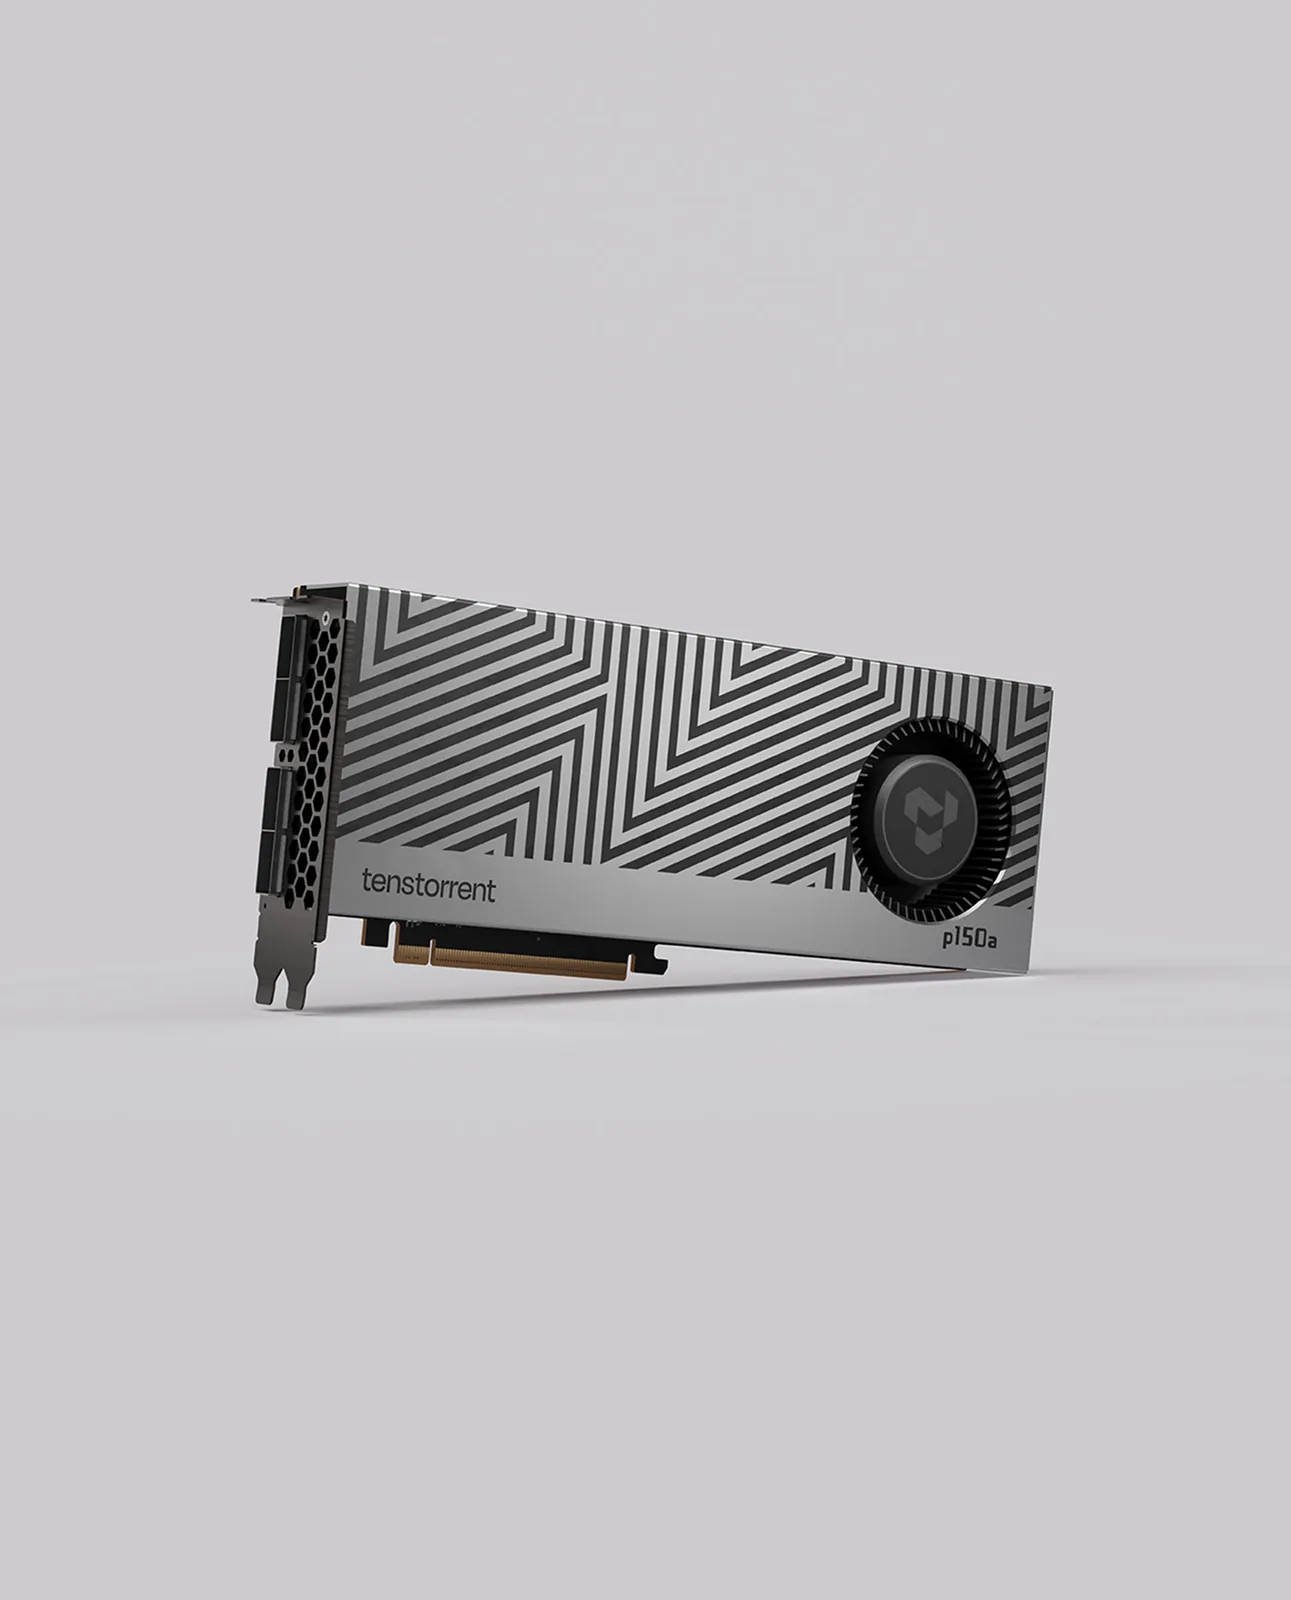
Tenstorrent
Tenstorrent Blackhole p150a
- 32 GB
- Tenstorrent Blackhole
Esegue modelli fino a 30–34B a 4 bit
Non è una scheda CUDA. Prima dell'acquisto si consiglia di verificare che i modelli necessari siano gestiti dalla libreria di modelli open source di Tenstorrent.
1399 €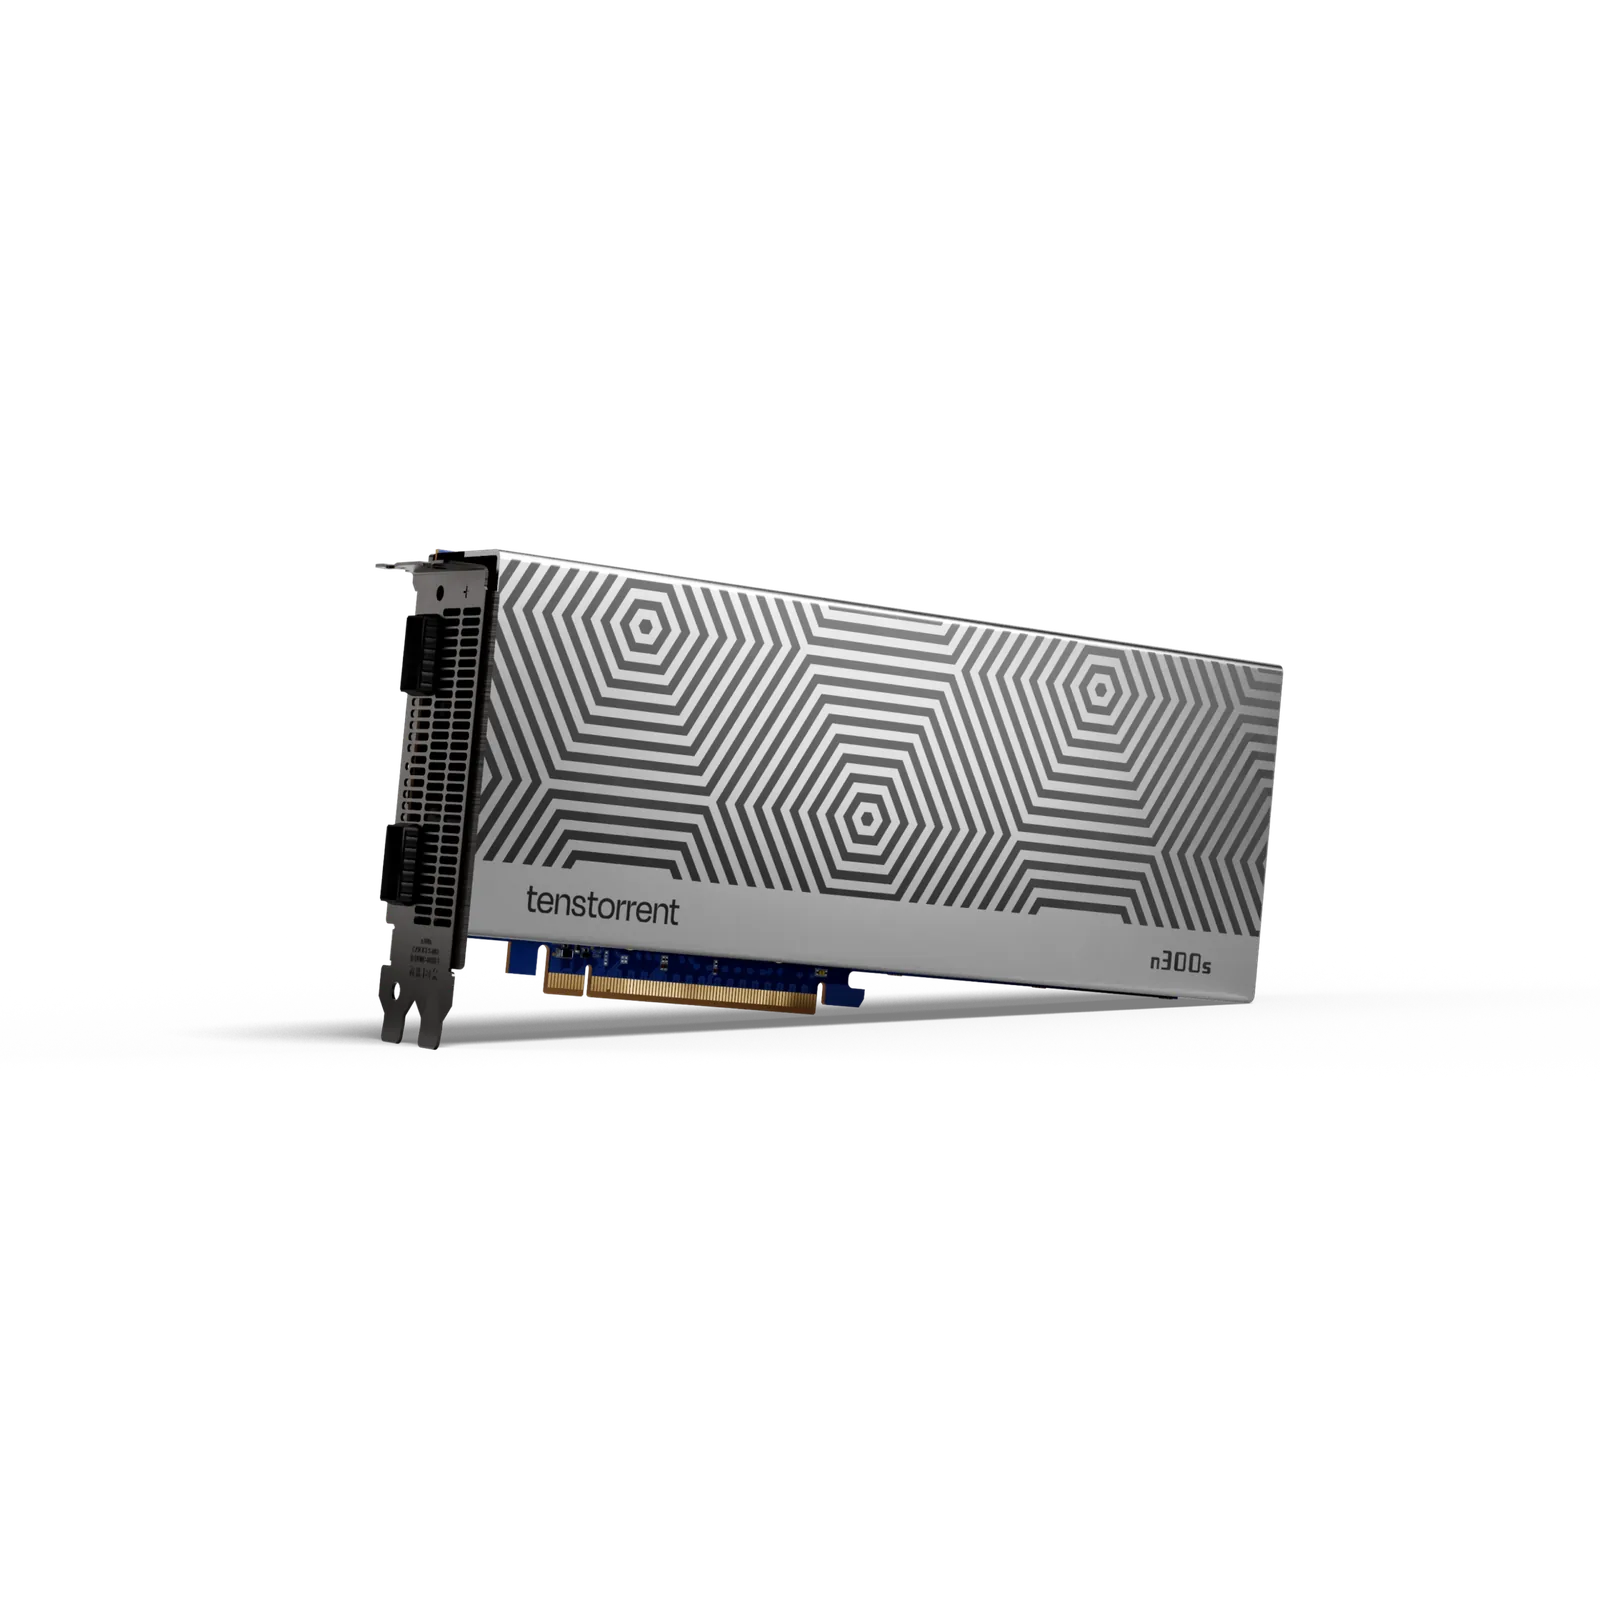
Tenstorrent
Tenstorrent Wormhole n300s
- 24 GB
Esegue modelli fino a 30–34B a 4 bit
I 24 GB sono divisi tra due chip (12 GB ciascuno), quindi i modelli più grandi vanno distribuiti su entrambi. Si consiglia di verificare che il modello desiderato disponga di una versione multi-chip funzionante.
1399 €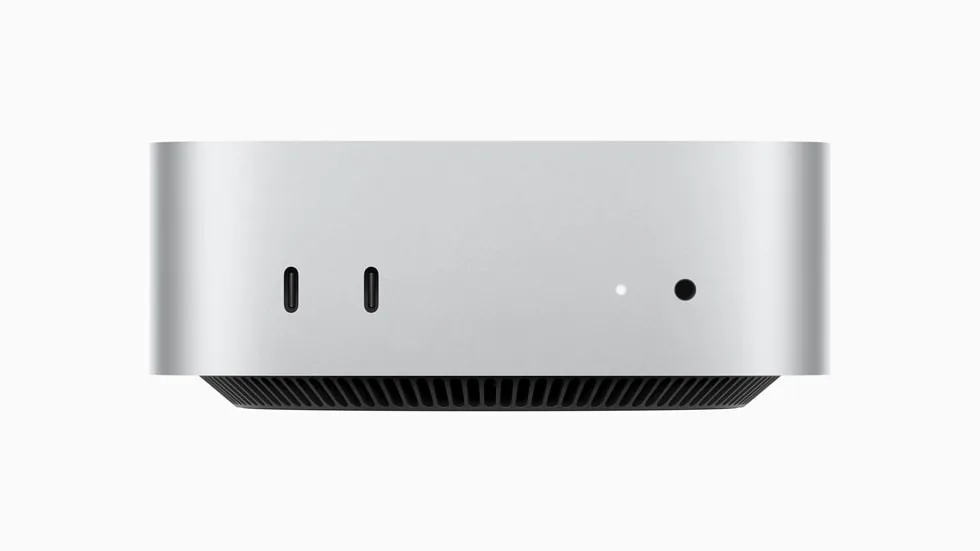
Apple
Apple Mac mini (M4 Pro)
- 24 GB unificati
- 16 core; opzione a 20 core
Esegue modelli fino a 13–14B a 4 bit
La memoria non è espandibile dopo l'acquisto. Se l'obiettivo è l'IA locale, conviene scegliere subito 48 GB o 64 GB. Con 24 GB, i modelli oltre circa 14B parametri ci stanno a fatica.
1399 €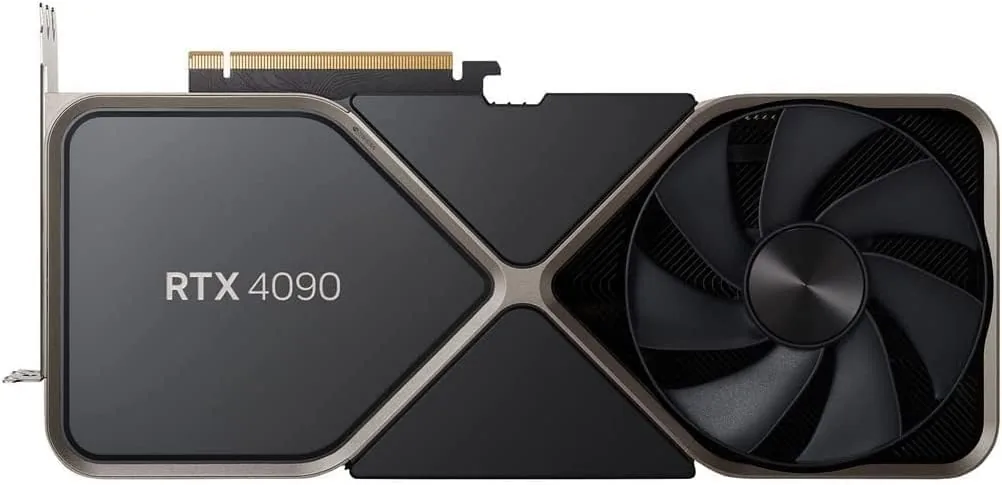
NVIDIA
NVIDIA GeForce RTX 4090
- 24 GB
- NVIDIA Ada Lovelace (AD102)
Esegue modelli fino a 30–34B a 4 bit
Inserire a fondo il cavo di alimentazione a 16 pin nella scheda ed evitare curve strette vicino al connettore. Un connettore non ben inserito è la causa più comune di problemi con questa scheda.
1599 €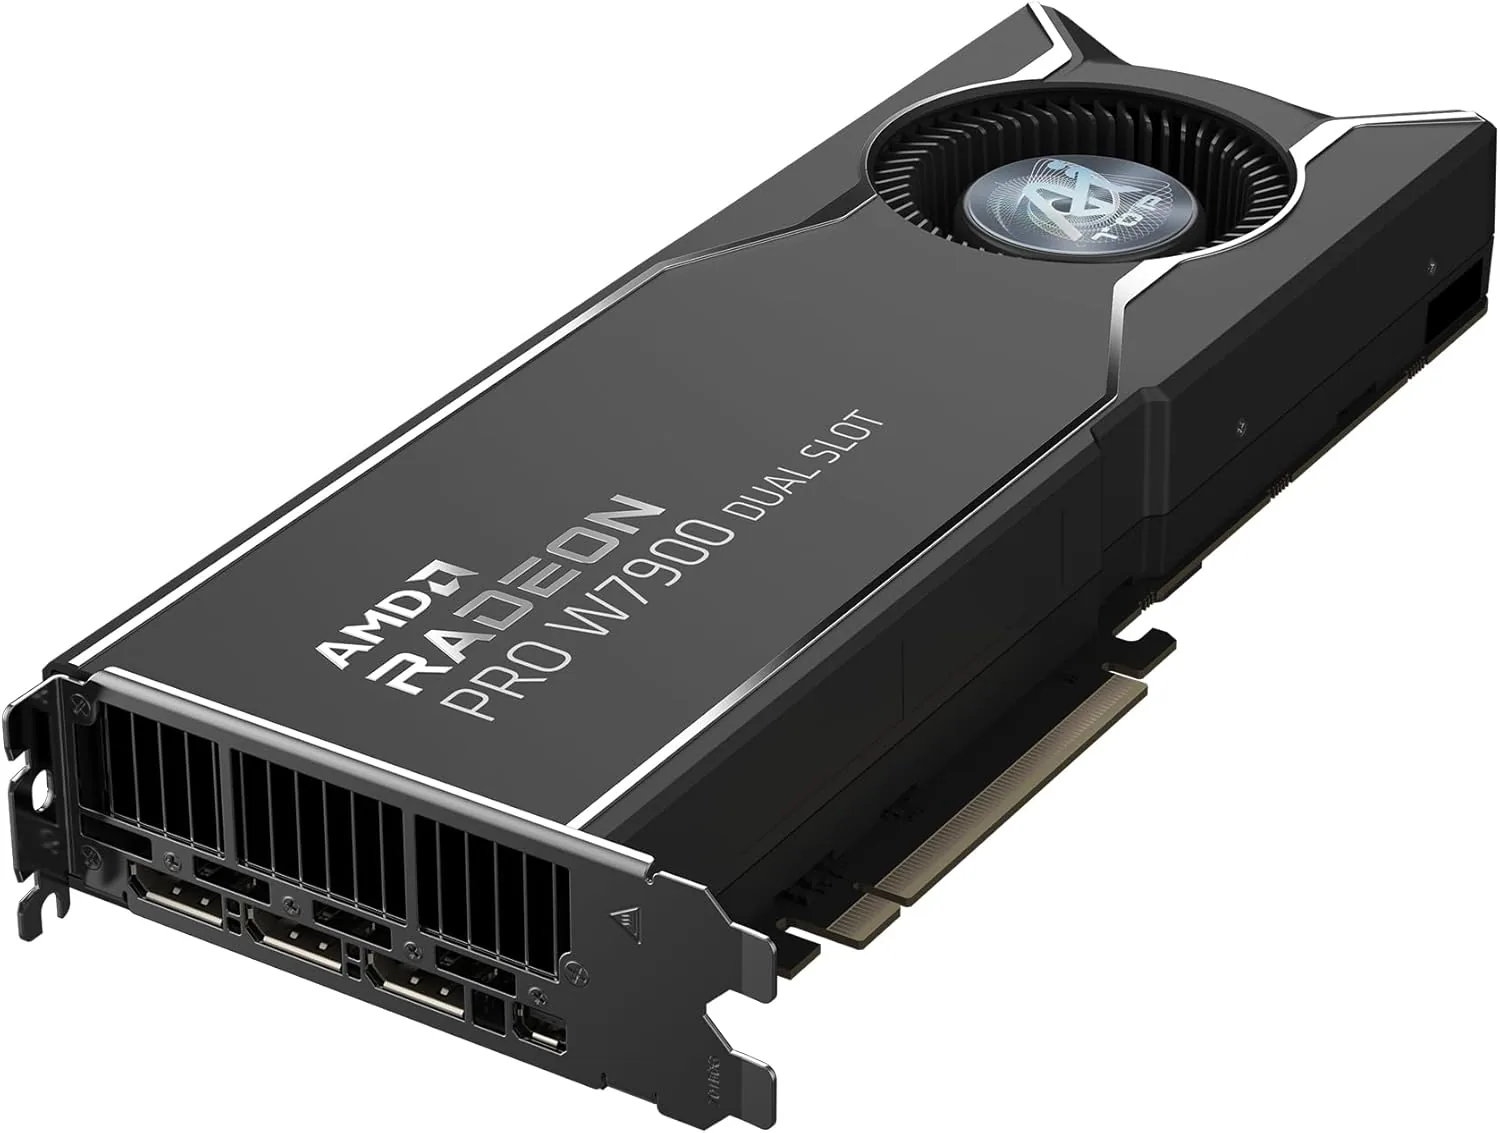
AMD
AMD Radeon PRO W7900 (48 GB)
- 48 GB
- AMD RDNA 3 (Navi 31)
Esegue modelli fino a 70B a 4 bit
La W7900 è la scelta giusta quando conta soprattutto la dimensione del modello o della scena. La più recente R9700 ha meno memoria (32 GB), ma aggiunge il supporto FP8 ed è più efficiente per watt nell'IA.
3592 €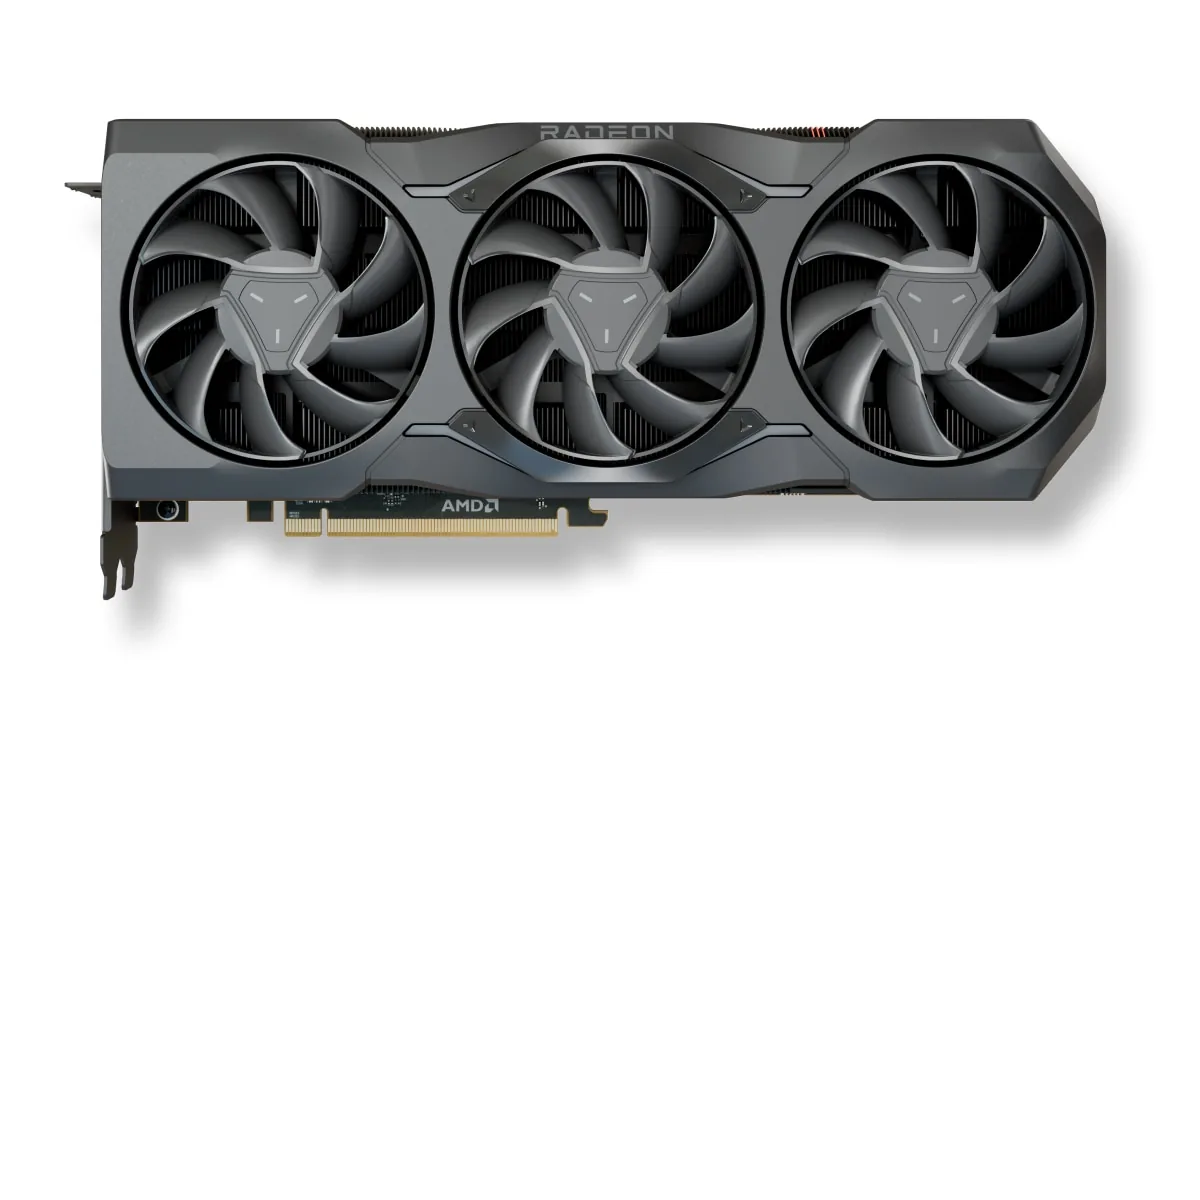
SAPPHIRE
SAPPHIRE PULSE AMD Radeon RX 7900 XTX 24GB
- 24 GB
- AMD RDNA 3 (Navi 31)
Esegue modelli fino a 30–34B a 4 bit
La PULSE è lunga 313 mm, occupa 2,7 slot e richiede tre connettori di alimentazione a 8 pin. Prima dell'ordine si consiglia di misurare il case e verificare l'alimentatore (minimo 800 W).
899 €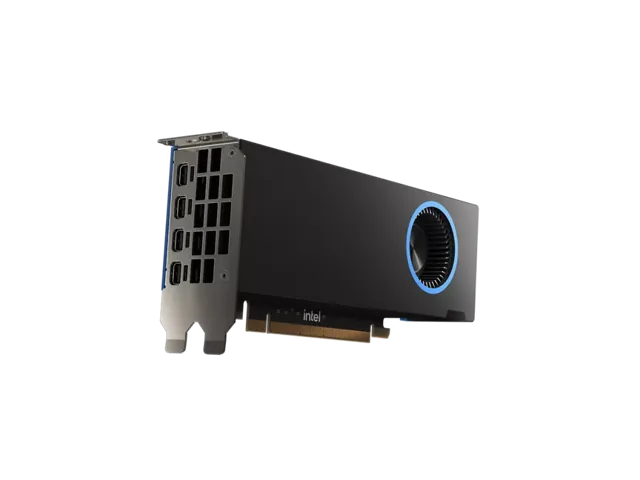
Intel
Intel Arc Pro B50
- 16 GB
- Intel Xe2 (Battlemage)
Esegue modelli fino a 13–14B a 4 bit
Non richiede cavi di alimentazione, quindi è adatta alle macchine small form factor. Con 16 GB esegue modelli da 7B a 14B a 4 bit; per modelli più grandi serve una scheda più capiente.
299 €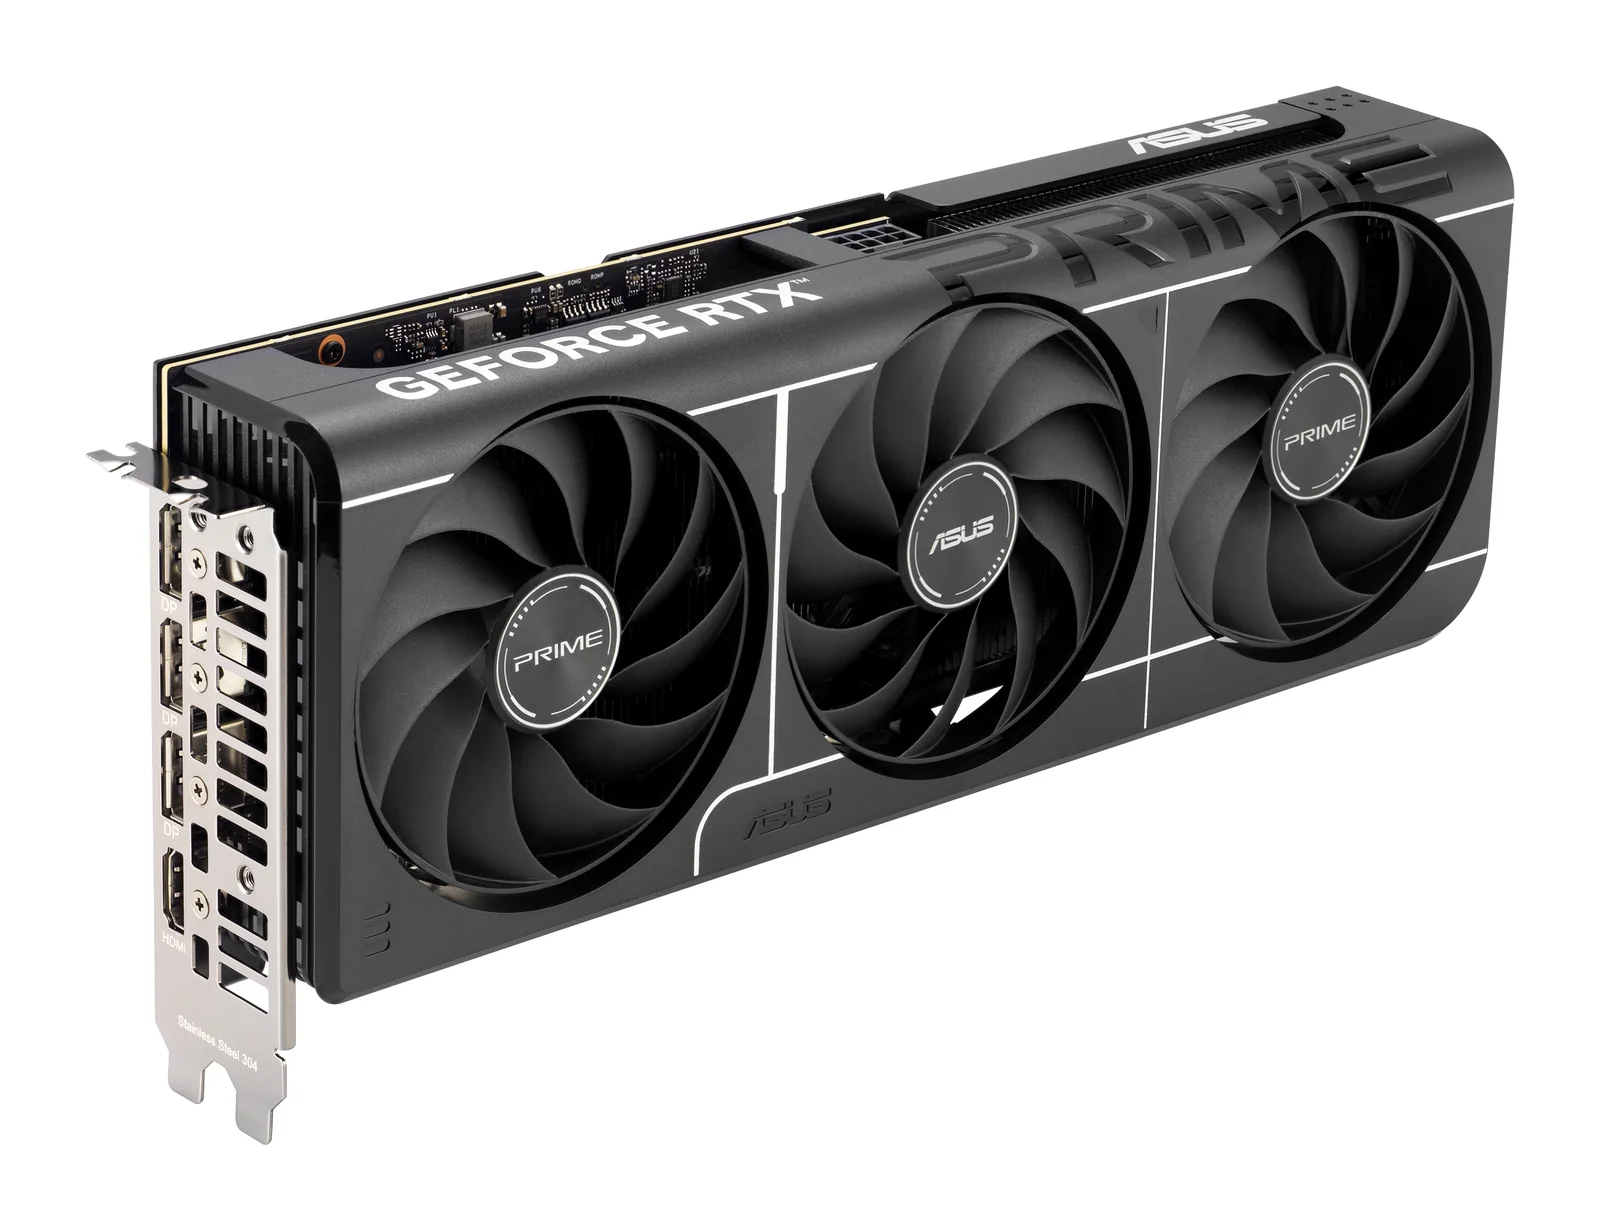
ASUS
ASUS Prime GeForce RTX 5060 Ti 16GB OC Edition
- 16 GB
- NVIDIA GeForce RTX 5060 Ti (Blackwell)
Esegue modelli fino a 13–14B a 4 bit
Per l'IA locale acquisti solo la versione da 16 GB: è questa. Il bus di memoria a 128 bit è più stretto rispetto alle schede di fascia superiore, quindi i modelli generano testo più lentamente che su una RTX 5070 Ti.
369 €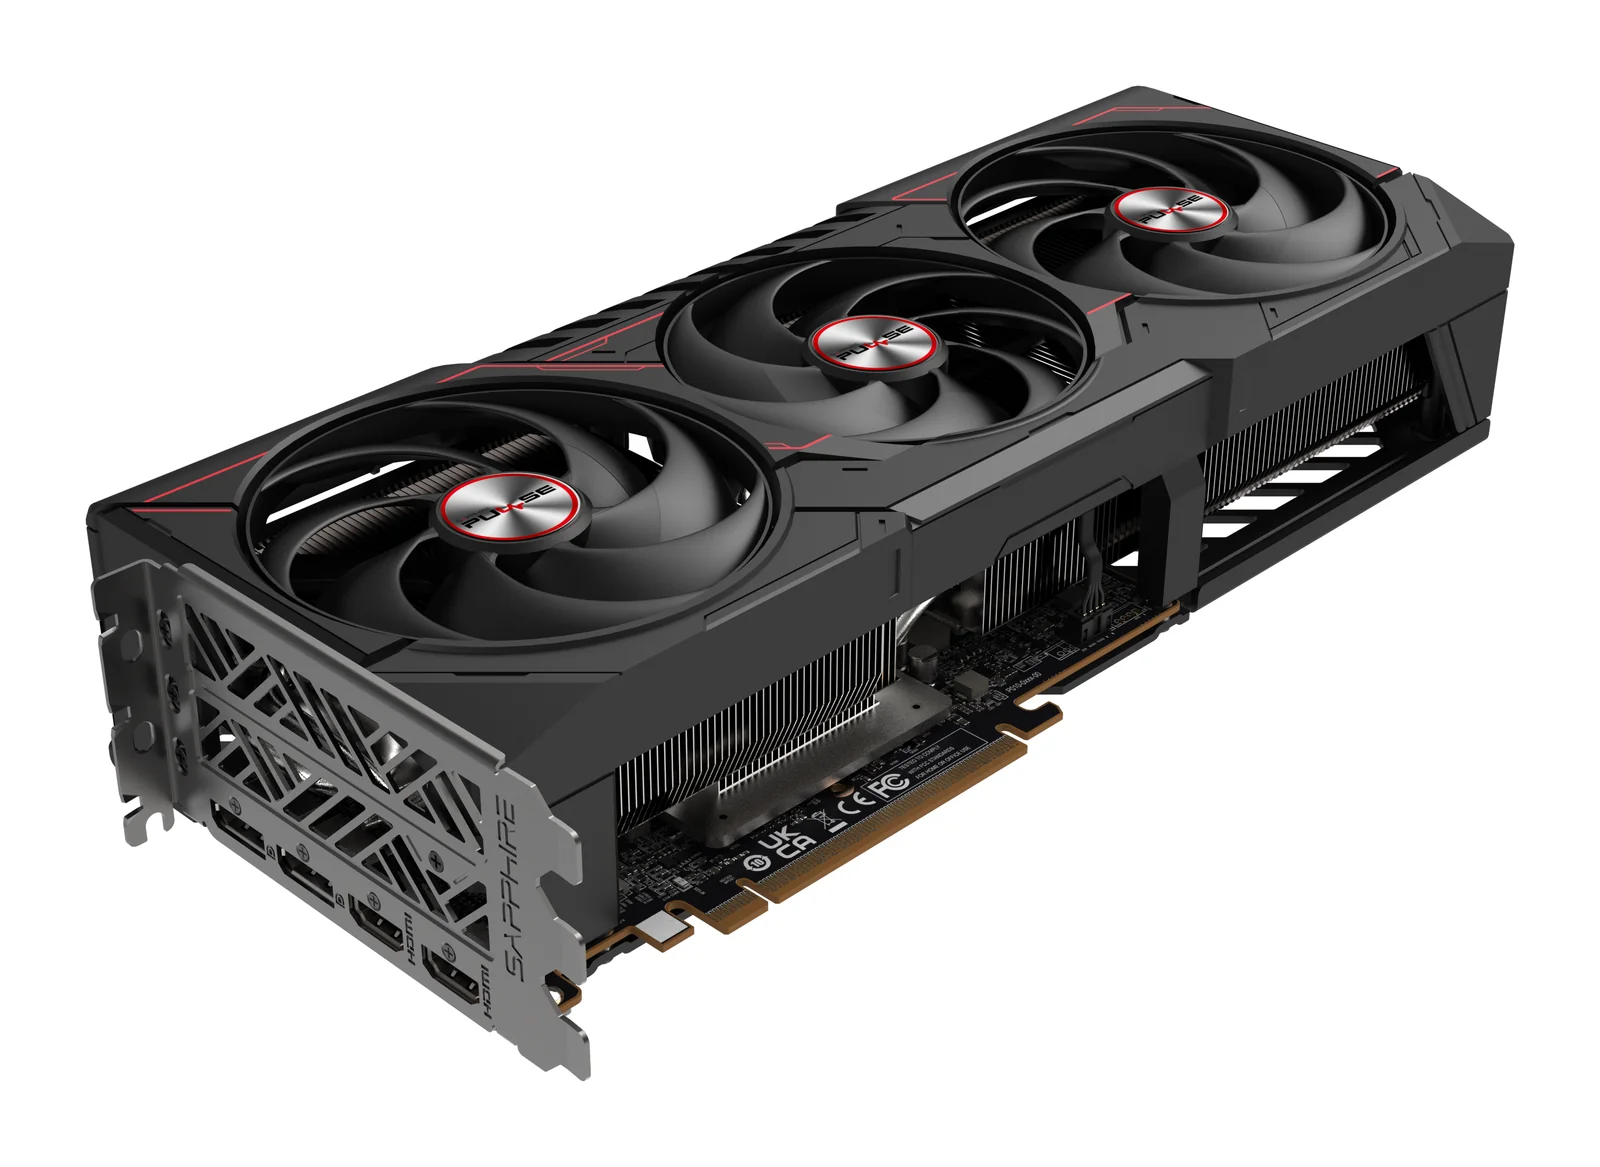
SAPPHIRE
SAPPHIRE PULSE AMD Radeon RX 9070 XT 16GB
- 16 GB
- AMD Radeon RX 9070 XT (RDNA 4)
Esegue modelli fino a 13–14B a 4 bit
La scheda è lunga 320 mm, occupa tre slot e richiede due cavi di alimentazione a 8 pin. SAPPHIRE indica un alimentatore da almeno 750 W: si consiglia di misurare prima il case.
519 €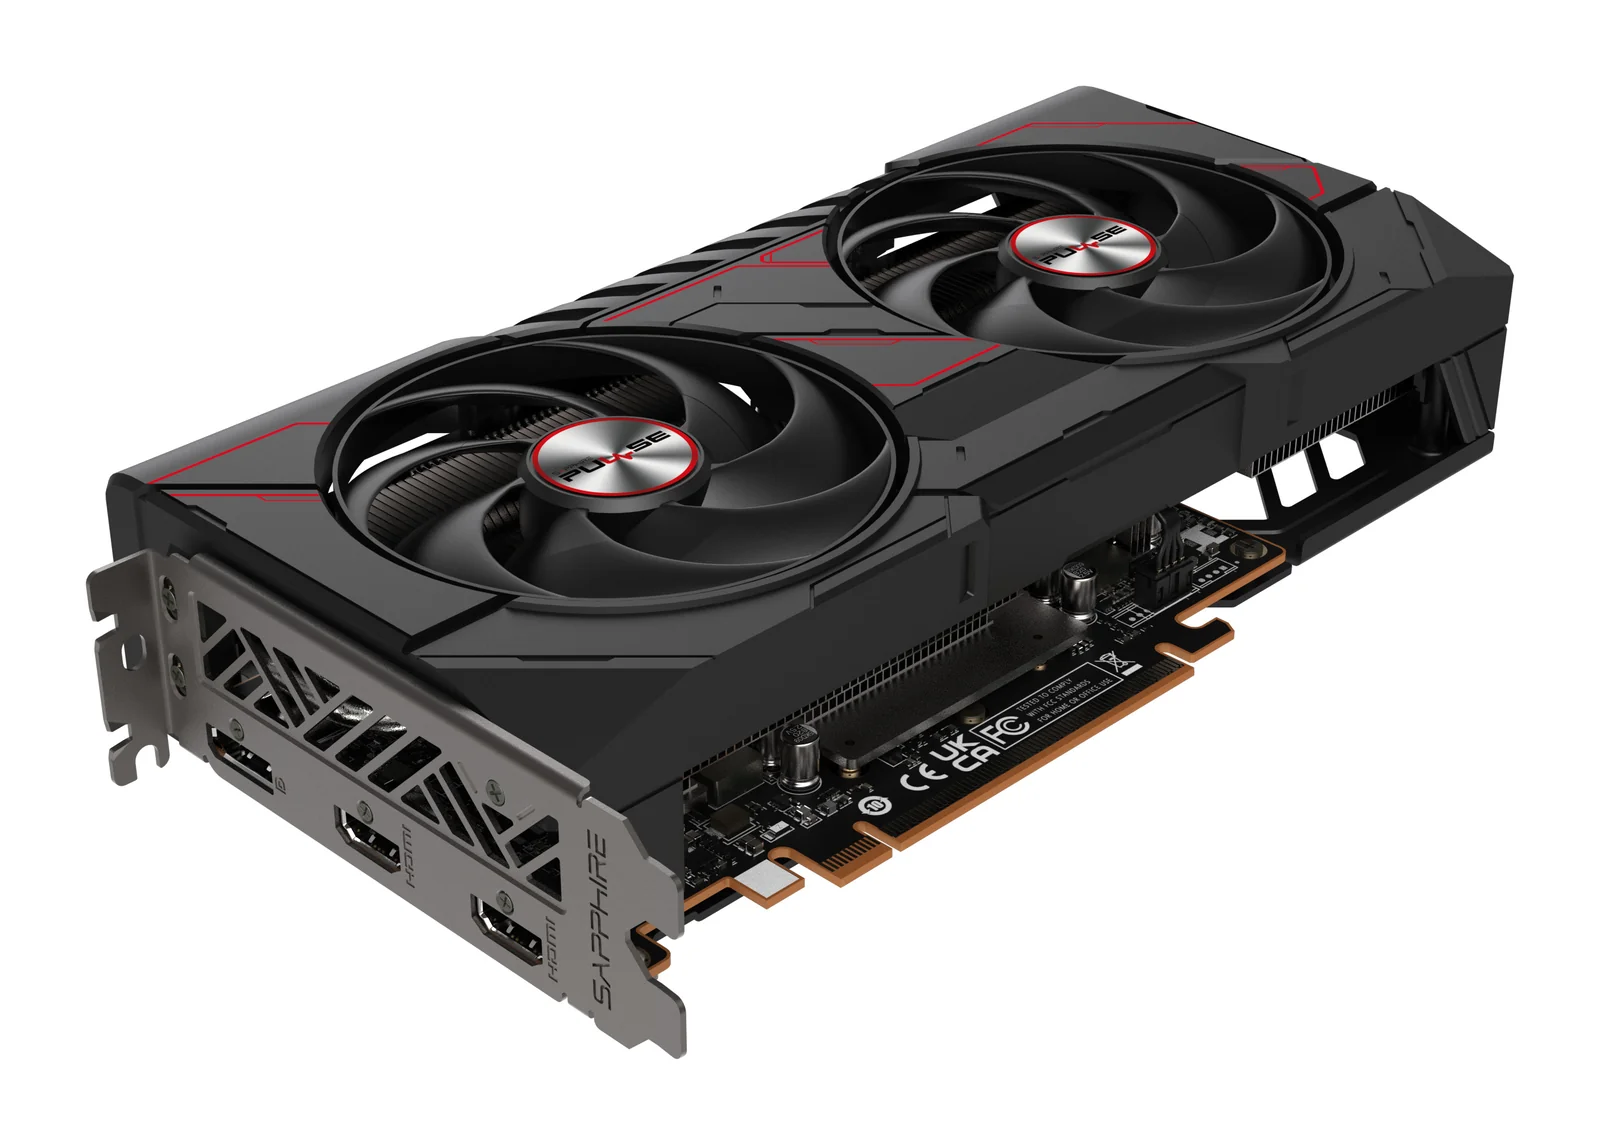
SAPPHIRE
SAPPHIRE PULSE AMD Radeon RX 9060 XT 16GB
- 16 GB
- AMD Radeon RX 9060 XT (RDNA 4)
Esegue modelli fino a 13–14B a 4 bit
Questa è la versione da 16 GB; la versione da 8 GB è una scheda diversa e nei giochi nuovi ha già poca memoria. Bastano un cavo a 8 pin e un alimentatore da 450 W.
299 €Come scegliere l'hardware per l'IA locale
- Contare la memoria utilizzabile, non quella dichiarata
- La nostra guida ai modelli considera utilizzabile il 90% della memoria di una scheda video e il 75% della memoria unificata, perché il sistema operativo riserva per sé una parte della memoria condivisa. Un Mac da 64 GB lascia ai modelli circa 48 GB; una scheda da 48 GB circa 43 GB.
- Scegliere la memoria in base al modello
- Fino a 14B a 4 bit: una scheda da 16 GB o un Mac mini da 24 GB. Classe 30B a 4 bit: una scheda da 24 GB o 32 GB. 70B a 4 bit: una scheda da 48 GB, due schede da 24 GB o almeno 64 GB di memoria unificata. 70B a 8 bit e classe 120B a 4 bit: una scheda da 96 GB o una macchina con 128 GB di memoria unificata.
- Scegliere la piattaforma richiesta dai propri strumenti
- NVIDIA se gli strumenti richiedono CUDA o se si usa il PC anche per giocare. Un Mac Studio per modelli grandi in un computer quasi silenzioso. Un mini PC Ryzen AI Max+ per avere 128 GB su Windows o Linux. Il DGX Spark se si sviluppa su CUDA per poi passare in produzione su sistemi NVIDIA più grandi.
- Se il modello entra in memoria, la velocità dipende dalla banda
- Ogni nuovo token richiede la lettura dei pesi, quindi un modello genera testo più velocemente su una macchina con più banda di memoria: 1.792 GB/s sulla RTX 5090, 819 GB/s sul Mac Studio, 273 GB/s sul Mac mini M4 Pro e sul DGX Spark.
- Quando basta una macchina più economica
- Chat, riassunti, completamento del codice e ricerca nei propri documenti funzionano tutti con modelli da 7B a 14B, che stanno in 16 GB. Per questo bastano la Arc Pro B50 o un Mac mini da 24 GB. Con documenti lunghi conviene lasciare un margine di memoria.
Domande frequenti
Posso far girare un modello 70B su una sola scheda video?
Solo su una scheda con almeno 48 GB. La Radeon PRO W7900 (48 GB) lo contiene al limite a 4 bit, mentre la RTX PRO 6000 (96 GB) lo contiene a 8 bit. Una scheda da 32 GB come la RTX 5090 non basta.
Cosa significano 4 bit e 8 bit per l'hardware che mi serve?
A 4 bit il modello occupa circa metà della memoria richiesta a 8 bit, con una lieve perdita di qualità, ed è il modo in cui la maggior parte delle persone usa i modelli a casa. A 8 bit si conserva più qualità ma serve circa il doppio della memoria, e ne vale la pena per la programmazione o l'estrazione precisa di dati.
Quanta memoria in più serve per conversazioni e documenti lunghi?
La memoria di contesto cresce con ogni token che il modello tiene presente, quindi conviene prevedere più memoria di quanta ne occupi il modello stesso. Meglio scegliere il taglio di memoria superiore piuttosto che uno appena sufficiente per il modello.
L'hardware per l'IA locale è adatto al fine-tuning?
Il fine-tuning richiede più memoria rispetto all'esecuzione di un modello. Metodi parameter-efficient come LoRA riducono drasticamente questa esigenza; per il lavoro basato su CUDA, il DGX Spark da 128 GB offre margine per dimensioni irraggiungibili con una scheda da 32 GB.
Potete configurare una macchina per i modelli che voglio usare?
Sì. Invii una richiesta di configurazione su misura indicando i modelli che intende usare, il budget e il paese: risponderemo con una configurazione e un preventivo.
Pagine correlate: Schede video · Mini PC · Apple · Acceleratori IA
Guide
IA locale · 5 min di lettura
Quanta memoria serve per eseguire un LLM in locale?
Quanta memoria serve a un LLM locale: modelli da 7B a 120B+ a 4 e 8 bit, differenze tra memoria unificata e VRAM e quali macchine reggono ogni dimensione.
Leggi la guida →IA locale · 5 min di lettura
Mac, NVIDIA o Ryzen AI Max+ per l'IA locale
Mac, NVIDIA o Ryzen AI Max+: CUDA su NVIDIA, memoria unificata su Mac o 128 GB su un mini PC. Quale piattaforma per quale lavoro e con quali compromessi.
Leggi la guida →Schede video · 5 min di lettura
Scegliere una GPU per l'IA locale: RTX 5090, R9700, B60
Come scegliere una GPU per l'IA locale in base a memoria, software e banda: RTX 5090, Radeon AI PRO R9700, Arc Pro B60 e schede workstation da 48 e 96 GB.
Leggi la guida →