Comprar por uso
Hardware para LLM locales: qué equipo ejecuta cada modelo
Hardware para LLM locales y modelos de imagen: ejecútelos de forma privada, sin conexión y sin cuota mensual.
Consejo de compra: La memoria determina qué modelos caben. La velocidad viene después. Compruebe primero el tamaño del modelo y elija luego el equipo.
La memoria determina qué modelos puede ejecutar; la velocidad va después. Un modelo de 7–8B a 4 bits ocupa unos 6 GB, uno de 70B unos 42 GB y uno de clase 120B unos 80 GB, así que parta del modelo más grande que quiera usar y elija un equipo con suficiente memoria utilizable. Después, elija la plataforma de software: CUDA en NVIDIA, Metal y MLX en Mac, o ROCm y Vulkan en AMD.
Nuestra selección
Modelos de 70B y clase 120B en un equipo compacto
Ryzen AI Max+ 395
Beelink
Beelink GTR9 Pro
- 128 GB unificados
- AMD Ryzen AI Max+ 395
Ejecuta modelos de hasta 120B+ a 4 bits
En Windows se pueden asignar a la GPU hasta 96 GB de los 128 GB. Antes de comprar, compruebe que el modelo que quiere ejecutar cabe en esa cantidad.
4349 €128 GB de memoria unificada, unos 96 GB para modelos, con Windows o Linux; si quiere asignar a la GPU la mayor cantidad de memoria, opte por Linux.
La máxima velocidad en modelos de hasta 30B
GeForce RTX 5090
NVIDIA
NVIDIA GeForce RTX 5090
- 32 GB
- NVIDIA Blackwell (GB202)
Ejecuta modelos de hasta 30–34B a 4 bits
Con 32 GB se ejecutan con holgura modelos de la clase 30B a 4 bits, pero un modelo de 70B no cabe en una sola tarjeta. Para 70B, cuente con dos tarjetas o con un sistema de memoria unificada de gran capacidad.
1999 €32 GB de GDDR7 a 1.792 GB/s con CUDA. Un modelo de 70B no cabe en una sola tarjeta.
Modelos grandes, casi en silencio
Mac Studio M3 Ultra
Apple
Apple Mac Studio (M3 Ultra)
- 96 GB unificados
- 60 núcleos; opción de 80 núcleos
Ejecuta modelos de hasta 70B a 4 bits
macOS reserva parte de la memoria unificada para el sistema, así que cuente con que la GPU usará la mayor parte, no toda. Elija una configuración con cierto margen por encima del modelo.
3999 €96 GB de serie y 819 GB/s: un modelo de 70B a 4 bits se ejecuta con rapidez mientras el equipo se mantiene casi en silencio.
NVIDIA
NVIDIA GeForce RTX 5090
- 32 GB
- NVIDIA Blackwell (GB202)
Ejecuta modelos de hasta 30–34B a 4 bits
Con 32 GB se ejecutan con holgura modelos de la clase 30B a 4 bits, pero un modelo de 70B no cabe en una sola tarjeta. Para 70B, cuente con dos tarjetas o con un sistema de memoria unificada de gran capacidad.
1999 €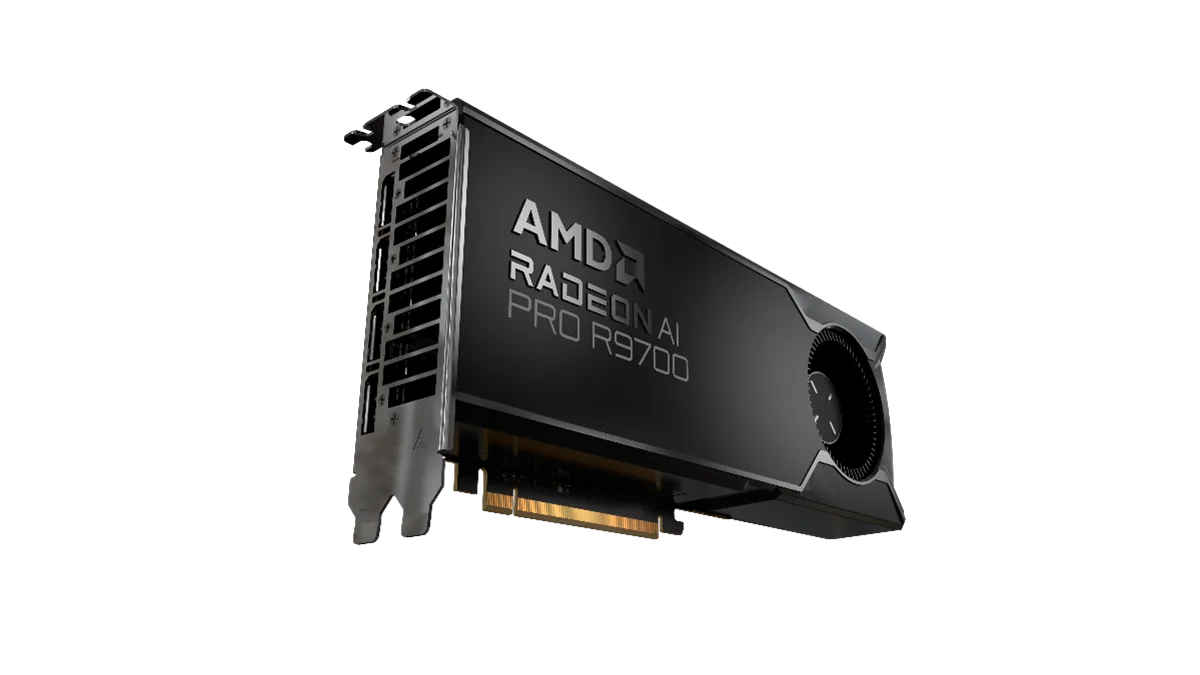
PowerColor
PowerColor AMD Radeon AI PRO R9700 32GB
- 32 GB
- AMD RDNA 4 (Navi 48)
Ejecuta modelos de hasta 30–34B a 4 bits
Antes de comprar, compruebe que sus herramientas son compatibles con ROCm en su sistema operativo. PyTorch y llama.cpp lo son; algunas herramientas minoritarias todavía dan por hecho CUDA.
1299 €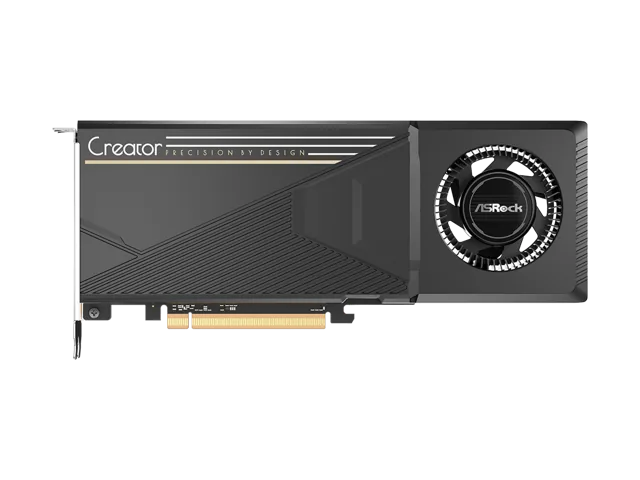
ASRock
ASRock Intel Arc Pro B60 Creator 24GB
- 24 GB
- Intel Xe2 (Battlemage)
Ejecuta modelos de hasta 30–34B a 4 bits
Es una tarjeta con una sola GPU y 24 GB. Usa una ranura PCIe 5.0 cableada a x8 y también funciona en ranuras PCIe 4.0. Antes de hacer el pedido, consulte la ficha técnica de ASRock para comprobar la longitud exacta y el conector de alimentación.
599,99 €Beelink
Beelink GTR9 Pro
- 128 GB unificados
- AMD Ryzen AI Max+ 395
Ejecuta modelos de hasta 120B+ a 4 bits
En Windows se pueden asignar a la GPU hasta 96 GB de los 128 GB. Antes de comprar, compruebe que el modelo que quiere ejecutar cabe en esa cantidad.
4349 €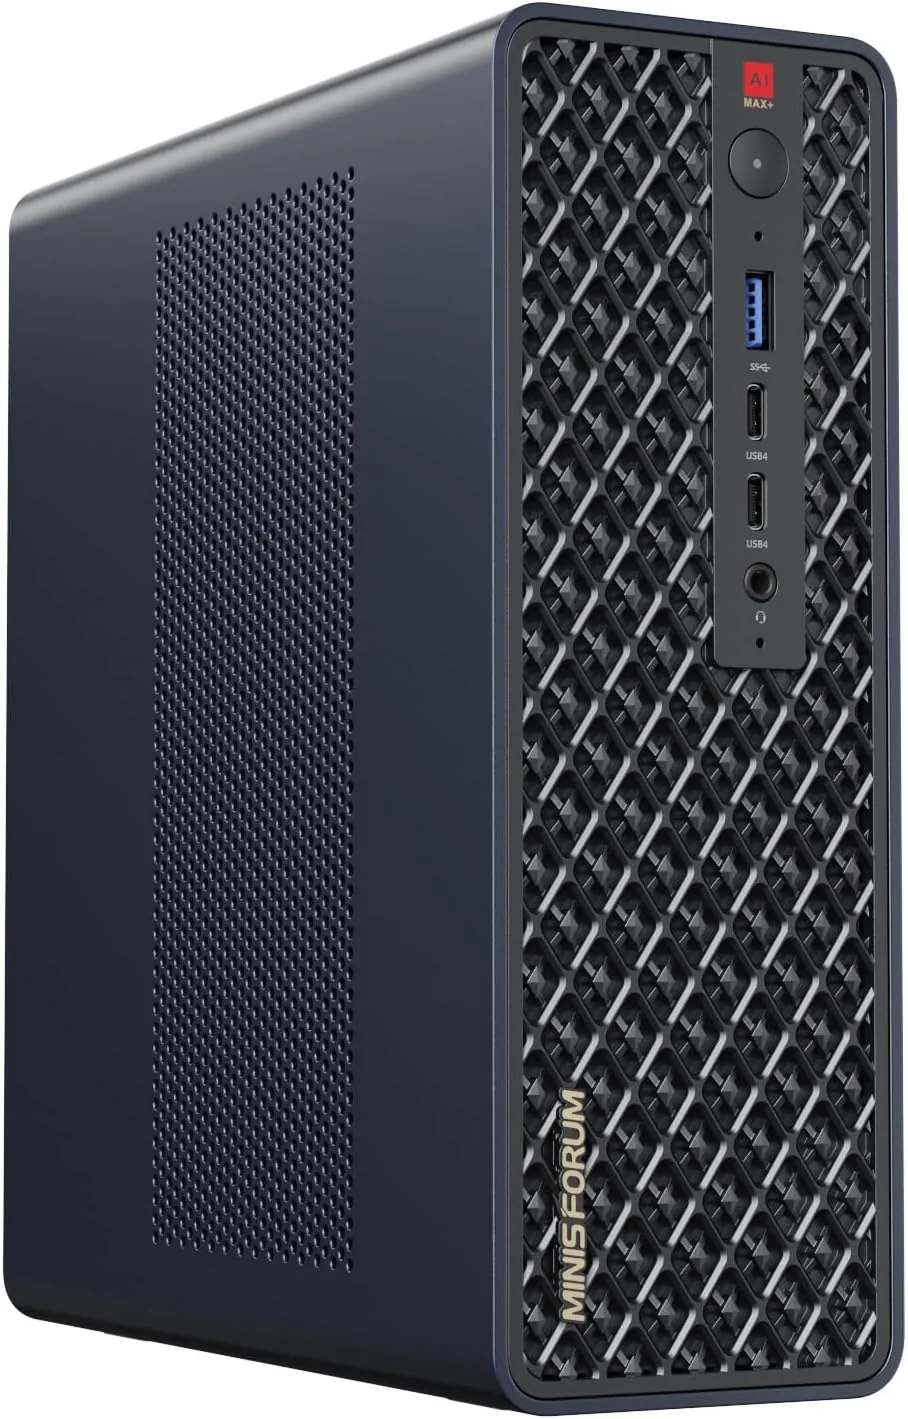
Minisforum
Minisforum MS-S1 Max
- 128 GB unificados
- AMD Ryzen AI Max+ 395
Ejecuta modelos de hasta 120B+ a 4 bits
La ranura PCIe admite tarjetas de perfil bajo y funciona con x4 líneas. Es ideal para una tarjeta de red más rápida, no para añadir una tarjeta gráfica de tamaño completo.
2469 €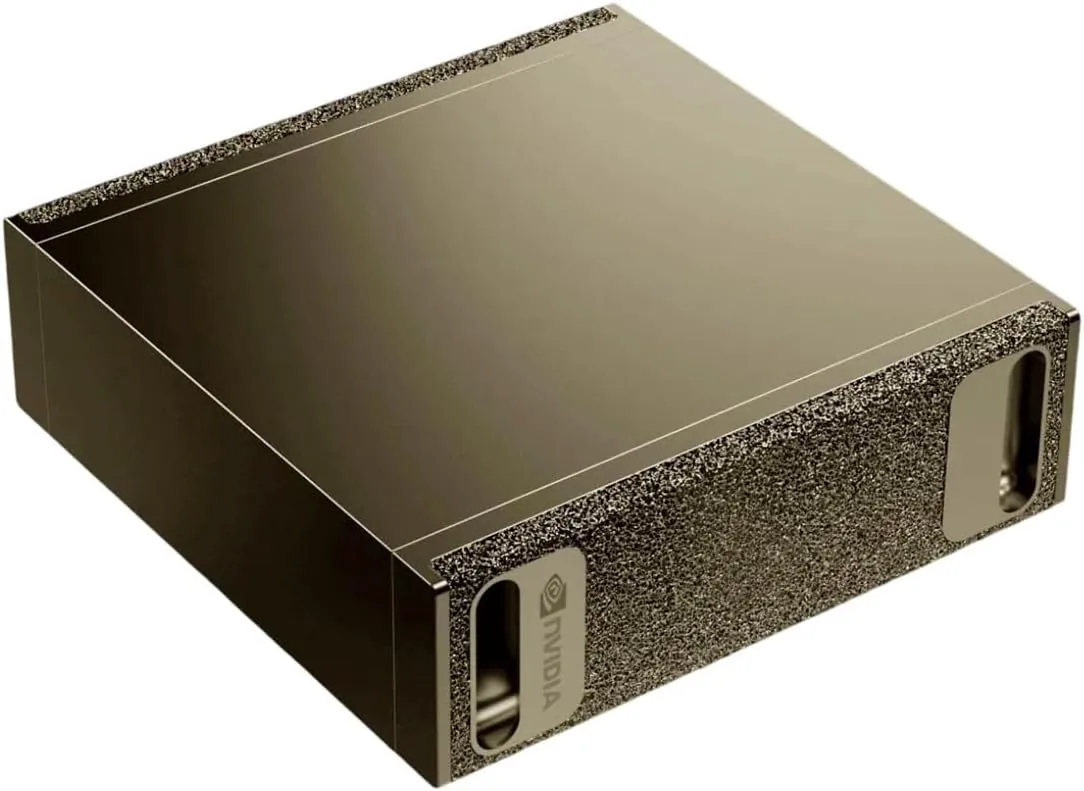
NVIDIA
NVIDIA DGX Spark
- 128 GB unificados
- NVIDIA GB10 Grace Blackwell
Ejecuta modelos de hasta 120B+ a 4 bits
Su ancho de banda de memoria (273 GB/s) es inferior al de una tarjeta gráfica de gama alta, así que los modelos densos grandes generan texto más despacio que en una RTX 5090. Sus puntos fuertes son la capacidad y el stack de software CUDA.
4699 €Apple
Apple Mac Studio (M3 Ultra)
- 96 GB unificados
- 60 núcleos; opción de 80 núcleos
Ejecuta modelos de hasta 70B a 4 bits
macOS reserva parte de la memoria unificada para el sistema, así que cuente con que la GPU usará la mayor parte, no toda. Elija una configuración con cierto margen por encima del modelo.
3999 €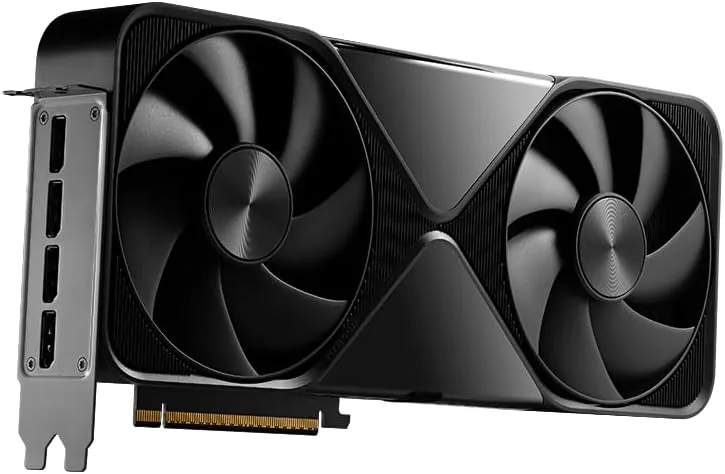
NVIDIA
NVIDIA RTX PRO 6000 Blackwell Workstation Edition (96 GB)
- 96 GB
- NVIDIA Blackwell (GB202)
Ejecuta modelos de hasta 120B+ a 4 bits
Esta es la Workstation Edition de 600 W con refrigeración de doble flujo pasante. Necesita un cable de alimentación de 16 pines, una caja con espacio para una tarjeta de 12 pulgadas y una buena circulación de aire.
13.250 €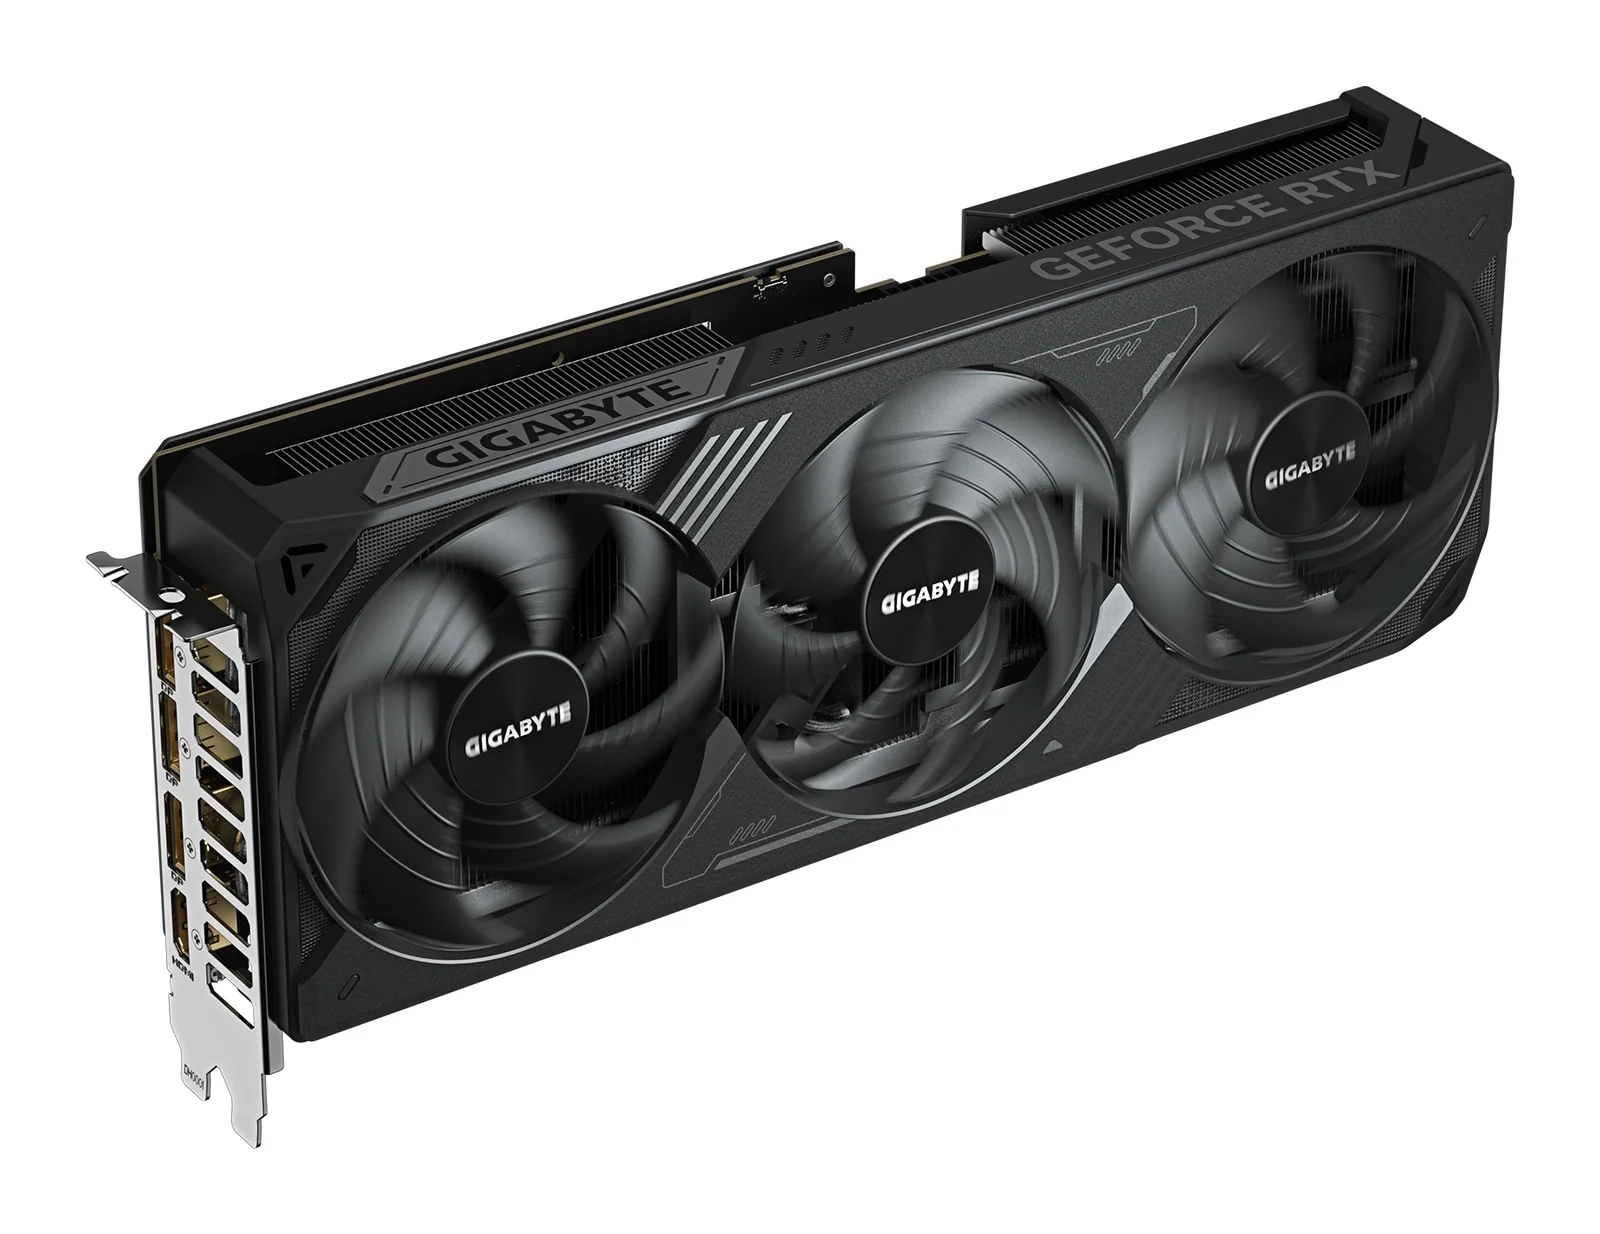
GIGABYTE
GIGABYTE GeForce RTX 5070 Ti WINDFORCE OC SFF 16G
- 16 GB
- NVIDIA GeForce RTX 5070 Ti (Blackwell)
Ejecuta modelos de hasta 13–14B a 4 bits
Necesita un cable de alimentación de 16 pines o el adaptador incluido, que usa dos cables PCIe de 8 pines. GIGABYTE recomienda una fuente de alimentación de 750 W.
849 €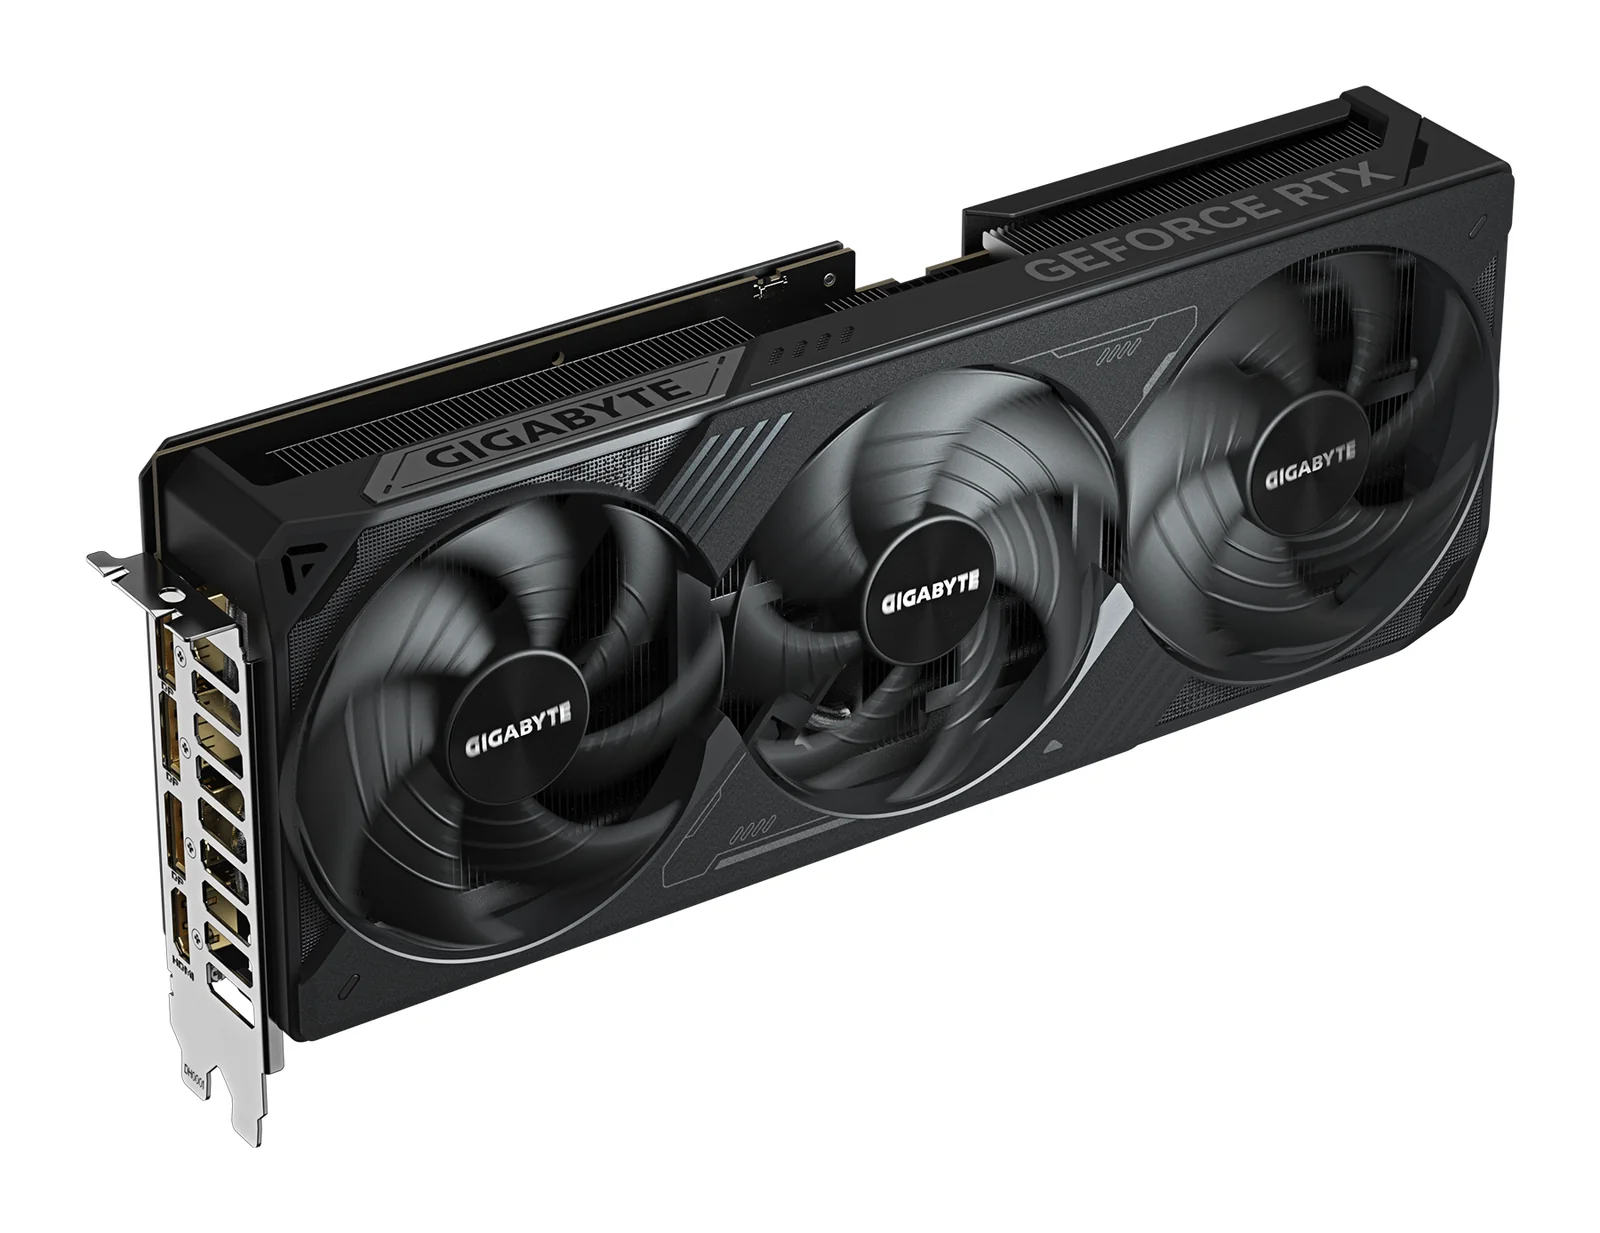
GIGABYTE
GIGABYTE GeForce RTX 5080 WINDFORCE OC SFF 16G
- 16 GB
- NVIDIA GeForce RTX 5080 (Blackwell)
Ejecuta modelos de hasta 13–14B a 4 bits
Tiene los mismos 16 GB que la RTX 5070 Ti, así que no admite modelos de IA más grandes; los ejecuta más rápido. Si necesita más memoria en una sola tarjeta, consulte la RTX 5090 o una tarjeta de 24 a 32 GB.
1079 €
Lenovo
Lenovo Legion Tower 5 Gen 10 (RTX 5070 Ti)
- 32 GB
- AMD Ryzen 7 7800X3D (8 núcleos / 16 hilos, 4,2 / 5,0 GHz, 96 MB L3)
La memoria del sistema son dos módulos de 16 GB y Lenovo indica 32 GB como máximo para esta torre, así que cuente con 32 GB durante toda su vida útil. El almacenamiento sí puede crecer: tres ranuras M.2 y una bahía de 3,5 pulgadas.
2159 €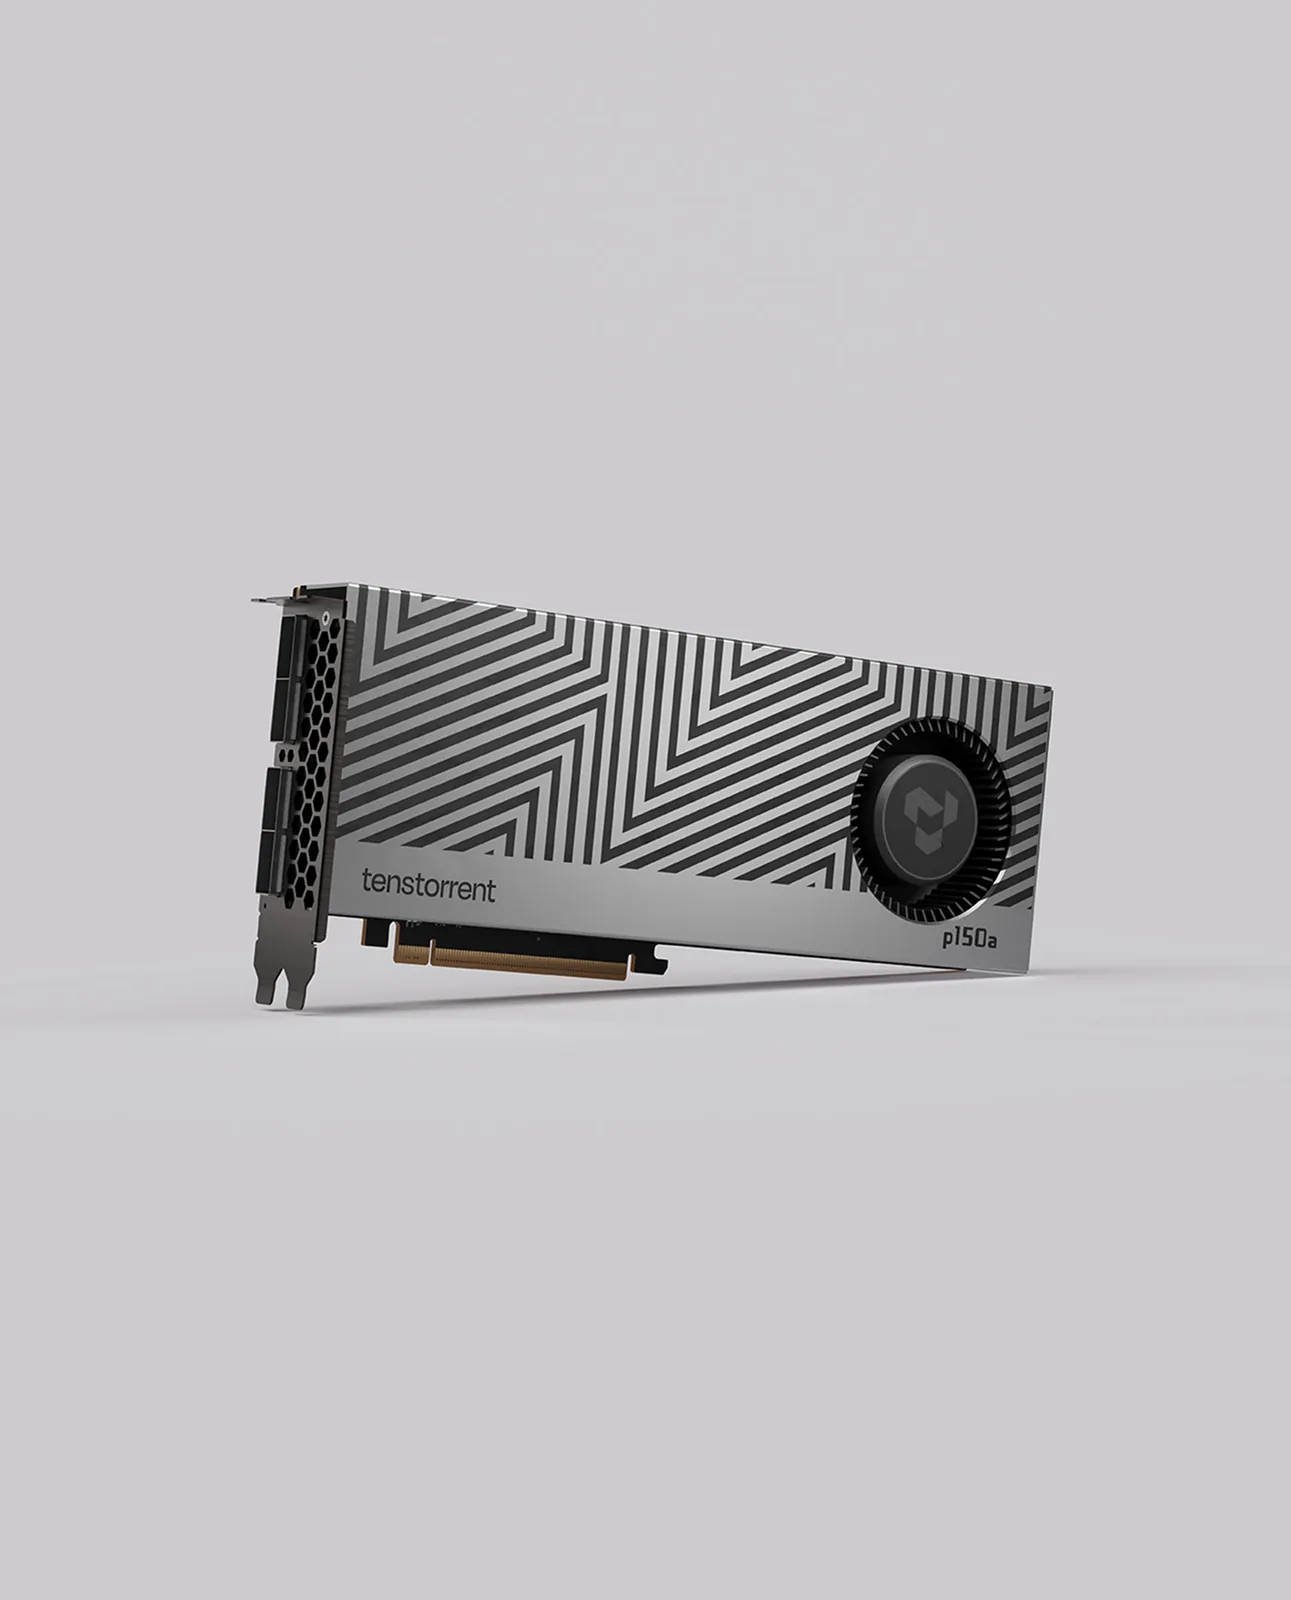
Tenstorrent
Tenstorrent Blackhole p150a
- 32 GB
- Tenstorrent Blackhole
Ejecuta modelos de hasta 30–34B a 4 bits
No es una tarjeta CUDA. Antes de comprarla, compruebe que los modelos que necesita son compatibles con la biblioteca de modelos de código abierto de Tenstorrent.
1399 €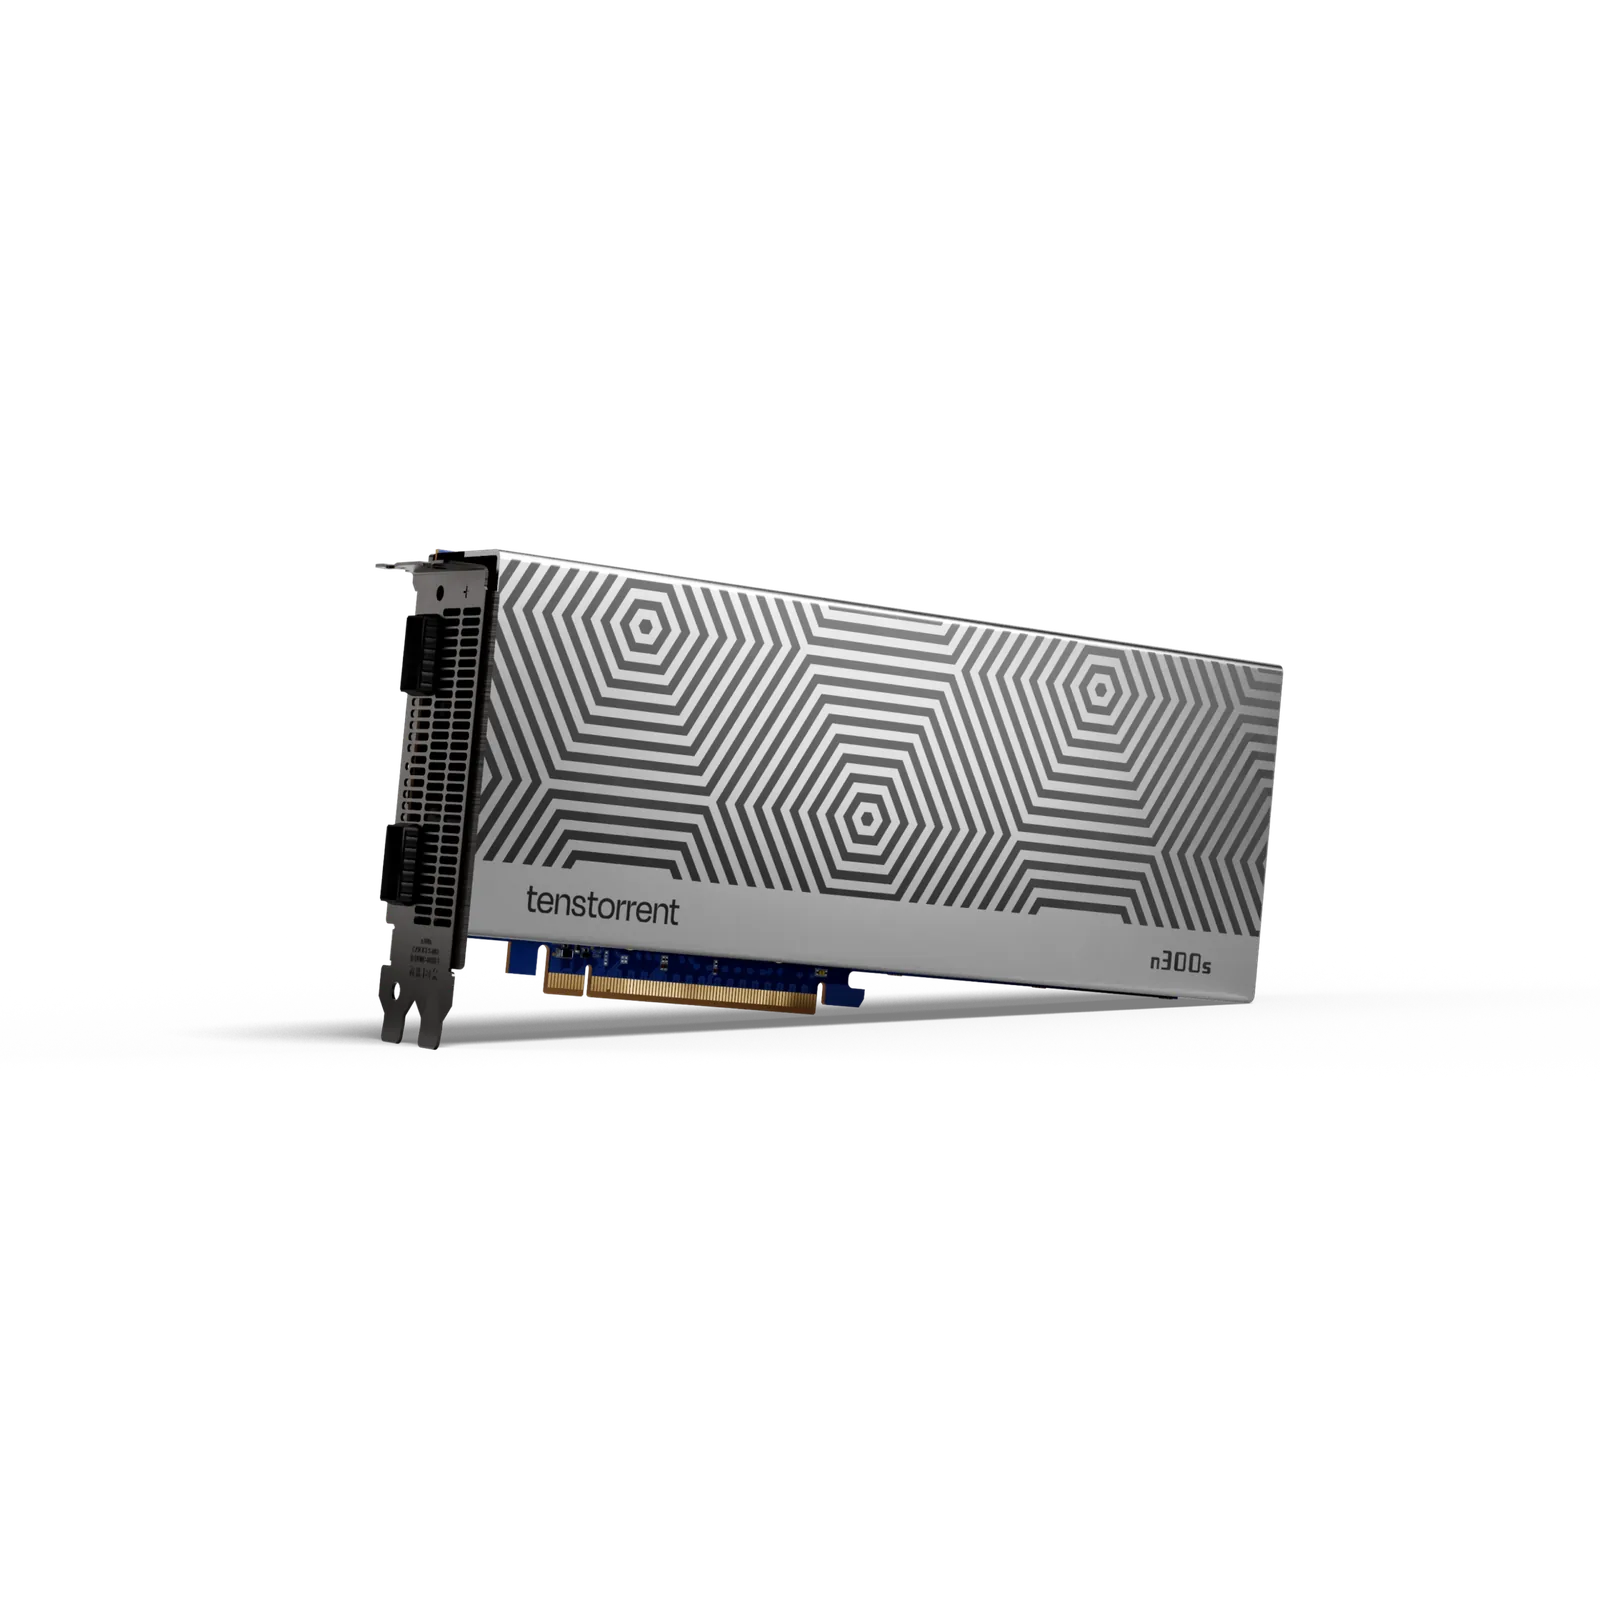
Tenstorrent
Tenstorrent Wormhole n300s
- 24 GB
Ejecuta modelos de hasta 30–34B a 4 bits
Los 24 GB se reparten entre dos chips (12 GB cada uno), por lo que los modelos grandes deben distribuirse entre ambos. Compruebe que el modelo que quiere tiene una versión multichip funcional.
1399 €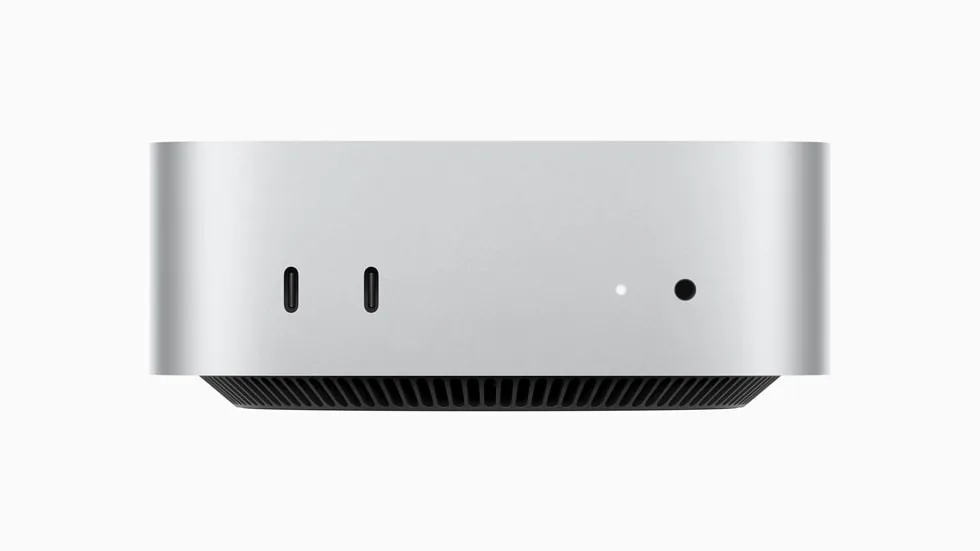
Apple
Apple Mac mini (M4 Pro)
- 24 GB unificados
- 16 núcleos; opción de 20 núcleos
Ejecuta modelos de hasta 13–14B a 4 bits
La memoria no se puede ampliar después de la compra. Si el objetivo es la IA local, elija ahora 48 GB o 64 GB. Con 24 GB, los modelos de más de unos 14B parámetros van muy justos.
1399 €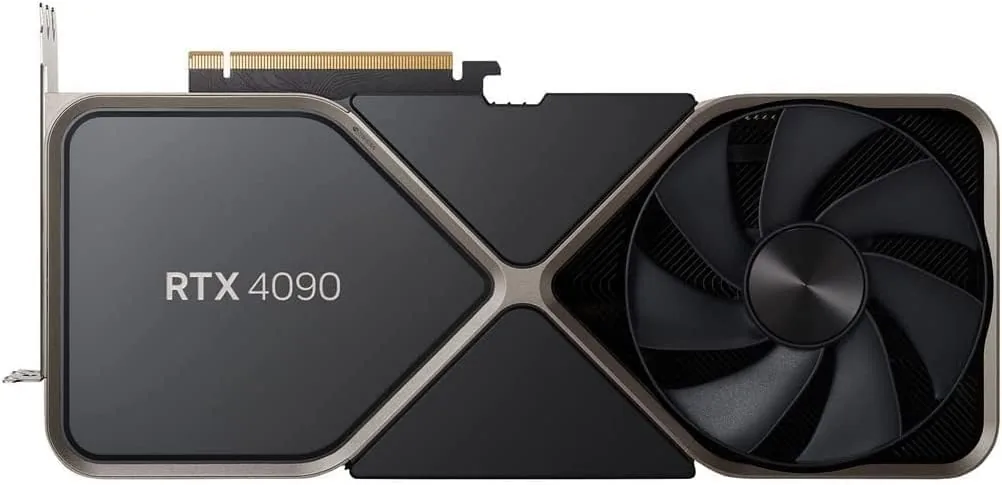
NVIDIA
NVIDIA GeForce RTX 4090
- 24 GB
- NVIDIA Ada Lovelace (AD102)
Ejecuta modelos de hasta 30–34B a 4 bits
Inserte el cable de alimentación de 16 pines hasta el fondo y evite curvas pronunciadas cerca del conector. Un conector mal encajado es la causa de problemas más habitual con esta tarjeta.
1599 €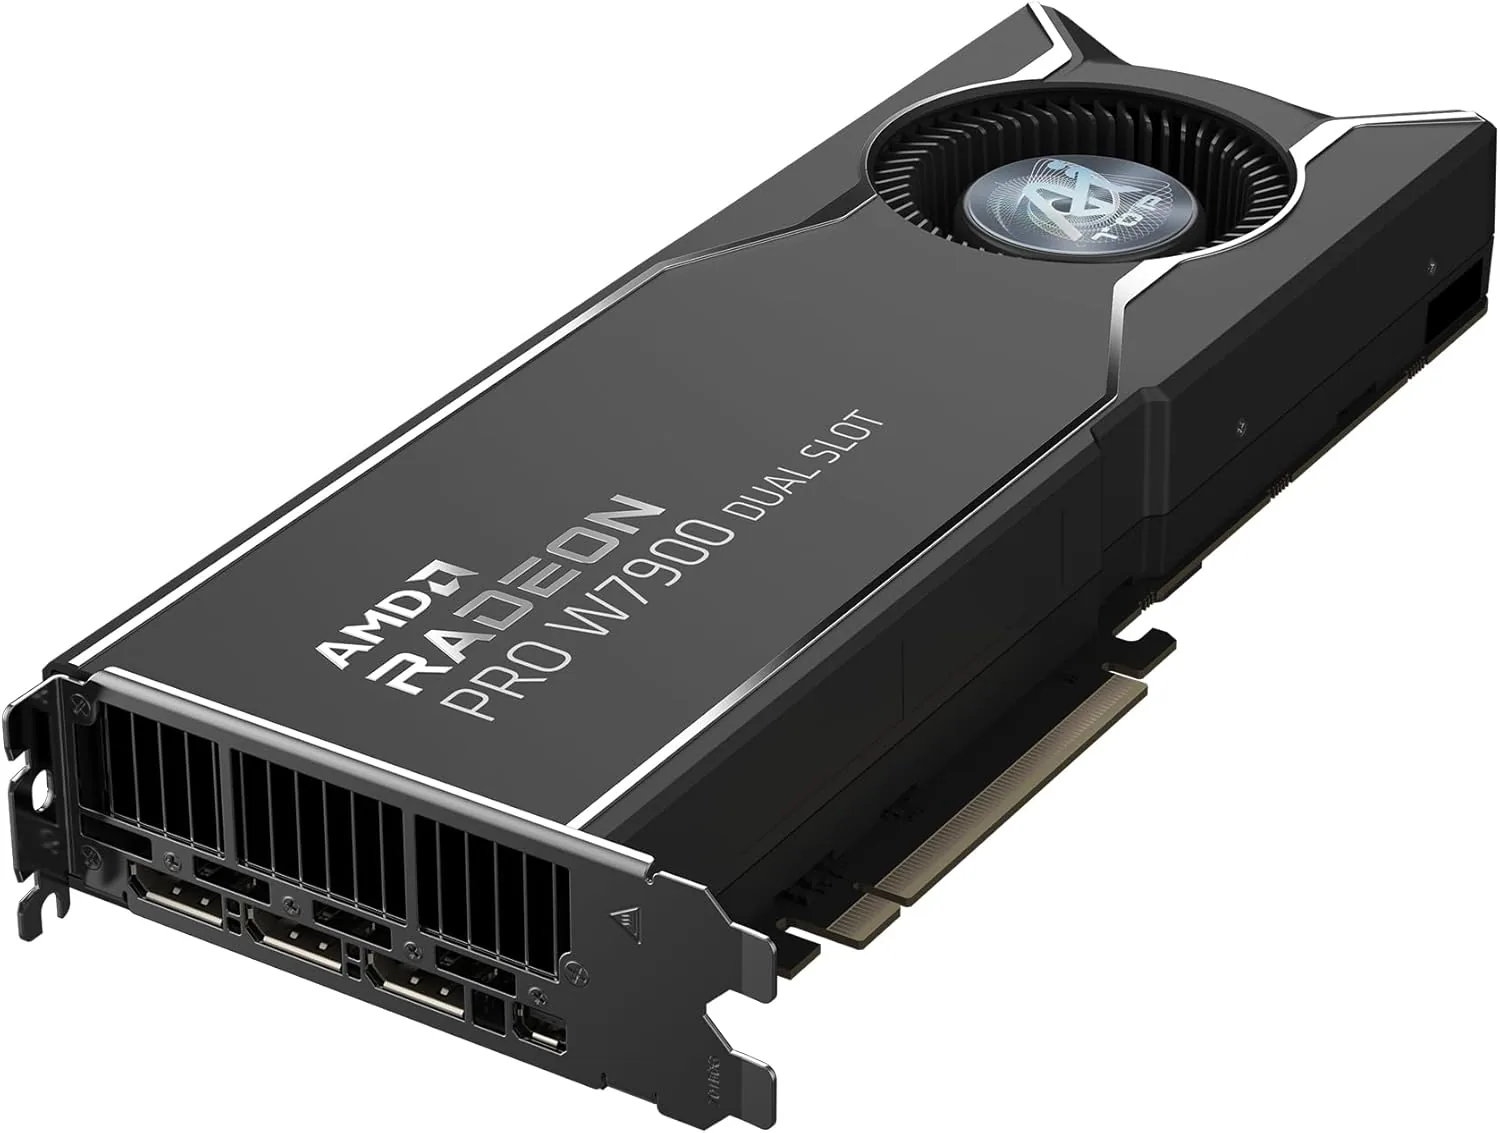
AMD
AMD Radeon PRO W7900 (48 GB)
- 48 GB
- AMD RDNA 3 (Navi 31)
Ejecuta modelos de hasta 70B a 4 bits
Elija la W7900 cuando lo más importante sea el tamaño del modelo o de la escena. La R9700, más reciente, tiene menos memoria (32 GB), pero añade compatibilidad con FP8 y ofrece más rendimiento por vatio en IA.
3592 €
SAPPHIRE
SAPPHIRE PULSE AMD Radeon RX 7900 XTX 24GB
- 24 GB
- AMD RDNA 3 (Navi 31)
Ejecuta modelos de hasta 30–34B a 4 bits
La PULSE mide 313 mm de largo y ocupa 2,7 ranuras, con tres conectores de alimentación de 8 pines. Antes de hacer el pedido, mida su caja y compruebe su fuente de alimentación (800 W como mínimo).
899 €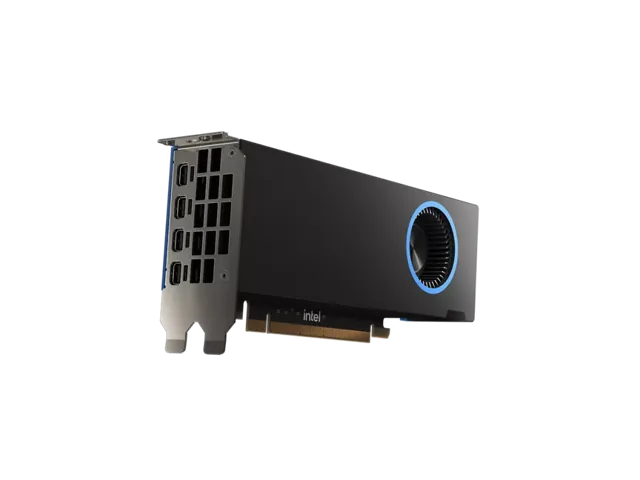
Intel
Intel Arc Pro B50
- 16 GB
- Intel Xe2 (Battlemage)
Ejecuta modelos de hasta 13–14B a 4 bits
No necesita cable de alimentación, por lo que es adecuada para equipos de formato reducido. Con 16 GB ejecuta modelos de 7B a 14B a 4 bits; para modelos mayores se necesita una tarjeta más grande.
299 €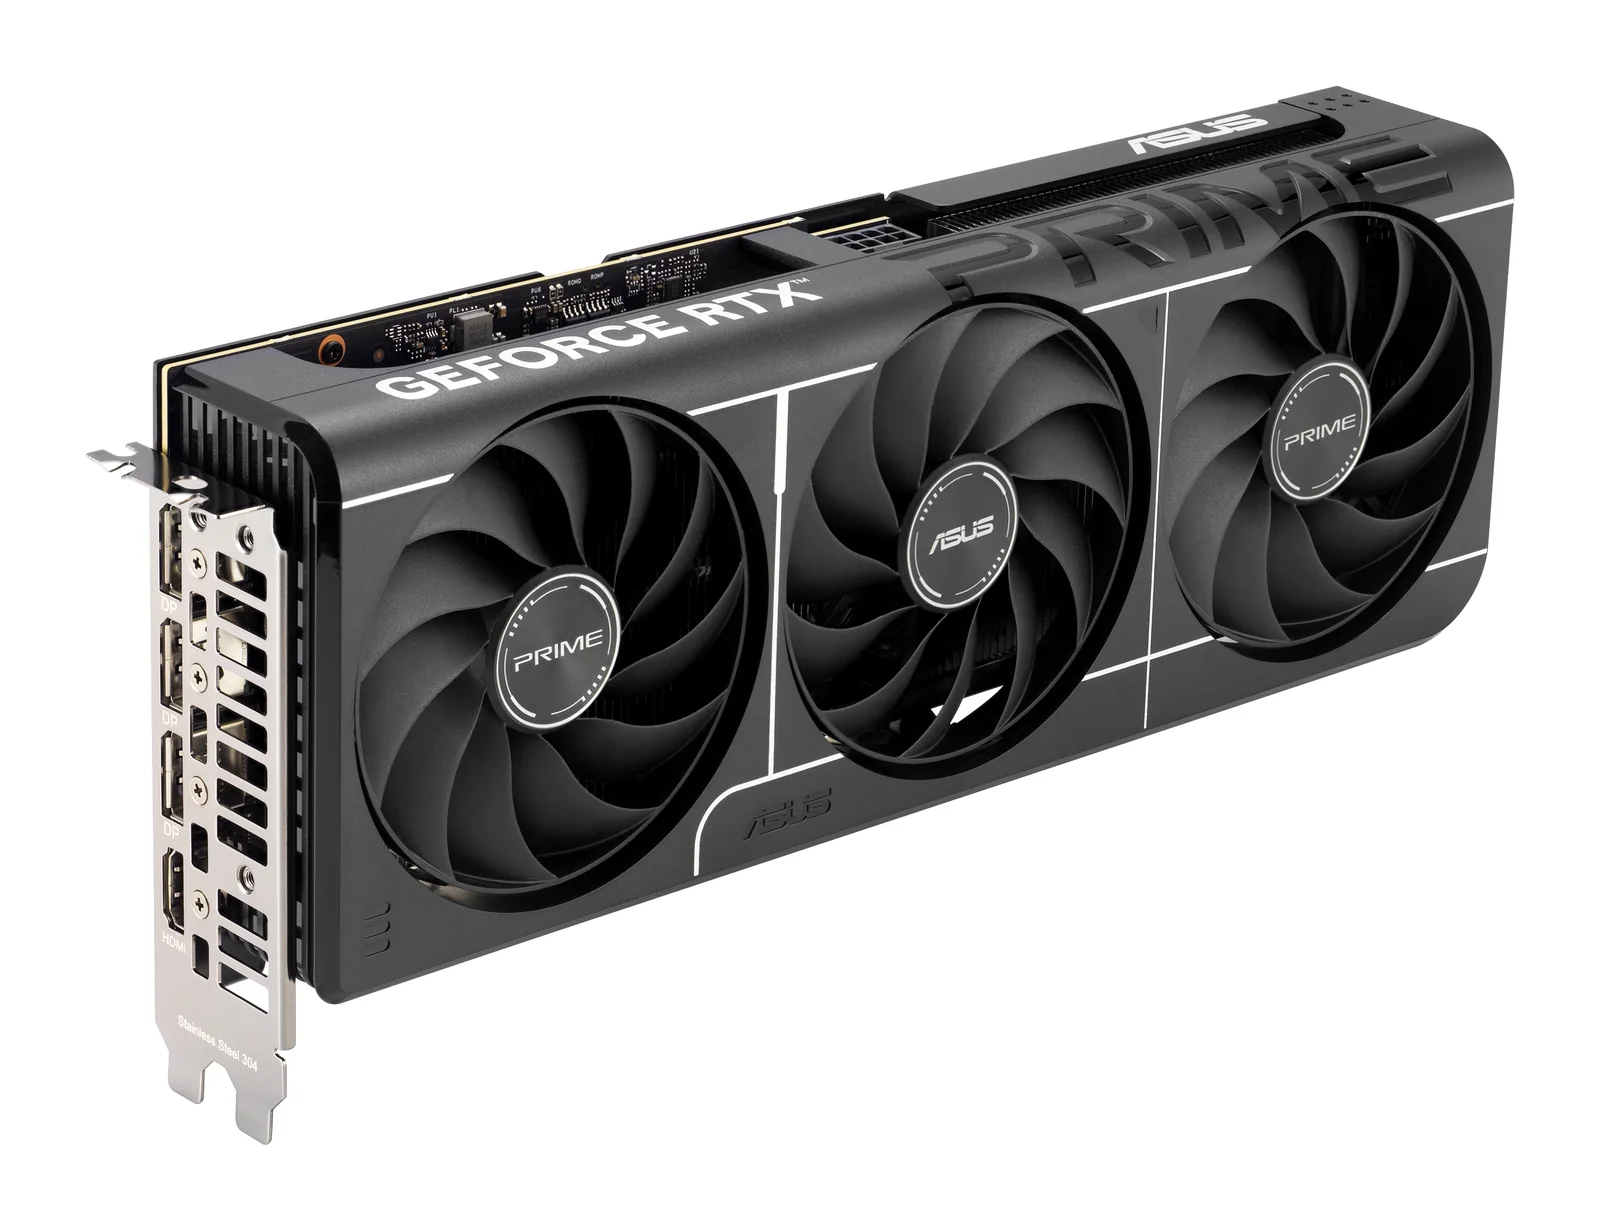
ASUS
ASUS Prime GeForce RTX 5060 Ti 16GB OC Edition
- 16 GB
- NVIDIA GeForce RTX 5060 Ti (Blackwell)
Ejecuta modelos de hasta 13–14B a 4 bits
Para IA local, compre solo la versión de 16 GB; es esta. Su bus de memoria de 128 bits es más estrecho que el de las tarjetas superiores, por lo que los modelos generan texto más despacio que en una RTX 5070 Ti.
369 €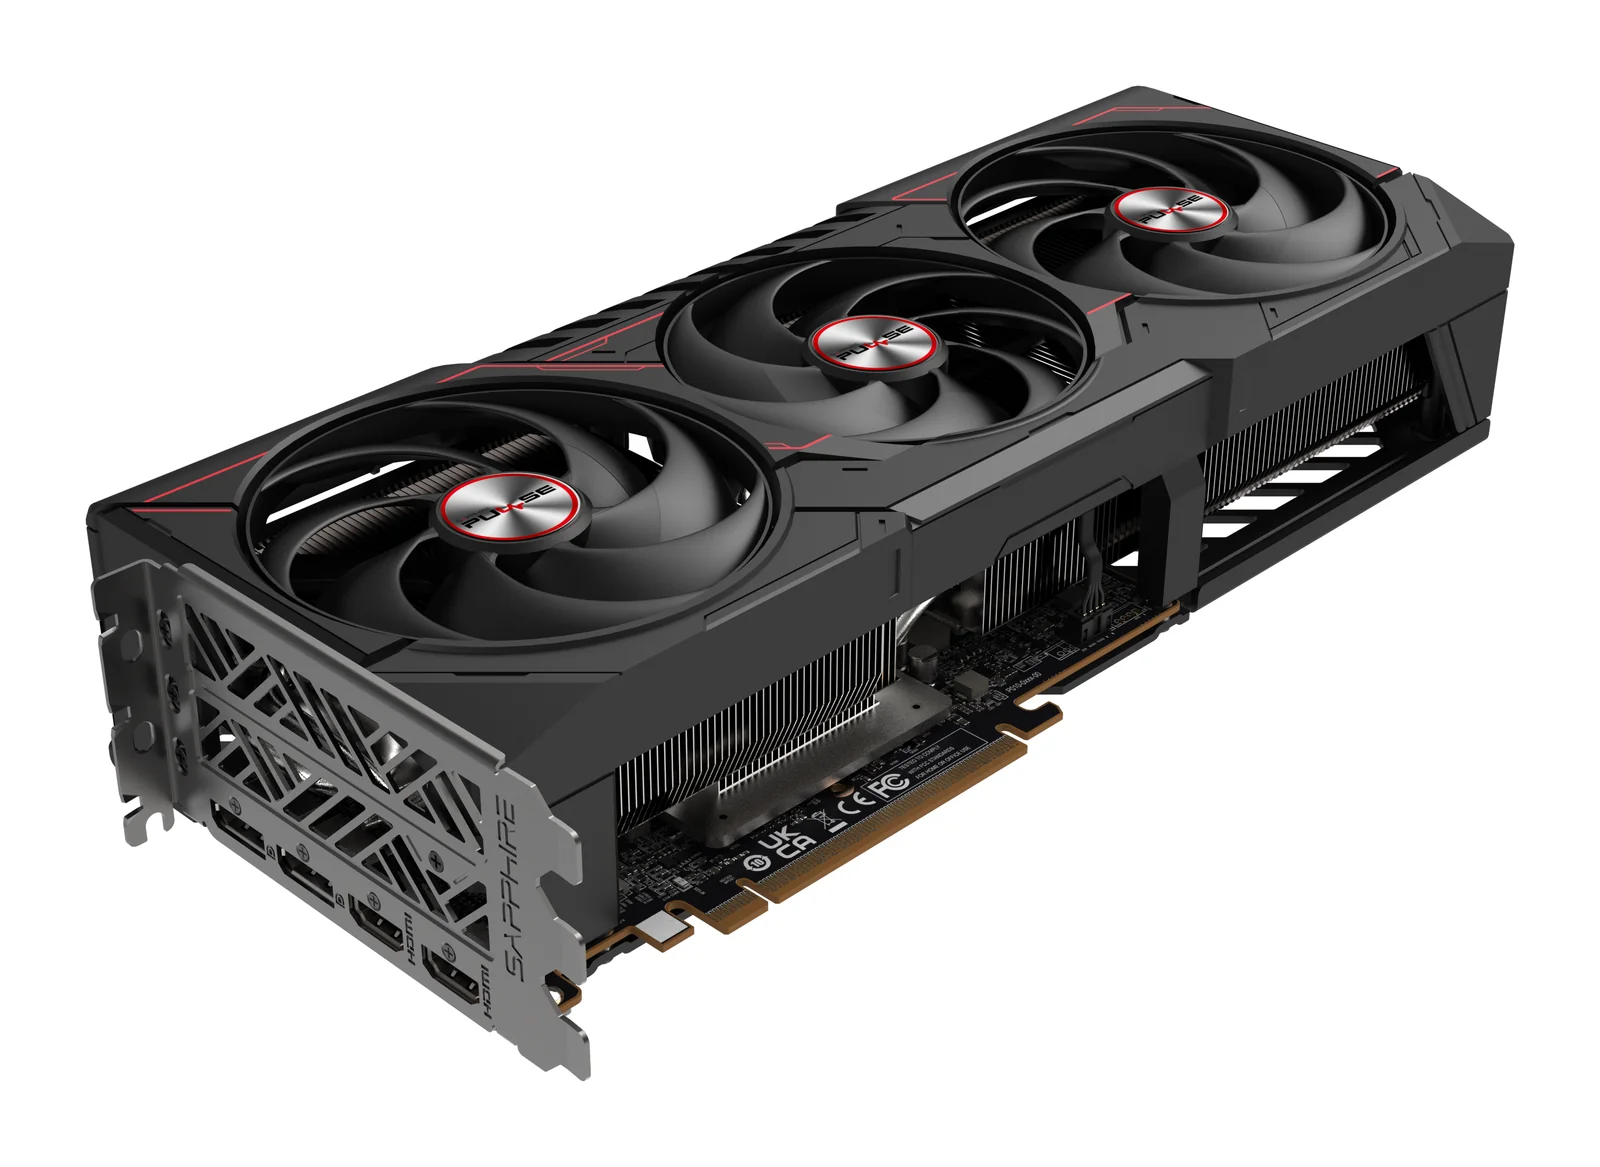
SAPPHIRE
SAPPHIRE PULSE AMD Radeon RX 9070 XT 16GB
- 16 GB
- AMD Radeon RX 9070 XT (RDNA 4)
Ejecuta modelos de hasta 13–14B a 4 bits
La tarjeta mide 320 mm de largo, ocupa tres ranuras y necesita dos cables de alimentación de 8 pines. SAPPHIRE recomienda una fuente de al menos 750 W, así que conviene medir antes la caja.
519 €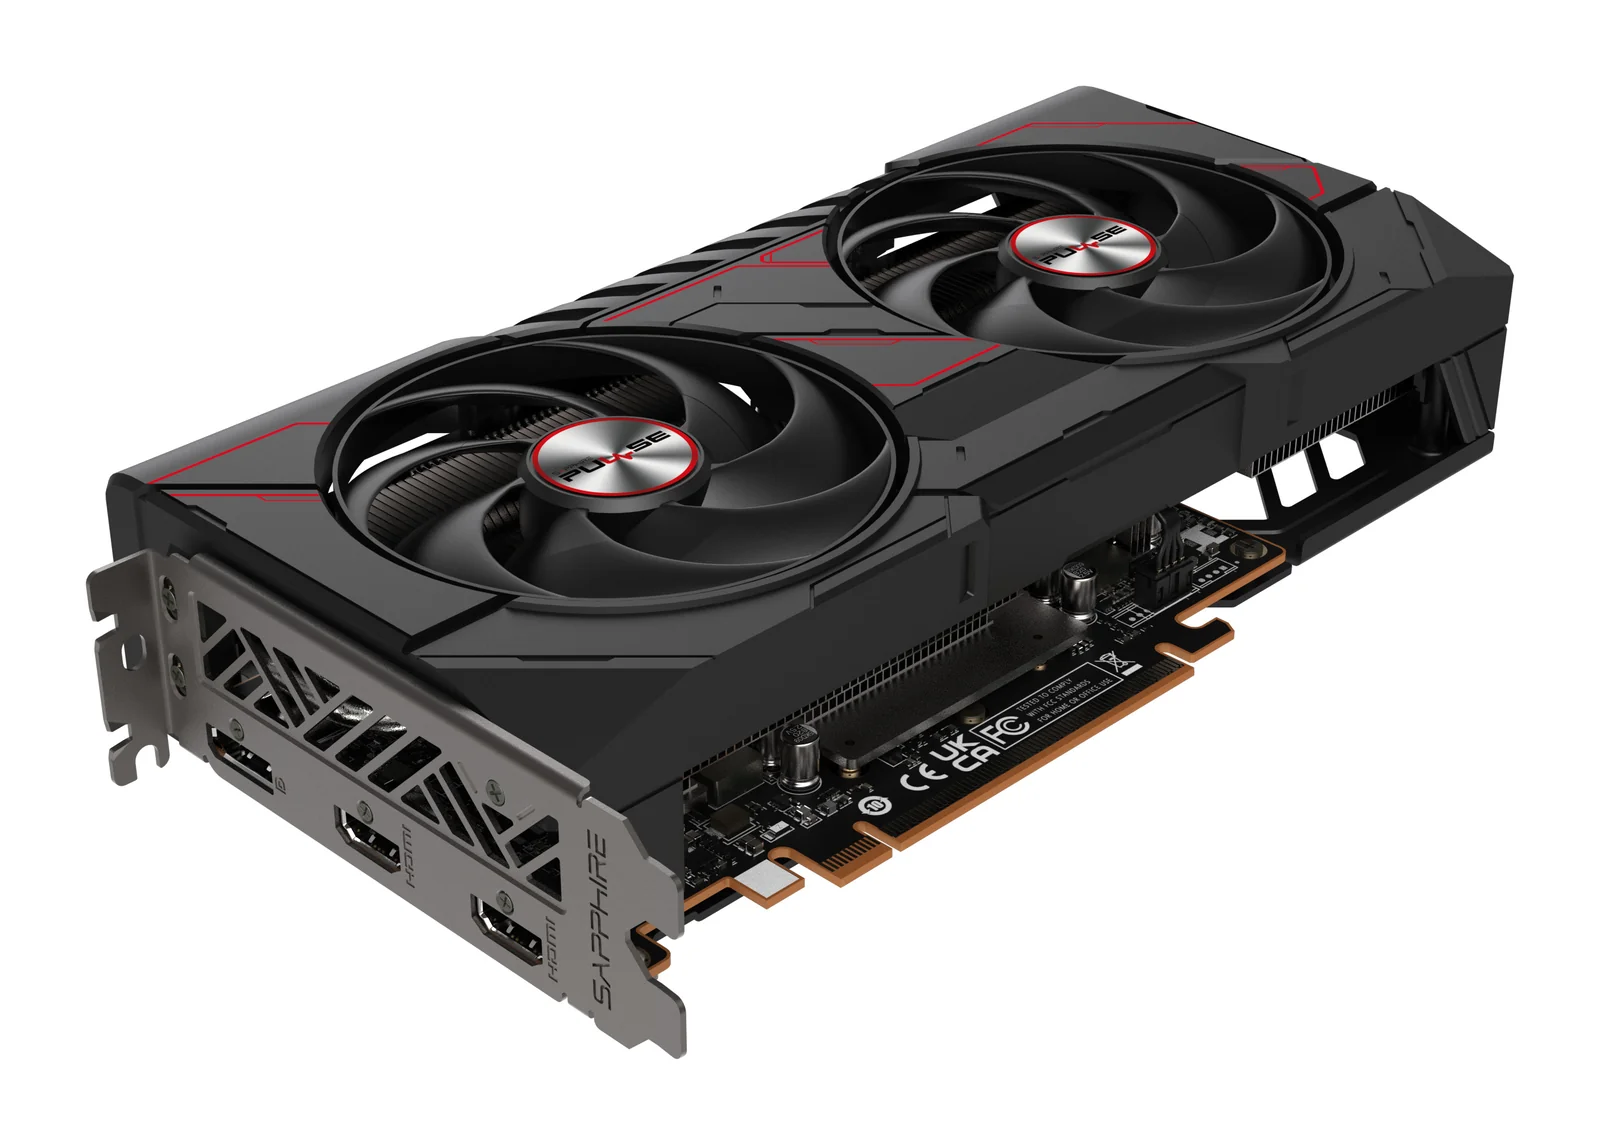
SAPPHIRE
SAPPHIRE PULSE AMD Radeon RX 9060 XT 16GB
- 16 GB
- AMD Radeon RX 9060 XT (RDNA 4)
Ejecuta modelos de hasta 13–14B a 4 bits
Esta es la versión de 16 GB; la de 8 GB es otra tarjeta y ya se queda corta de memoria en juegos nuevos. Basta con un cable de 8 pines y una fuente de alimentación de 450 W.
299 €Cómo elegir hardware para IA local
- Cuente la memoria utilizable, no la nominal
- Nuestra guía de modelos considera utilizable el 90 % de la memoria de una tarjeta gráfica y el 75 % de la memoria unificada, porque el sistema operativo se reserva parte de la memoria compartida. Un Mac de 64 GB deja unos 48 GB para modelos; una tarjeta de 48 GB, unos 43 GB.
- Ajuste la memoria al tamaño del modelo
- Hasta 14B a 4 bits: una tarjeta de 16 GB o un Mac mini de 24 GB. Clase 30B a 4 bits: una tarjeta de 24 GB o 32 GB. 70B a 4 bits: una tarjeta de 48 GB, dos tarjetas de 24 GB o 64 GB o más de memoria unificada. 70B a 8 bits y clase 120B a 4 bits: una tarjeta de 96 GB o un equipo con 128 GB de memoria unificada.
- Elija la plataforma que necesitan sus herramientas
- NVIDIA si sus herramientas necesitan CUDA o si también juega. Un Mac Studio para modelos grandes en un equipo casi silencioso. Un mini PC con Ryzen AI Max+ para tener 128 GB con Windows o Linux. El DGX Spark si desarrolla con CUDA y despliega en sistemas NVIDIA más grandes.
- Si el modelo cabe, el ancho de banda marca la velocidad
- Cada token nuevo recorre los pesos, así que un modelo escribe más rápido en un equipo con más ancho de banda de memoria: 1.792 GB/s en la RTX 5090, 819 GB/s en el Mac Studio y 273 GB/s en el Mac mini M4 Pro y el DGX Spark.
- Cuándo basta con un equipo más económico
- El chat, los resúmenes, el autocompletado de código y la búsqueda en sus propios documentos funcionan con modelos de 7B a 14B, que caben en 16 GB. La Arc Pro B50 o un Mac mini de 24 GB cubren esas tareas. Deje margen si trabaja con documentos largos.
Preguntas habituales
¿Puedo ejecutar un modelo de 70B en una sola tarjeta gráfica?
Solo en una tarjeta con 48 GB o más. En la Radeon PRO W7900 (48 GB) cabe justo a 4 bits, y en la RTX PRO 6000 (96 GB), a 8 bits. En una tarjeta de 32 GB como la RTX 5090 no cabe.
¿Qué significan 4 bits y 8 bits para el hardware que necesito?
A 4 bits, el modelo ocupa aproximadamente la mitad de memoria que a 8 bits, con una pequeña pérdida de calidad, y es como la mayoría ejecuta modelos en casa. A 8 bits se conserva más calidad, pero se necesita aproximadamente el doble de memoria, algo que compensa para programar o extraer datos con precisión.
¿Cuánta memoria adicional necesitan las conversaciones largas y los documentos?
La memoria de contexto crece con cada token que el modelo conserva en contexto, así que conviene prever más que el tamaño del propio modelo. Opte por el tamaño de memoria inmediatamente superior en lugar de uno en el que el modelo apenas quepa.
¿Sirve el hardware de IA local para hacer fine-tuning?
El fine-tuning necesita más memoria que ejecutar un modelo. Los métodos eficientes en parámetros, como LoRA, reducen mucho esa necesidad; para trabajar con CUDA, el DGX Spark de 128 GB ofrece margen en tamaños que una tarjeta de 32 GB no alcanza.
¿Pueden montar un equipo para los modelos que quiero ejecutar?
Sí. Envíe una solicitud de configuración a medida con los modelos que quiere ejecutar, su presupuesto y su país, y le responderemos con una configuración y un presupuesto.
Páginas relacionadas: Tarjetas gráficas · Mini PC · Apple · Aceleradores de IA
Guías
IA local · 5 min de lectura
¿Cuánta memoria hace falta para ejecutar un LLM en local?
Sepa cuánta memoria necesita un LLM local: modelos de 7B a 120B+ a 4 y 8 bits, memoria unificada frente a VRAM y qué equipos admiten cada tamaño.
Leer la guía →IA local · 5 min de lectura
Mac, NVIDIA o Ryzen AI Max+ para IA local
Mac, NVIDIA o Ryzen AI Max+: qué plataforma encaja con cada trabajo. CUDA, memoria unificada en Mac o 128 GB en un mini PC. Memoria, software y límites.
Leer la guía →Tarjetas gráficas · 5 min de lectura
Cómo elegir una GPU para IA local: RTX 5090, R9700 y B60
Cómo elegir una GPU para IA local según memoria, software y ancho de banda: RTX 5090, Radeon AI PRO R9700, Arc Pro B60 y las profesionales de 48 y 96 GB.
Leer la guía →