Catégorie
Cartes accélératrices IA et ordinateurs pour créer des modèles
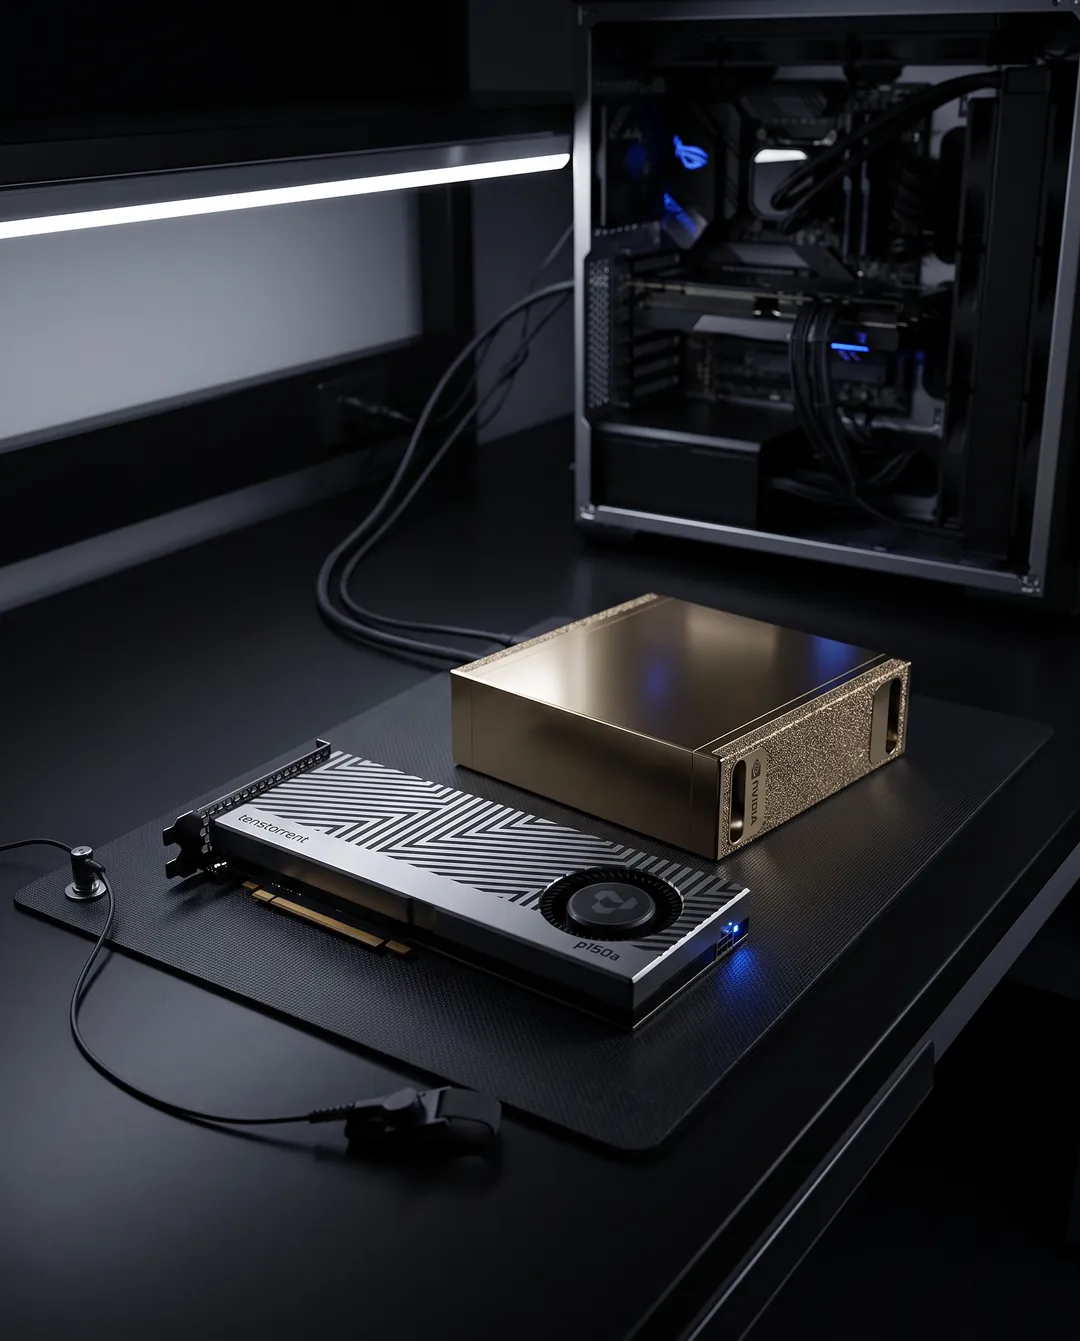
Des cartes accélératrices IA et des ordinateurs de bureau conçus d'abord pour l'IA : les cartes Tenstorrent, avec une pile logicielle open source, et l'ordinateur de bureau NVIDIA DGX Spark.
Un accélérateur IA se choisit d'abord pour son logiciel. Le NVIDIA DGX Spark est une machine de développement CUDA de 128 GB dont le code se porte ensuite sur des systèmes DGX plus grands et sur le cloud ; les cartes Tenstorrent utilisent une pile entièrement open source, programmable jusqu'aux kernels. Si vous voulez surtout faire tourner rapidement de gros modèles plutôt que les développer, un Mac Studio ou une carte graphique convient souvent mieux.
Notre sélection
Développement CUDA avec 128 GB
DGX Spark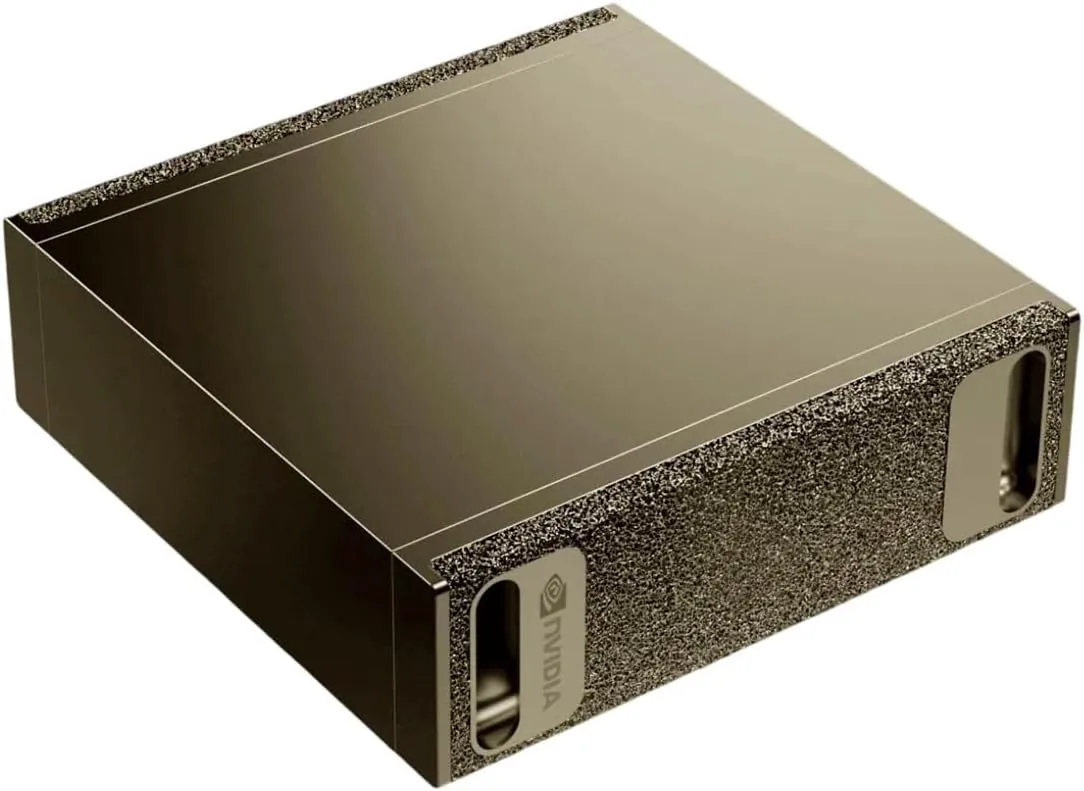
NVIDIA
NVIDIA DGX Spark
- 128 GB unifiés
- NVIDIA GB10 Grace Blackwell
Fait tourner jusqu'à 120B+ en 4 bits
Sa bande passante mémoire (273 GB/s) est inférieure à celle d'une carte graphique haut de gamme : les gros modèles denses génèrent donc du texte plus lentement que sur une RTX 5090. Ses points forts sont la capacité et la pile logicielle CUDA.
4 699 €Un boîtier de bureau de 150 mm de côté, doté de la pile logicielle NVIDIA, pour prototyper et faire du fine-tuning avant de passer sur du matériel NVIDIA plus puissant.
La carte à pile ouverte la mieux dotée en mémoire
Tenstorrent Blackhole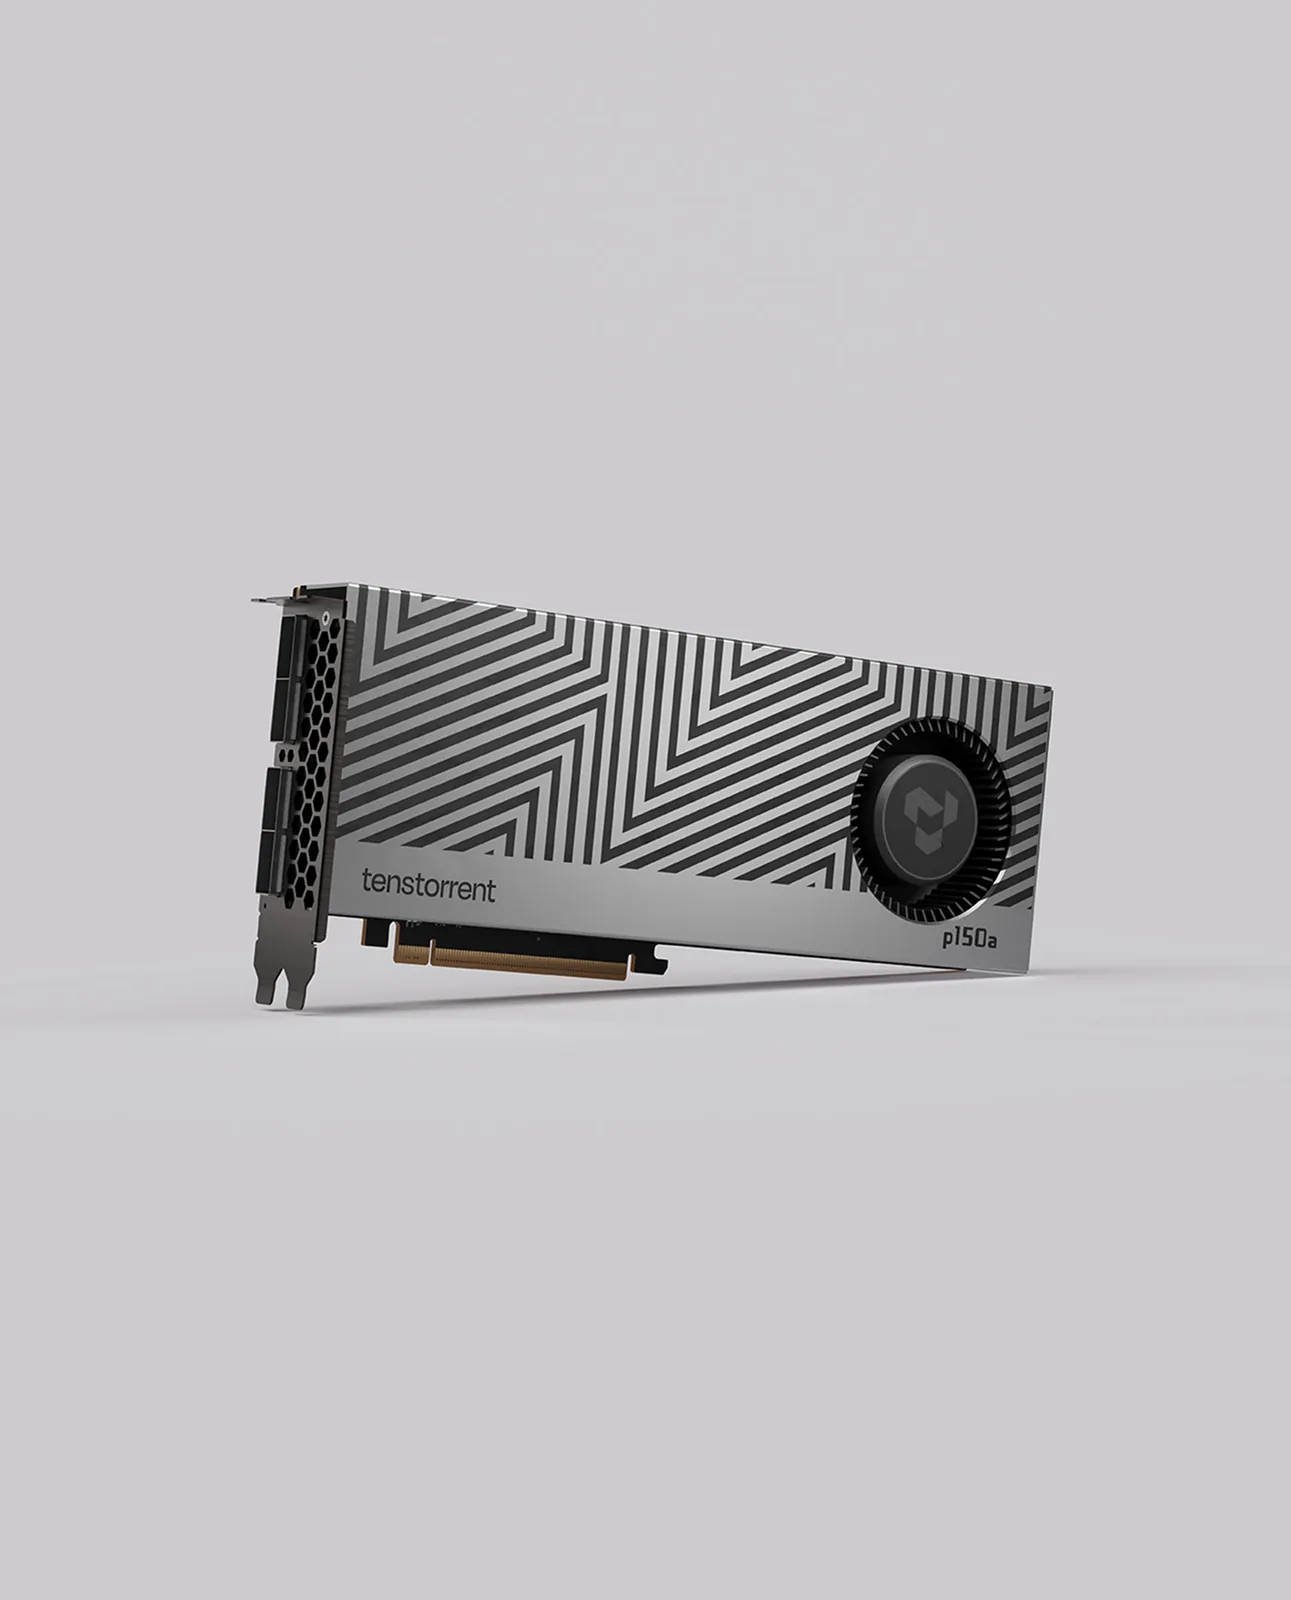
Tenstorrent
Tenstorrent Blackhole p150a
- 32 GB
- Tenstorrent Blackhole
Fait tourner jusqu'à 30–34B en 4 bits
Ce n'est pas une carte CUDA. Vérifiez avant l'achat que les modèles dont vous avez besoin sont pris en charge par la bibliothèque de modèles open source de Tenstorrent.
1 399 €32 GB de GDDR6, 120 cœurs Tensix et quatre ports 800G pour relier les cartes, avec un logiciel que vous pouvez lire et modifier.
Pour débuter avec Tenstorrent
Tenstorrent Wormhole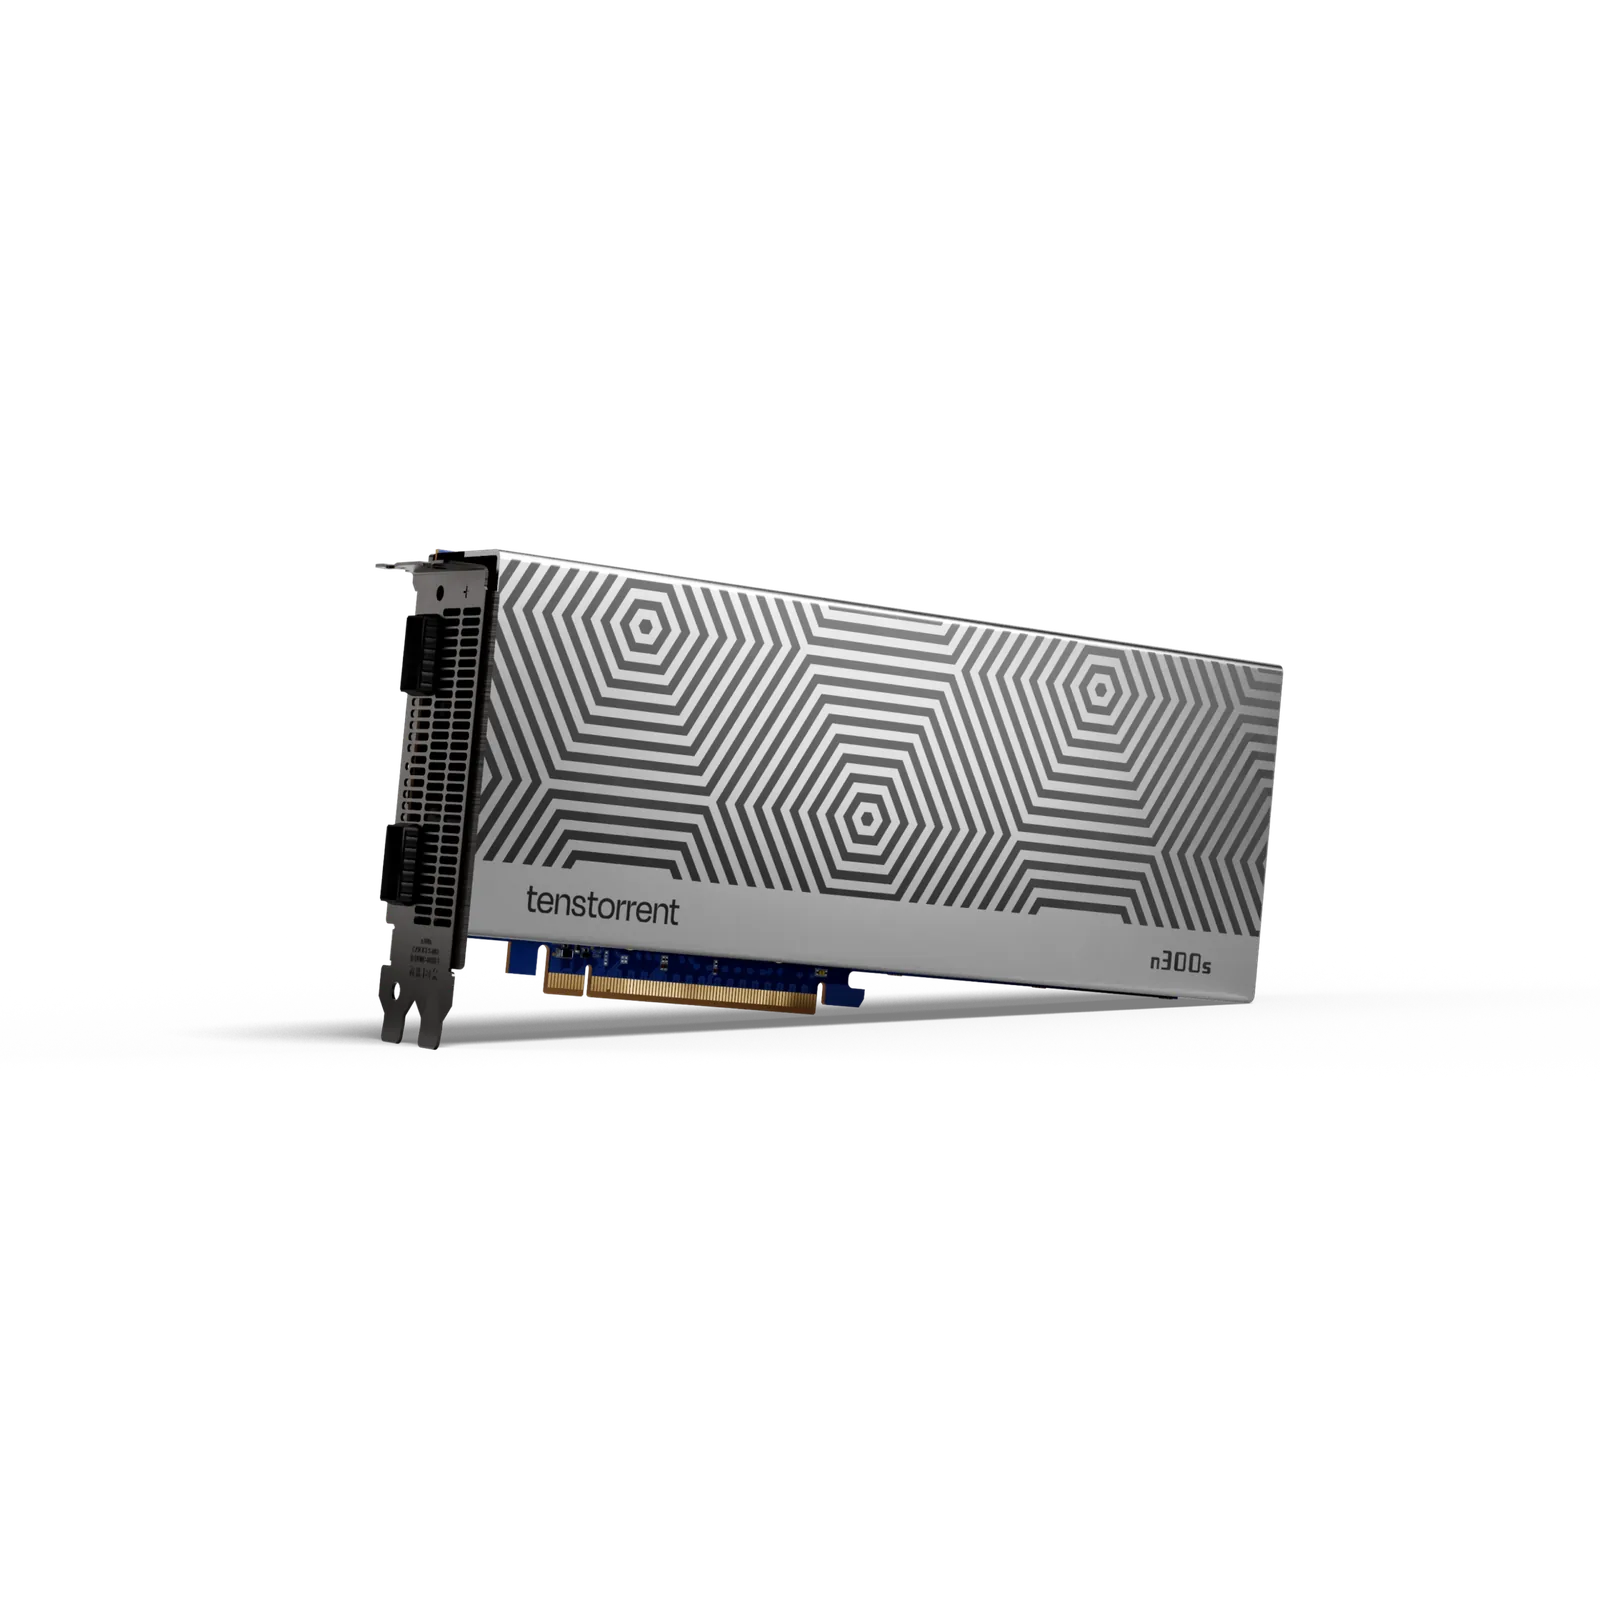
Tenstorrent
Tenstorrent Wormhole n300s
- 24 GB
Fait tourner jusqu'à 30–34B en 4 bits
Les 24 GB sont répartis sur deux puces (12 GB chacune) : les modèles les plus grands doivent donc être répartis sur les deux. Vérifiez que le modèle souhaité dispose d'une version multipuce fonctionnelle.
1 399 €Deux puces Wormhole et 24 GB sur une seule carte, avec le même logiciel open source que Blackhole, pour apprendre et développer sur cette pile.
NVIDIA
NVIDIA DGX Spark
- 128 GB unifiés
- NVIDIA GB10 Grace Blackwell
Fait tourner jusqu'à 120B+ en 4 bits
Sa bande passante mémoire (273 GB/s) est inférieure à celle d'une carte graphique haut de gamme : les gros modèles denses génèrent donc du texte plus lentement que sur une RTX 5090. Ses points forts sont la capacité et la pile logicielle CUDA.
4 699 €Tenstorrent
Tenstorrent Blackhole p150a
- 32 GB
- Tenstorrent Blackhole
Fait tourner jusqu'à 30–34B en 4 bits
Ce n'est pas une carte CUDA. Vérifiez avant l'achat que les modèles dont vous avez besoin sont pris en charge par la bibliothèque de modèles open source de Tenstorrent.
1 399 €Tenstorrent
Tenstorrent Wormhole n300s
- 24 GB
Fait tourner jusqu'à 30–34B en 4 bits
Les 24 GB sont répartis sur deux puces (12 GB chacune) : les modèles les plus grands doivent donc être répartis sur les deux. Vérifiez que le modèle souhaité dispose d'une version multipuce fonctionnelle.
1 399 €Comment choisir un accélérateur IA
- CUDA ou open source
- Le DGX Spark est livré avec la pile logicielle IA de NVIDIA : le code écrit dessus se porte sur des systèmes DGX plus grands avec peu de modifications. Les cartes Tenstorrent utilisent TT-Metalium et TT-Forge, open source des kernels bas niveau jusqu'au compilateur de modèles. Ce ne sont pas des cartes CUDA.
- Vérifiez d'abord la prise en charge des modèles
- Avant d'acheter une carte Tenstorrent, vérifiez que les modèles dont vous avez besoin figurent dans la bibliothèque de modèles open source de Tenstorrent. Sur la Wormhole n300, les 24 GB sont répartis en 12 GB par puce : les modèles plus gros nécessitent une version multipuce fonctionnelle.
- La mémoire fixe le plafond
- Selon la règle de notre guide des modèles, les 128 GB de mémoire unifiée du Spark suffisent pour un modèle 70B en 8 bits ou un modèle de classe 120B en 4 bits. La Blackhole p150a dispose de 32 GB de GDDR6 à 512 GB/s, assez pour un modèle de classe 30B en 4 bits si la bibliothèque le prend en charge.
- Capacité n'est pas vitesse
- La bande passante mémoire du Spark est de 273 GB/s, contre 1 792 GB/s sur une RTX 5090. Les gros modèles denses y génèrent du texte plus lentement ; les modèles MoE (mixture of experts), qui ne lisent qu'une partie de leurs poids à chaque token, souffrent moins de cet écart.
- Prévoir la montée en charge
- Deux DGX Spark se relient via le réseau ConnectX-7 intégré, à 200 Gb/s. La p150a dispose de quatre ports QSFP-DD 800G et la n300 de deux ports QSFP-DD pour chaîner les cartes. Chaque carte Tenstorrent consomme 300 W et exige un emplacement PCIe x16 : prévoyez l'alimentation et le flux d'air de la machine hôte.
Questions fréquentes
Faut-il acheter un accélérateur IA ou une carte graphique ?
Choisissez un accélérateur pour son logiciel : le DGX Spark pour développer en CUDA avec 128 GB, une carte Tenstorrent pour une pile ouverte. Pour la meilleure vitesse sur des modèles jusqu'à environ 30B, ou si vous jouez aussi, une carte graphique comme la RTX 5090 est le meilleur choix.
Mon code CUDA fonctionnera-t-il sur une carte Tenstorrent ?
Non. Les cartes Tenstorrent utilisent leur propre pile open source, TT-Metalium et TT-Forge. Vérifiez que vos modèles sont pris en charge dans la bibliothèque de modèles de Tenstorrent avant d'acheter.
Le DGX Spark peut-il faire tourner Windows ou des jeux ?
Non. Il fonctionne sous NVIDIA DGX OS, un système Linux basé sur Ubuntu, avec un processeur Arm. Les logiciels conçus uniquement pour Windows x86 ne fonctionneront pas, et ce n'est pas une machine de jeu.
Puis-je faire du fine-tuning de modèles sur le DGX Spark ?
Oui. Le fine-tuning demande plus de mémoire que l'exécution d'un modèle, et les méthodes économes en paramètres comme LoRA réduisent fortement ce besoin. Les 128 GB du Spark offrent de la marge pour ce travail, sur des tailles hors de portée d'une carte de 32 GB.
Pages associées: Matériel pour l'IA locale · Apple
Guides
IA locale · 4 min de lecture
DGX Spark vs Mac Studio : à qui s'adresse le Spark
DGX Spark vs Mac Studio : ce que le Spark fait bien, où il est plus lent, et comment il se situe face à une RTX 5090 et une RTX PRO 6000 pour l'IA locale.
Lire le guide →IA locale · 5 min de lecture
Mac, NVIDIA ou Ryzen AI Max+ pour l'IA locale
Mac, NVIDIA ou Ryzen AI Max+ : CUDA chez NVIDIA, mémoire unifiée sur Mac ou 128 GB sur un mini PC. Mémoire, logiciels et compromis pour chaque usage.
Lire le guide →IA locale · 5 min de lecture
Combien de mémoire faut-il pour faire tourner un LLM en local ?
LLM en local : combien de mémoire pour les modèles de 7B à 120B+ en 4 bits et en 8 bits, mémoire unifiée ou VRAM, et quelles machines pour chaque taille.
Lire le guide →