Combien de mémoire faut-il pour faire tourner un LLM en local ?
Mis à jour le 17 novembre 2026 · 5 min de lecture
C'est la mémoire qui détermine les modèles que vous pouvez faire tourner ; la vitesse ne vient qu'ensuite. Un modèle 7–8B demande environ 6 GB en 4 bits, un modèle 70B environ 42 GB, et les plus grands modèles ouverts que la plupart des gens font tourner chez eux environ 80 GB. Voici d'où viennent ces chiffres et quelles machines y répondent.
En bref#
| Taille du modèle | Exemples | 4-bit | 8-bit | Configuration adaptée en 4 bits |
|---|---|---|---|---|
| 7–8B | Llama 3.1 8B, Mistral 7B, Qwen2.5 7B | environ 6 GB | environ 10 GB | Presque n'importe quelle carte graphique récente ou n'importe quel Mac |
| 13–14B | Phi-4, Qwen2.5 14B | environ 10 GB | environ 16 GB | Une carte de 16 GB, ou un Mac mini avec 24 GB |
| 27–34B | Gemma 2 27B, Qwen2.5 32B | environ 20 GB | environ 38 GB | Une carte de 24 GB ou 32 GB |
| 70B | Llama 3.3 70B, Qwen2.5 72B | environ 42 GB | environ 80 GB | Deux cartes de 24 GB, une carte de 48 GB, ou au moins 64 GB de mémoire unifiée |
| 120B+ | gpt-oss-120b (MoE), Mistral Large 2 | environ 80 GB | environ 140 GB | Une carte de 96 GB ou un système doté de 128 GB de mémoire unifiée |
Ces chiffres sont volontairement prudents. Considérez-les comme le minimum pour une configuration confortable, pas comme un objectif à atteindre au plus juste.
D'où viennent ces chiffres#
La règle de base est simple : les poids d'un modèle occupent environ paramètres × bits ÷ 8 octets. Un modèle 70B en 4 bits représente environ 35 GB de poids. Ajoutez 20 à 30 % pour le contexte (le KV cache), les tampons d'exécution et la part du système d'exploitation, et vous arrivez à environ 42 GB.
Les modèles sont généralement publiés en précision 16 bits, où chaque milliard de paramètres occupe 2 GB : un modèle 8B représente donc 16 GB de poids avant même de charger quoi que ce soit d'autre. C'est pourquoi peu de gens utilisent la pleine précision chez eux.
Quatre facteurs augmentent ce besoin :
- Les contextes longs. Le KV cache grossit à chaque token que le modèle conserve dans son contexte : un long document ou une longue conversation demande donc plus que ce qu'indique le tableau.
- Plusieurs utilisateurs simultanés. Servir une équipe implique de traiter les requêtes par lots, et chacune a besoin de sa propre mémoire de contexte.
- Les modèles d'image et de vidéo. Ils utilisent la mémoire différemment des modèles de texte ; prévoyez davantage de marge.
- Les modèles mixture-of-experts (MoE). Ils sont plus rapides que les modèles denses de même taille, car seule une partie du modèle travaille sur chaque token, mais tous les poids doivent quand même tenir en mémoire.
4 bits ou 8 bits ?#
La quantification stocke chaque poids sur moins de bits. En 4 bits, un modèle occupe environ moitié moins de mémoire qu'en 8 bits, avec une légère perte de qualité : c'est ainsi que la plupart des gens font tourner des modèles chez eux. Le 8 bits conserve davantage la qualité d'origine et demande environ deux fois plus de mémoire.
Pour la conversation et l'usage courant, beaucoup trouvent qu'un modèle plus grand en 4 bits rend plus de services qu'un modèle plus petit en 8 bits dans la même mémoire. Pour le code ou l'extraction de données exactes, où la moindre erreur se paie, le 8 bits justifie la mémoire supplémentaire, si vous en disposez.
Mémoire graphique ou mémoire unifiée#
Sur une carte graphique, le modèle réside dans la mémoire propre de la carte (VRAM). Notre guide des modèles en considère environ 90 % comme utilisables.
Les machines Apple silicon, Ryzen AI Max+ et DGX Spark partagent une même réserve de mémoire unifiée entre le CPU et le GPU. Le système d'exploitation s'en réserve une partie et le GPU a ses propres limites : le guide des modèles en compte donc environ 75 % comme utilisables. Sur les machines Ryzen AI Max+ sous Windows, le GPU peut se voir attribuer jusqu'à 96 GB sur les 128 GB ; Linux permet d'en attribuer davantage. macOS garde lui aussi une partie de cette mémoire pour le système.
Concrètement : un Mac mini avec 24 GB dispose d'environ 18 GB pour les modèles, assez pour un modèle 14B en 8 bits mais pas pour un modèle 30B en 4 bits. Le même Mac mini avec 64 GB dispose d'environ 48 GB, assez pour un modèle 70B en 4 bits.
Un modèle qui tient tout juste en mémoire peinera à mesure que la conversation s'allonge. Prévoyez de la place pour le contexte.
La mémoire détermine ce qui tient, la bande passante fixe la vitesse#
Une fois que le modèle tient en mémoire, sa vitesse de génération dépend surtout de la bande passante mémoire, car chaque nouveau token implique de relire les poids ; un modèle qui déborde sur la RAM système ralentit fortement. La RTX 5090 atteint 1 792 GB/s, le Mac Studio avec M3 Ultra 819 GB/s, tandis que le Mac mini avec M4 Pro et la DGX Spark atteignent chacun 273 GB/s. Un modèle qui tient sur deux de ces machines générera en général plus vite sur celle qui offre le plus de bande passante.
Quelle machine pour quelle taille de modèle#
- Jusqu'à 14B : l'Intel Arc Pro B50 (16 GB) ou un Mac mini avec 24 GB.
- Jusqu'à 34B en 4 bits : une carte de 24 GB ou 32 GB, comme la RTX 5090, la Radeon AI PRO R9700, l'Arc Pro B60 ou la RTX 4090.
- 70B en 4 bits : la Radeon PRO W7900 de 48 GB, deux cartes de 24 GB, un Mac Studio ou un mini PC Ryzen AI Max+.
- 70B en 8 bits et classe 120B en 4 bits : la RTX PRO 6000 de 96 GB, une machine Ryzen AI Max+ avec 128 GB ou la DGX Spark.
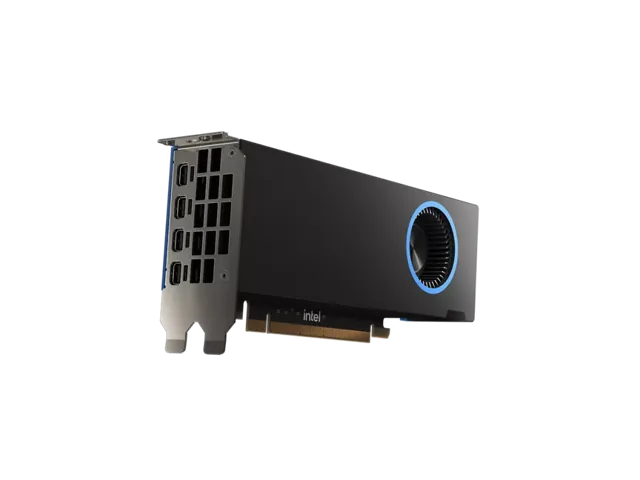
Intel
Intel Arc Pro B50
- 16 GB
- Intel Xe2 (Battlemage)
Fait tourner jusqu'à 13–14B en 4 bits
Aucun câble d'alimentation n'est nécessaire : elle convient aux machines au format compact. 16 GB permettent de faire tourner des modèles 7B à 14B en 4 bits ; au-delà, il faut une carte plus grosse.
299 €
NVIDIA
NVIDIA GeForce RTX 5090
- 32 GB
- NVIDIA Blackwell (GB202)
Fait tourner jusqu'à 30–34B en 4 bits
Avec 32 GB, les modèles de classe 30B tournent confortablement en 4 bits, mais un modèle 70B ne tient pas sur une seule carte. Pour du 70B, prévoyez deux cartes ou un système à grande mémoire unifiée.
1 999 €
Apple
Apple Mac Studio (M3 Ultra)
- 96 GB unifiés
- 60 cœurs ; option 80 cœurs
Fait tourner jusqu'à 70B en 4 bits
macOS réserve une partie de la mémoire unifiée au système : le GPU peut en utiliser la majeure partie, pas la totalité. Choisissez une configuration avec de la marge au-delà de la taille du modèle.
3 999 €
Beelink
Beelink GTR9 Pro
- 128 GB unifiés
- AMD Ryzen AI Max+ 395
Fait tourner jusqu'à 120B+ en 4 bits
Sous Windows, le GPU peut se voir attribuer jusqu'à 96 GB sur les 128 GB. Vérifiez avant l'achat que le modèle que vous comptez utiliser tient dans cette enveloppe.
4 349 €Une machine moins chère suffit si vos usages se limitent aux petits modèles. Résumés, chat, complétion de code, recherche dans vos propres documents : tout cela fonctionne avec des modèles 7–14B, qui tiennent dans 16 GB. Le guide des modèles indique la compatibilité de chaque produit de notre catalogue.
Questions fréquentes
Puis-je faire tourner un modèle 70B sur une carte graphique de 32 GB ?
Pas dans de bonnes conditions. En 4 bits, il lui faut environ 42 GB. Certains outils peuvent déporter une partie du modèle dans la RAM système, mais cette partie tourne beaucoup plus lentement. Pour un 70B, prévoyez deux cartes de 24 GB, une carte de 48 GB ou une machine à mémoire unifiée de 64 GB ou plus.
La RAM système de mon PC compte-t-elle ?
Sur un PC équipé d'une carte graphique, seule la mémoire de la carte fonctionne à pleine vitesse. Certains outils peuvent placer une partie du modèle dans la RAM système, au prix d'une forte baisse de vitesse. Sur les machines à mémoire unifiée, la mémoire partagée est celle qu'utilise le GPU.
Combien de mémoire supplémentaire faut-il pour les longs documents ?
La mémoire de contexte augmente avec la longueur : prévoyez une marge au-delà des valeurs du tableau. Pour de longs documents ou de longues conversations, choisissez la capacité mémoire immédiatement supérieure plutôt que celle qui contient tout juste le modèle.
Le 8 bits justifie-t-il de doubler la mémoire ?
Pour un usage conversationnel courant, la plupart des utilisateurs s'en tiennent au 4 bits, et la perte de qualité reste faible. Pour le code ou l'extraction précise d'informations, le 8 bits en vaut la peine si la mémoire le permet.
Voir les produits: Matériel pour l'IA locale · Cartes graphiques · Apple
Guides associés
IA locale · 5 min de lecture
Mac, NVIDIA ou Ryzen AI Max+ pour l'IA locale
Mac, NVIDIA ou Ryzen AI Max+ : CUDA chez NVIDIA, mémoire unifiée sur Mac ou 128 GB sur un mini PC. Mémoire, logiciels et compromis pour chaque usage.
Lire le guide →Cartes graphiques · 5 min de lecture
Choisir un GPU pour l'IA locale : RTX 5090, R9700, B60
Choisir un GPU pour l'IA locale selon la mémoire, le logiciel et la bande passante : RTX 5090, Radeon AI PRO R9700, Arc Pro B60, cartes pro 48 et 96 GB.
Lire le guide →IA locale · 4 min de lecture
DGX Spark vs Mac Studio : à qui s'adresse le Spark
DGX Spark vs Mac Studio : ce que le Spark fait bien, où il est plus lent, et comment il se situe face à une RTX 5090 et une RTX PRO 6000 pour l'IA locale.
Lire le guide →