GPU voor lokale AI kiezen: RTX 5090, R9700, B60
Bijgewerkt op 17 november 2026 · 5 min lezen
Eerst geheugen, dan software, dan snelheid. De RTX 5090 is de snelste kaart met 32 GB en volledige CUDA-ondersteuning. De Radeon AI PRO R9700 biedt dezelfde 32 GB bij 300 W in plaats van 575 W, mits je software op ROCm draait. De Intel Arc Pro B60 is een van de toegankelijkste manieren om 24 GB op één kaart te krijgen. Wil je een 70B-model op één kaart, kies dan de Radeon PRO W7900 met 48 GB of de RTX PRO 6000 met 96 GB.
De kaarten naast elkaar#
| Kaart | Geheugen | Bandbreedte | Kaartvermogen | Software |
|---|---|---|---|---|
| NVIDIA GeForce RTX 5090 | 32 GB GDDR7 | 1.792 GB/s | 575 W | CUDA |
| AMD Radeon AI PRO R9700 | 32 GB GDDR6 | 640 GB/s | 300 W | ROCm |
| Intel Arc Pro B60 | 24 GB GDDR6 | 456 GB/s | 120–200 W, afhankelijk van de fabrikant | Intel-tools |
| NVIDIA GeForce RTX 4090 | 24 GB GDDR6X | 1.008 GB/s | 450 W | CUDA |
| AMD Radeon RX 7900 XTX | 24 GB GDDR6 | 960 GB/s | 355 W (referentie) | ROCm |
| AMD Radeon PRO W7900 | 48 GB GDDR6 met ECC | 864 GB/s | 295 W | ROCm |
| NVIDIA RTX PRO 6000 Blackwell | 96 GB GDDR7 met ECC | 1.792 GB/s | 600 W, of 300 W (Max-Q) | CUDA |
| Intel Arc Pro B50 | 16 GB GDDR6 | 224 GB/s | 70 W, via het slot | Intel-tools |
Stap 1: het geheugen bepaalt de grens#
- Met 16 GB draai je modellen van 7B tot 14B op 4-bit.
- Met 24 GB draai je modellen uit de 30B-klasse op 4-bit (ongeveer 20 GB), met weinig ruimte over voor lange contexten.
- Met 32 GB draai je modellen uit de 30B-klasse ruim op 4-bit, en 14B-modellen op 8-bit.
- In 48 GB past een 70B-model op 4-bit net (ongeveer 42 GB).
- In 96 GB past een 70B-model op 8-bit (ongeveer 80 GB) of een model uit de 120B-klasse op 4-bit.
De volledige tabel staat in Hoeveel geheugen heb je nodig, en de modelgids zet elke kaart af tegen elke modelgrootte.
Stap 2: de software bepaalt hoeveel tijd je kwijt bent#
- CUDA (NVIDIA): nieuwe tools, papers en trainingscode ondersteunen dit als eerste. Noemt een tool een GPU-vereiste, dan gaat het meestal om CUDA.
- ROCm (AMD): PyTorch en llama.cpp ondersteunen het; sommige nichetools gaan nog uit van CUDA. Controleer of ROCm jouw kaart ondersteunt op jouw besturingssysteem.
- Intel: llama.cpp heeft SYCL- en Vulkan-backends die op Arc-kaarten draaien, en Intels OpenVINO-toolkit ondersteunt veel modellen. Controleer eerst de tools die je zelf gebruikt.
Stap 3: de bandbreedte bepaalt de snelheid#
Zodra een model past, hangt de snelheid van tekstgeneratie af van de geheugenbandbreedte. Bij een model dat op alle drie past, schrijft de RTX 5090 (1.792 GB/s) merkbaar sneller dan de R9700 (640 GB/s) of de B60 (456 GB/s). Of dat uitmaakt, hangt af van het werk: voor een chatassistent zijn ze allemaal snel genoeg om mee te lezen; bij lange batchtaken scheelt bandbreedte uren.

NVIDIA
NVIDIA GeForce RTX 5090
- 32 GB
- NVIDIA Blackwell (GB202)
Draait tot 30–34B op 4-bit
Met 32 GB draai je modellen van de 30B-klasse probleemloos op 4-bit, maar een 70B-model past niet op één kaart. Reken voor 70B op twee kaarten of een systeem met veel unified memory.
€ 1.999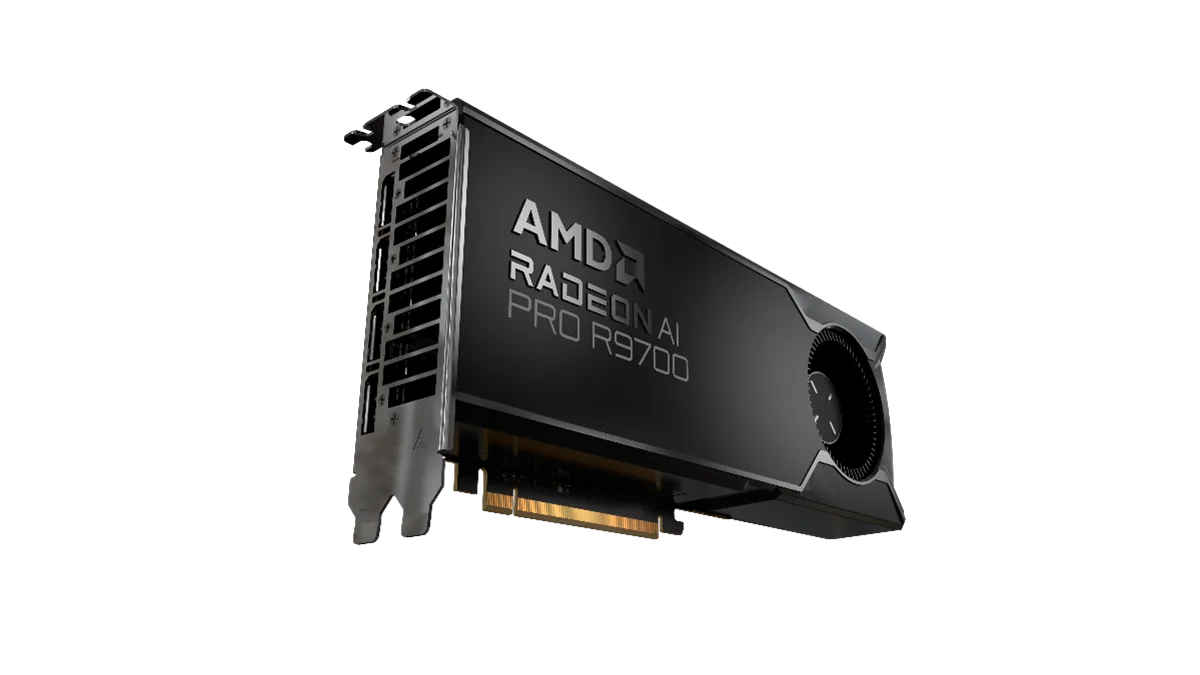
PowerColor
PowerColor AMD Radeon AI PRO R9700 32GB
- 32 GB
- AMD RDNA 4 (Navi 48)
Draait tot 30–34B op 4-bit
Controleer voor je koopt of je tools ROCm ondersteunen op je besturingssysteem. PyTorch en llama.cpp doen dat; sommige nichetools gaan nog uit van CUDA.
€ 1.299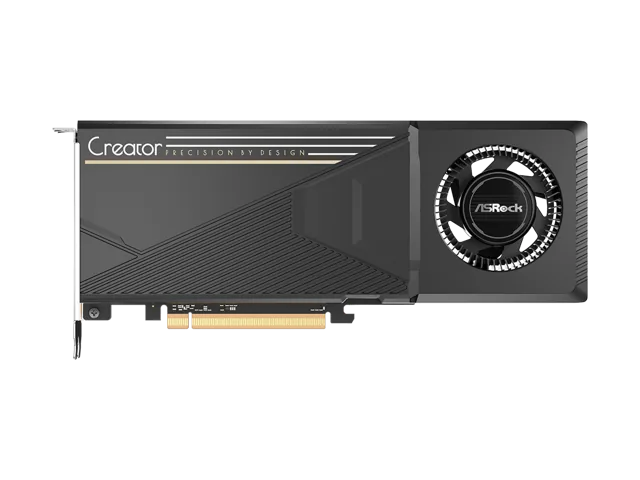
ASRock
ASRock Intel Arc Pro B60 Creator 24GB
- 24 GB
- Intel Xe2 (Battlemage)
Draait tot 30–34B op 4-bit
Dit is een kaart met één GPU en 24 GB. Hij gebruikt een PCIe 5.0-slot met x8-aansluiting en werkt ook in PCIe 4.0-slots. Controleer de specificaties van ASRock voor de exacte lengte en de voedingsaansluiting voordat je bestelt.
€ 599,99RTX 5090: de snelste, als je voeding het aankan#
De RTX 5090 is een van de snelste losse kaarten voor modellen die in 32 GB passen, en de snelste GeForce-kaart voor gamen in 4K. Hij verbruikt tot 575 W via een 16-pins 12V-2x6-connector, en NVIDIA adviseert een voeding van 1.000 W. Een 70B-model past niet op één kaart.
Radeon AI PRO R9700: 32 GB per kaart, zuinig per watt#
De R9700 is een RDNA 4-workstationkaart voor lokale AI. Hij heeft dezelfde 32 GB als de RTX 5090, bij 300 W, en is ontworpen om met meerdere exemplaren in één machine te draaien. Twee kaarten geven 64 GB, genoeg voor een 70B-model op 4-bit. De keerzijde: lagere bandbreedte en de ROCm-controle hierboven.
Intel Arc Pro B60: instappen in 24 GB#
De Arc Pro B60 is een Battlemage-kaart die door boardpartners wordt gebouwd, dus aansluitingen, koeling en verbruik (120 tot 200 W) verschillen per model. Hij gebruikt een PCIe 5.0 x8-interface. Sommige partners zetten twee B60-GPU's op één kaart, voor 48 GB in totaal; die dubbele kaarten hebben een moederbordslot nodig dat x8/x8-bifurcatie ondersteunt.
Wanneer kies je een kaart met 48 GB of 96 GB?#
De Radeon PRO W7900 heeft 48 GB ECC-geheugen en gecertificeerde workstationdrivers. Hij is geschikt voor grote scènes en zware videotijdlijnen, en voor modellen groter dan 32 GB. De RTX PRO 6000 heeft 96 GB ECC GDDR7, genoeg voor een 70B-model op 8-bit op één kaart. Kies de Max-Q-versie van 300 W met blowerkoeler om meerdere kaarten in één behuizing te plaatsen, en de versie van 600 W voor de snelste losse kaart.
Eén grote kaart of twee kleinere? Verdeel je een model over twee kaarten, dan tel je het geheugen op, maar de snelheid verdubbelt niet. Je hebt dan twee geschikte slots nodig, meer vermogen en meer luchtstroom. Laat het budget het toe, dan is één kaart eenvoudiger.
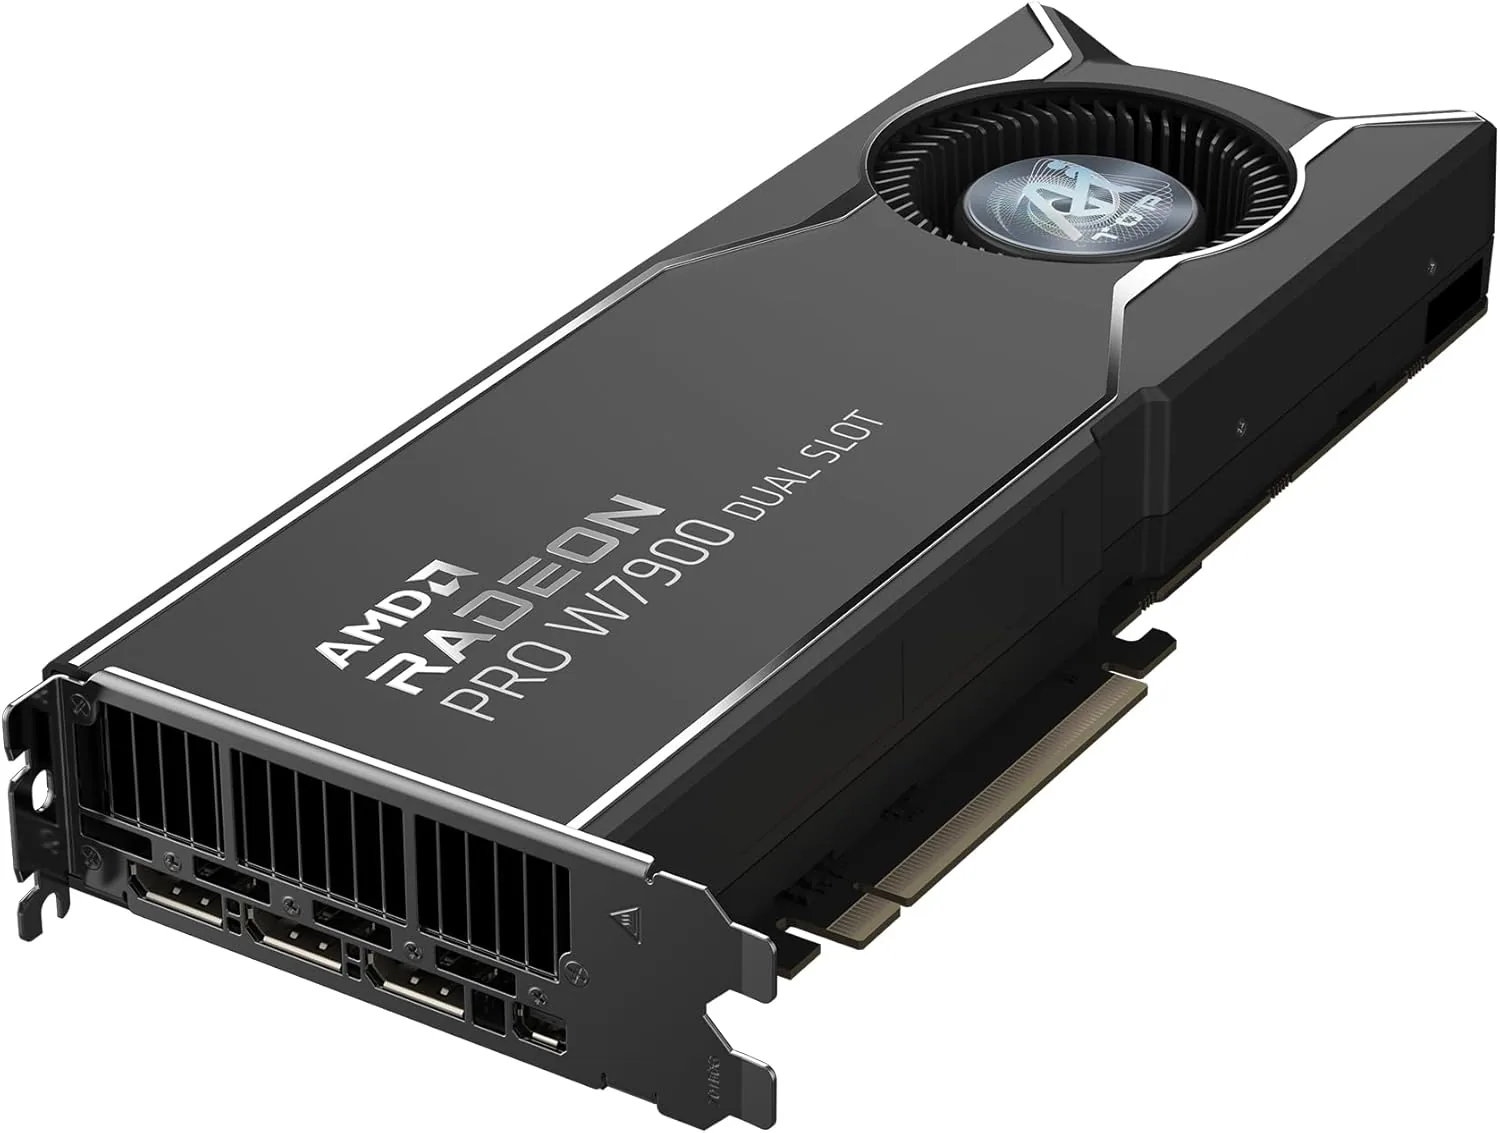
AMD
AMD Radeon PRO W7900 (48 GB)
- 48 GB
- AMD RDNA 3 (Navi 31)
Draait tot 70B op 4-bit
Kies de W7900 als de grootte van je model of scène het zwaarst weegt. De nieuwere R9700 heeft minder geheugen (32 GB), maar ondersteunt FP8 en is per watt sneller voor AI.
€ 3.592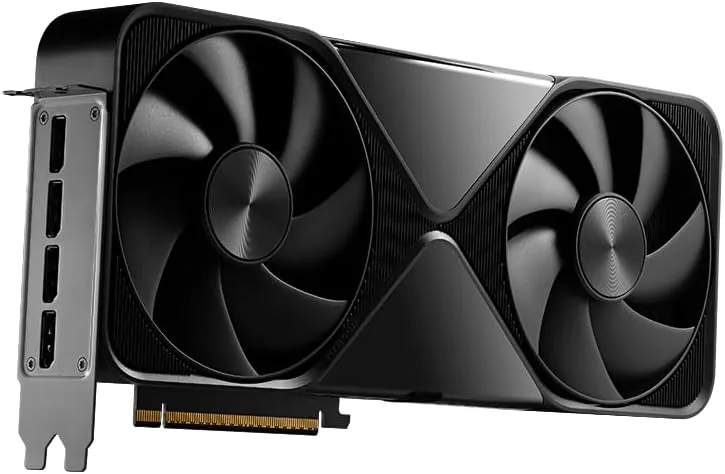
NVIDIA
NVIDIA RTX PRO 6000 Blackwell Workstation Edition (96 GB)
- 96 GB
- NVIDIA Blackwell (GB202)
Draait tot 120B+ op 4-bit
Dit is de Workstation Edition van 600 W met een dubbele flow-through-koeler. Je hebt een 16-pins stroomkabel nodig, een behuizing waarin een kaart van 12 inch past en een goede airflow.
€ 13.250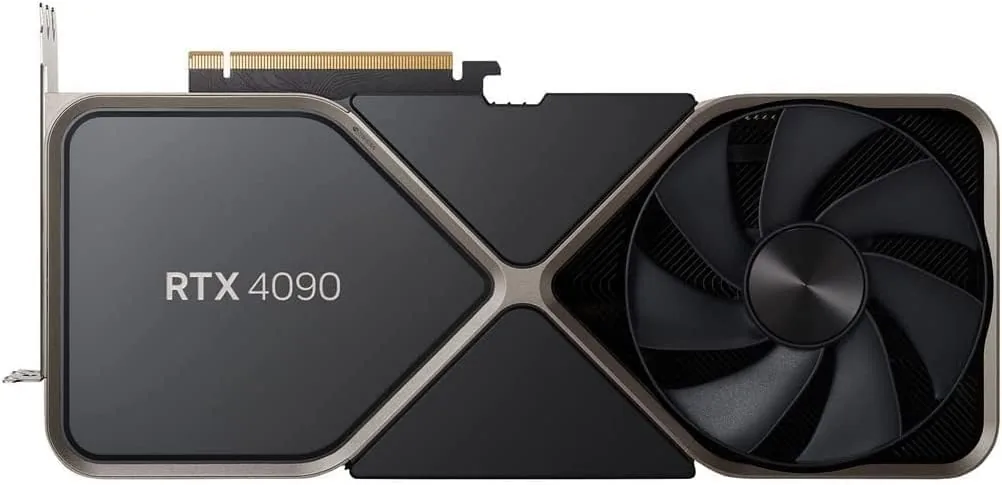
NVIDIA
NVIDIA GeForce RTX 4090
- 24 GB
- NVIDIA Ada Lovelace (AD102)
Draait tot 30–34B op 4-bit
Duw de 16-pins voedingskabel volledig in de kaart en vermijd scherpe bochten vlak bij de stekker. Een losse connector is de meest voorkomende oorzaak van problemen met deze kaart.
€ 1.599Voor gamers#
Stem de kaart af op je monitor. De RTX 5090 is gemaakt voor 4K met hoge framerates; de RTX 4090 en RX 7900 XTX blijven sterke 4K-kaarten met 24 GB. Op 1080p blijft het grootste deel van die rekenkracht onbenut.
Zijn je modellen 14B of kleiner, dan volstaat een goedkopere kaart. De low-profile Arc Pro B50 draait ze op 4-bit in 16 GB en heeft geen extra voedingskabel nodig.
Veelgestelde vragen
Is 24 GB genoeg voor lokale AI?
Voor modellen tot ongeveer 30B op 4-bit wel, met weinig ruimte voor lange contexten. Voor 70B heb je ongeveer 42 GB nodig: twee kaarten van 24 GB, een kaart van 48 GB of een machine met unified memory.
Is de RTX 4090 nog de moeite waard?
Het is een sterke kaart met 24 GB en 1.008 GB/s bandbreedte, voor wie topsnelheid wil zonder de stap naar de RTX 5090 te zetten. Hij heeft 8 GB minder geheugen dan de 5090 of de R9700.
Kan ik NVIDIA- en AMD-kaarten in één machine combineren?
Sommige tools kunnen met beide overweg, maar het maakt drivers en installatie ingewikkelder. Eén merk per machine is eenvoudiger.
Werkt een PCIe 5.0-kaart in een PCIe 4.0-slot?
Ja. De verbinding draait dan op de lagere snelheid. Staat een model volledig in het geheugen van de kaart, dan heeft de verbindingssnelheid vooral invloed op de laadtijd.
Producten bij dit onderwerp: Videokaarten · Hardware voor lokale AI
Gerelateerde gidsen
Videokaarten · 4 min lezen
High-end videokaart inbouwen: voeding, behuizing, koeling
Voordat je een high-end videokaart bestelt: wattage van de voeding, de 16-pinsconnector, formaat van de behuizing, PCIe-slots, luchtstroom en twee kaarten.
Lees de gids →Lokale AI · 5 min lezen
Hoeveel geheugen heb je nodig voor een lokaal LLM?
Hoeveel geheugen een lokaal LLM nodig heeft: 7B- tot 120B+-modellen op 4-bit en 8-bit, unified memory vs. VRAM, en welke machines welke grootte aankunnen.
Lees de gids →Lokale AI · 5 min lezen
Mac, NVIDIA of Ryzen AI Max+ voor lokale AI
Mac, NVIDIA of Ryzen AI Max+? CUDA op NVIDIA, unified memory op een Mac of 128 GB in een mini-pc. Geheugen, software en afwegingen per soort werk.
Lees de gids →